Chương 2 · Kiến trúc Model
Theo dấu một token từ biểu diễn số đến điểm số token kế tiếp: đồ thị tính toán, forward pass, attention, feedforward — rồi đo lường dung lượng, FLOPs và khối lượng đọc/ghi cho prefill, decode và các cơ chế trạng thái như KV share, MLA, sparse MoE.
~110 phút đọc · Thuật ngữ
Kiến trúc Model
Chương 1 đã phân tích một lần thực thi model duy nhất theo ba chiều — dung lượng lưu trữ, độ phức tạp tính toán và khối lượng truy cập dữ liệu — và dùng các chỉ số phần cứng then chốt để ước tính cận dưới của thời gian thực thi. Cách ước tính như vậy nhanh chóng loại bỏ được một số thiết kế, nhưng vẫn để ngỏ một câu hỏi: các số liệu tính toán và lượng dữ liệu được đưa vào đó thực sự đến từ đâu? “Một model 8B” (hậu tố B trên số tham số biểu thị billions, tức hàng tỷ, nên 8B nghĩa là khoảng 8 tỷ tham số) chỉ cho ta biết bậc độ lớn thô của số lượng tham số. Nó không nói gì về việc mỗi token dùng tham số nào, ngữ cảnh được lưu ở đâu, hay các phần công việc khác nhau liên hệ với nhau ra sao theo trình tự.
Chương này bắt đầu từ biểu diễn số của một token duy nhất và lần theo, từng bước, cách nó đi qua các layer của mạng để tạo ra điểm số cho token kế tiếp, rồi tính dung lượng lưu trữ , độ phức tạp tính toán và khối lượng đọc/ghi cần cho quá trình này. Một đồ thị tính toán (computation graph) biểu diễn các phép toán dưới dạng node và dữ liệu truyền giữa các phép toán dưới dạng edge. Chỉ khi hiểu được các phép toán và dữ liệu trong đồ thị này, ta mới biết mỗi con số trong một ngân sách tài nguyên đến từ đâu.
Đồ thị tính toán này cũng cung cấp thông tin cần để tối ưu hóa cách cài đặt. Weight nào giữ nguyên qua các request khác nhau, trạng thái nào được các bước sinh kế tiếp tái sử dụng, và kết quả nào chỉ được vận hành ngay sau đó tiêu thụ — tất cả đều đọc được từ cấu trúc của model. Các chương sau, khi thiết kế lưu trữ, biên dịch và lập lịch, sẽ khai thác những khác biệt về cách sử dụng dữ liệu này để quyết định thứ gì có thể dùng chung, thứ gì cần giữ lâu dài, và thứ gì chỉ cần giữ tạm.
Chương này chọn năm model đại diện: DeepSeek V4.1 Flash, Qwen3-8B, Qwen3.6-35B-A3B (trong tên này, 35B chỉ khoảng 35 tỷ tổng tham số, và A3B nghĩa là khoảng 3 tỷ tham số thực sự được kích hoạt mỗi token; từ đây viết tắt là Qwen3.6), DeepSeek V4-Flash và Kimi K3. V4.1 Flash, phát hành tháng 9 năm 2026, dùng kiến trúc CED để tách xử lý đầu vào khỏi quá trình sinh, và kết hợp KV sharing giữa các layer (cross-layer KV sharing), phân cấp chỉ mục (hierarchical indexing), cùng Engram (một module tra cứu một n-gram — một đoạn gồm n token liên tiếp — trong một bảng để thu được biểu diễn bổ sung). Đây là một case study mới để hiểu cách kiến trúc model định hình lại các yêu cầu của hệ thống.
Suy dẫn bắt đầu với Qwen3-8B: nó có khoảng 8,19 tỷ tham số và xử lý văn bản qua 36 layer mạng. Sau khi hiểu quá trình thực thi của model dense này, ta sẽ lần lượt thay đổi cách ngữ cảnh được giữ, bộ tham số nào mỗi token dùng, và các layer được kết nối ra sao, trước khi cuối cùng so sánh cả năm model dưới cùng điều kiện đầu vào.
Trước khi bắt đầu suy dẫn, hãy thống nhất quy ước đếm của chương này. Khi tính độ phức tạp tính toán, một phép nhân cộng một phép cộng được coi là 2 FLOPs. Lưu trữ đo bằng GB và GiB: , . BF16 dùng 2 byte mỗi phần tử, nên nhân số phần tử của một tensor với 2 sẽ ra kích thước lưu trữ của nó.
2.1 Đồ thị tính toán và thực thi forward pass
Một tensor là một mảng số sắp xếp theo một hay nhiều chiều: vector có một chiều, ma trận có hai chiều. Một model biểu diễn đặc trưng của mỗi token dưới dạng vector, và xếp các vector của nhiều token thành các hàng của một ma trận. Hiểu nhu cầu tài nguyên của một model bắt đầu từ việc tách node tính toán khỏi phụ thuộc dữ liệu. Một node thực hiện phép nhân ma trận hoặc một số biến đổi khác, và một edge chỉ rằng node phía sau cần kết quả của node phía trước. Số lượng phép toán của một node quyết định nhu cầu tính toán, tensor trên một edge quyết định lượng dữ liệu được truyền đi, và chiều của edge chỉ ra phép toán nào phải thực thi trước phép toán nào. Hiểu quá trình thực thi của một model cần xem xét cả ba khía cạnh này cùng nhau.
Đồ thị tính toán trong chương này trước tiên mô tả các phép toán toán học và phụ thuộc dữ liệu. Trong lúc thực thi thực tế, framework giao các phép toán này cho các chương trình trên accelerator; một phép toán có thể bị tách thành nhiều chương trình, và nhiều phép toán có thể được hợp nhất (fuse) thành một. Một edge biểu diễn tensor trong đồ thị tính toán chỉ chỉ ra phép toán phía sau cần dữ liệu này — không ngụ ý rằng dữ liệu phải được sao chép giữa CPU và GPU. Chương 4 giải thích dữ liệu nằm ở đâu, và chương 5 giải thích chương trình được gửi đi thế nào và dữ liệu vào ra như thế nào.
2.1.1 Phụ thuộc tuần tự và đồ thị tính toán nhân quả
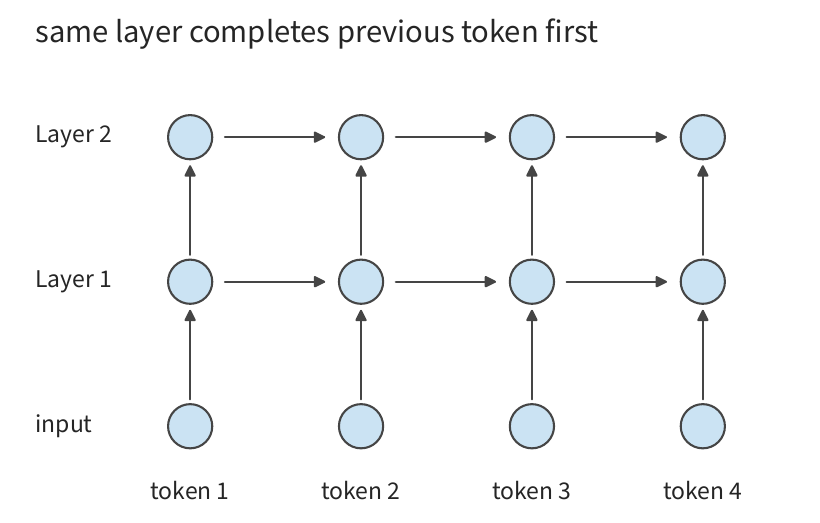
Để tính thời gian thực thi, trước tiên ta cần biết phép toán nào có thể bắt đầu cùng lúc. Xét bốn token và ba layer mạng, với trục ngang biểu diễn chỉ số vị trí của token trong chuỗi và trục dọc biểu diễn layer. Trong chương này, “mục từ vựng” (vocabulary entry) chỉ một mục trong từ vựng, còn “token” chỉ một lần xuất hiện của nó trong chuỗi; khi cùng một mục từ vựng xuất hiện nhiều lần trong chuỗi, chỉ số vị trí phân biệt những lần xuất hiện này. Mạng nơ-ron tuần tự (RNN — Recurrent Neural Network) truyền trạng thái từ vị trí token trước sang vị trí kế tiếp, thỏa mãn . Ở đây là đầu vào hiện tại, là trạng thái được giữ lại sau khi xử lý đến vị trí token hiện tại, và là biến đổi thực hiện bằng weight của model. Kết quả hiện tại phụ thuộc vào vị trí token trước, nên cùng một layer thực thi nghiêm ngặt theo thứ tự vị trí. Ngay cả khi cả bốn đầu vào đã đến nơi, token thứ vẫn phải đợi token thứ .
Transformer dùng cơ chế attention (cơ chế tập trung) để một token đọc thông tin từ các vị trí khác; “nhân quả” (causal) nghĩa là vị trí token hiện tại chỉ được dùng thông tin của chính nó và các vị trí trước nó. Cấu trúc phụ thuộc của một Transformer nhân quả khác đi. Khi tính một vị trí cho trước tại layer , attention đọc biểu diễn của vị trí đó và của tất cả các vị trí token trước nó từ layer trước. Miễn là đầu vào token đã biết và biểu diễn tương ứng từ layer trước đã hoàn tất, tính toán tại các vị trí khác nhau trong cùng một layer không còn cần đợi output của token trước trong layer đó. Causal mask (mặt nạ quan hệ nhân quả) chỉ định mỗi vị trí token được phép truy cập thông tin gì, chặn thông tin từ các vị trí token phía sau. Sắp theo truy vấn (query) và vị trí token được truy vấn, mask tạo thành một tam giác; mask giới hạn thông tin có thể đến từ đâu, nhưng không yêu cầu phải thực thi từng token đã biết một lượt một. Phụ thuộc theo chiều sâu mạng vẫn giữ nguyên: layer kế tiếp dùng kết quả của layer này.
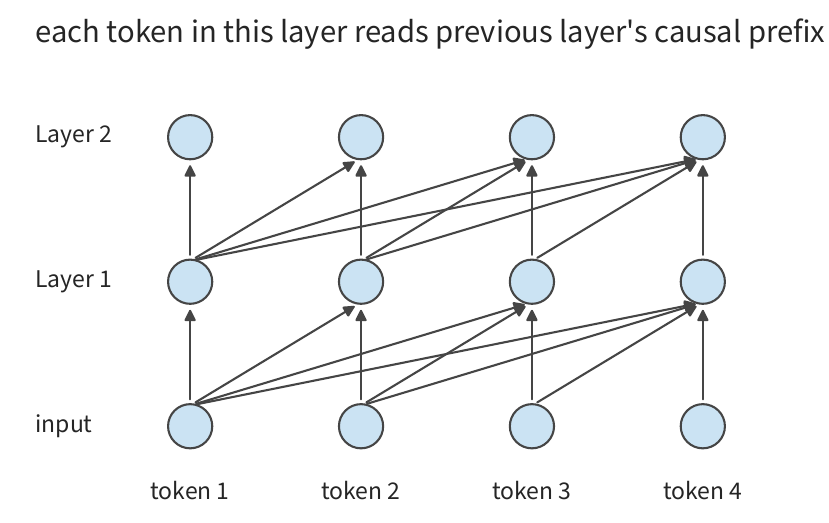
Theo dấu các mũi tên trong hình sẽ thấy hai kiểu đợi khác nhau: RNN đợi vị trí token trước trong cùng layer, trong khi Transformer nhân quả đợi kết quả cần thiết từ layer trước. Việc đầu vào đã biết có thể được xử lý song song hay không phụ thuộc vào những phụ thuộc này, chứ không phụ thuộc vào nhãn “tuần tự”. Sinh thêm một token lại tạo thêm một phụ thuộc nữa: đầu vào của lần gọi kế tiếp được xác định bởi output của lần gọi này.
Xử lý đầu vào đã biết và sinh từng bước là hai loại công việc khác nhau. Một encoder chuyển các đầu vào đã biết thành biểu diễn, trong khi một decoder tạo output từng bước dựa trên thông tin mà nó được phép truy cập. Các model ngôn ngữ nhân quả hiện đại thường dùng cấu trúc chỉ-decoder (decoder-only); chương này trước tiên xây nền tảng trên cấu trúc này, rồi bàn về cách V4.1 Flash phân chia lại công việc xử lý đầu vào và sinh token qua kiến trúc CED. Khi xử lý đầu vào đã biết, các vị trí token trong cùng layer có thể tiến hành song song; trong lúc sinh, đầu vào kế tiếp chỉ được xác định khi output đầu tiên đã cố định. Do đó xử lý đầu vào tiến dọc theo chiều sâu mạng, còn quá trình sinh lại thêm một phụ thuộc tuần tự giữa các lần gọi.
Bài tập 2-1 [Mở rộng]: Phụ thuộc của RNN và Transformer hạn chế tính toán song song thế nào
Với một chuỗi bốn đầu vào token đã biết, vẽ đồ thị phụ thuộc tính toán của một RNN ba layer và một Transformer nhân quả ba layer. Sau đó thêm một vị trí output cần sinh, và xác định node nào phải hoàn tất trước khi vị trí đó có thể được tính. Giả sử tính toán mỗi token của mỗi layer mất một đơn vị thời gian và tài nguyên song song không bị giới hạn, tìm chuỗi phụ thuộc dài nhất khi xử lý tất cả đầu vào đã biết cho mỗi trường hợp; giải thích những chỗ đợi nào có thể rút ngắn bằng cách thêm nhiều đơn vị tính toán hơn, và chỗ đợi nào không thể.
2.1.2 Cấu hình model và cấu trúc tensor
Hãy trước tiên mở rộng một node tính toán đơn lẻ. Giả sử phép chiếu này áp dụng cho đầu vào token, mỗi token được biểu diễn bằng một vector có đặc trưng. Xếp các vector này theo hàng, ta được ma trận đầu vào với hàng và cột. Với chiều rộng đầu ra là , ta có:
Mỗi phần tử đầu ra là một tích vô hướng (dot product) chiều dài , và tổng cộng có phần tử đầu ra, nên
là số tham số weight, và là số byte mỗi tham số. Nhân đôi số hàng sẽ nhân đôi độ phức tạp tính toán trong khi kích thước weight không đổi; nhân đôi chiều rộng đầu ra sẽ nhân đôi cả số lượng weight lẫn độ phức tạp tính toán. Hai thay đổi này tương ứng với “cùng một model xử lý nhiều đầu vào hơn” và “một layer của model trở nên rộng hơn”. Các bảng model dưới đây đều có thể được tính từng hàng theo quy tắc này.
Hãy nhìn trước một đường dữ liệu đơn lẻ trong Qwen3-8B. Một forward pass là quá trình tính từ đầu vào đến đầu ra bằng weight hiện tại; vector ẩn (hidden vector) là biểu diễn đặc trưng được truyền bên trong mạng, và chiều của nó là số giá trị trong vector của mỗi token. Mạng feedforward (FFN — Feedforward Network) áp dụng một biến đổi đặc trưng cho từng token độc lập; attention chọn và tổng hợp thông tin giữa các token. Hai loại phép toán này xen kẽ tạo thành một layer của mạng.
Qwen3-8B có layer, chiều ẩn , và chiều trung gian FFN ; attention chia đặc trưng thành nhiều nhóm và thiết lập quan hệ giữa các token riêng trong mỗi nhóm, mỗi nhóm gọi là một head. Có 32 query head và 8 head dùng cho KV, mỗi cái chiều 128; mục 2.1.3 sẽ giải thích chúng theo đường query, key và value. Từ vựng chứa 151.936 token; word embedding (nhúng từ) là một bảng tra cứu ánh xạ một token ID thành một vector, và output head chuyển vector lớp cuối cùng thành điểm số cho từng token ứng viên. Mỗi cái giữ bộ weight riêng. Cộng các tham số theo layer này vào hai ma trận từ vựng, model có tổng cộng khoảng 8,19 tỷ tham số.
Một forward pass bắt đầu từ các token ID. Word embedding tra cứu một vector 4096 chiều cho mỗi ID, và vector đó đi qua lần lượt 36 layer attention và FFN, trước khi cuối cùng đi qua chuẩn hóa (normalization) và một phép chiếu từ vựng để tạo ra logits — điểm số của các token ứng viên chưa được chuyển thành xác suất. Chuẩn hóa giữ các giá trị tính theo từng layer nằm trong khoảng số học phù hợp. Word embedding chọn một hàng theo ID, lấy ra mỗi token một vector, trong khi toàn bộ bảng từ vựng là dữ liệu thường trú được các token khác nhau truy vấn. Output head nhân vector ẩn với ma trận từ vựng; khi chỉ sinh token kế tiếp, thường chỉ cần logits của đầu vào token cuối cùng.
Giả sử request bằng độ dài được xử lý đồng thời, mỗi request đóng góp token đã biết làm đầu vào của lần gọi này. Đầu vào của các phép chiếu và FFN có thể viết là , trong đó mỗi hàng là biểu diễn của một token tại layer hiện tại, tổng cộng hàng. Key và value của các token ngữ cảnh hiện có được đọc từ cache và không được tính vào này. Khi mỗi request chỉ đóng góp một token mới, . Trường hợp đầu tiên có xu hướng tạo thành một ma trận với số hàng lớn, trong khi trường hợp thứ hai, ở batch size nhỏ, gần với một phép nhân ma trận–vector. Weight là một bộ, nhưng hình dạng đầu vào khác biệt đáng kể.
Dưới đây ta so sánh hai hình dạng đầu vào: một request duy nhất xử lý 8192 token đầu vào trong một lần gọi, và một request duy nhất đã có 8192 token ngữ cảnh chỉ xử lý một token mới. Gọi là số request, là độ dài ngữ cảnh đã tích lũy trước lần gọi này, là độ dài đầu vào của lần gọi này, và là chiều ẩn. Trường hợp trước dùng ; trường hợp sau dùng .
| Mục cấu hình | Tham số Qwen3-8B | Ảnh hưởng trực tiếp đến nhu cầu tài nguyên |
|---|---|---|
| Số layer | 36 | Tính toán lặp lại, trạng thái theo layer, và phụ thuộc chiều sâu |
| Chiều ẩn | 4096 | Đầu vào/đầu ra sub-layer và kích thước projection |
| Chiều trung gian FFN | 12288 | Weight và tính toán của ba ma trận FFN |
| Số head /KV | 32/8 | Chiều rộng vector query và biểu diễn ngữ cảnh |
| Chiều head | 128 | Tích vô hướng và chiều rộng trạng thái mỗi head |
| Kích thước từ vựng | 151936 | Kích thước embedding và output head |
Ví dụ làm việc 2-1: Suy ra số tham số theo layer và độ phức tạp tính toán từ kích thước ma trận. Trong Qwen3-8B, chiều rộng của query projection và output projection là 4096, chiều rộng của key projection và value projection là 1024, và chiều trung gian FFN là 12288. Tìm số tham số của bốn projection attention và ba ma trận FFN, cùng độ phức tạp tính toán cần để hoàn thành các phép chiếu này và phép tính FFN cho token đầu vào của lần gọi này. Mỗi token có một vector 4096 chiều tại layer này, tạo thành một hàng của ma trận đầu vào; đếm các token thực sự tham gia phép tính này. Nếu cùng một mục từ vựng xuất hiện hai lần, nó được đếm là hai token. Với request bằng độ dài, mỗi request xử lý token trong lần gọi này, ta có . Ví dụ, một request duy nhất xử lý 128 token đầu vào cho ; tám request mỗi cái tiến thêm một token cho .
Giải: Query projection và output projection mỗi cái dùng ma trận , key projection và value projection mỗi cái dùng ma trận , và ba ma trận FFN mỗi cái có tham số . Do đó,
Đoạn này chưa dùng đến độ dài ngữ cảnh: những phép chiếu này áp dụng cùng một biến đổi cho vector đặc trưng của từng token. Mục tiếp theo giới thiệu tính toán attention giữa query và ngữ cảnh, độ phức tạp của nó liên quan đến số cặp query-key. Tách hai loại công việc này làm rõ tại sao “tăng số token tham gia lần gọi này” và “để mỗi token đọc một ngữ cảnh dài hơn” lại mang những chi phí khác nhau.
| Ký hiệu | Ý nghĩa và phạm vi |
|---|---|
| Số request, số đầu vào token mỗi request trong lần gọi này, độ dài ngữ cảnh hiện có | |
| Tổng số token tham gia các phép chiếu trong lần gọi này, tức số hàng của ma trận đầu vào; trong decode thường lệ , nên | |
| Chiều rộng ẩn chính, chiều rộng trung gian của mạng feedforward | |
| Số query head, số KV head, chiều mỗi head | |
| Tổng số cặp query-key nhân quả hiệu lực mỗi layer trên tất cả request, không kể số head | |
| Số token được định tuyến đến chuyên gia (xem mục 2.4); vector đặc trưng của mỗi token chiếm một hàng của ma trận đầu vào của chuyên gia đó; là số chuyên gia được chọn cho mỗi token, và khi các token được định tuyến đến một chuyên gia không bị loại bỏ trong lúc định tuyến, | |
| Số token mà phép chiếu từ vựng thực sự được thực thi; khi chỉ token cuối cùng của mỗi request dự đoán token kế tiếp, đại lượng này bằng , không bằng tổng độ dài output đã sinh |
Để tính nhu cầu tài nguyên của toàn model, trước tiên tính độ phức tạp tính toán của một lần gọi bằng kích thước ma trận của từng phép toán trong bảng, rồi nhân với số layer của loại phép toán đó. Output head được tính riêng dựa trên số token đầu ra thực tế ; khi sinh token kế tiếp, mỗi request chỉ cần điểm số của token cuối cùng. Chuẩn hóa, activation và các phép tra cứu mỗi cái có mẫu tính toán riêng, sẽ được giải thích riêng sau theo dòng dữ liệu.
2.1.3 Tính toán attention và mã hóa vị trí
Hãy trước tiên lần theo tính toán cho một token duy nhất. Model tạo ra ba biểu diễn từ vector ẩn của token này: query biểu thị “cần thông tin gì ngay bây giờ”; key dùng để tính điểm so khớp với các query; và value là thông tin được tổng hợp vào output một khi đã được chọn. Cả ba đều được tạo ra từ đầu vào của cùng một token qua những ma trận weight khác nhau. Chiếu tuyến tính (linear projection) chính là phép nhân ma trận như vậy: biến đổi đặc trưng đầu vào thành một tập tọa độ khác.
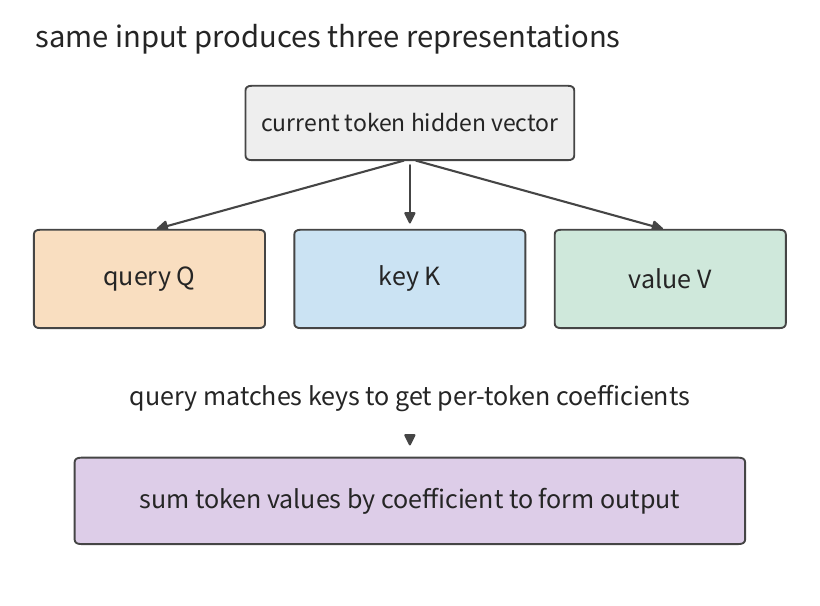
Dùng ký hiệu nhân phải của toán học, đầu vào được nhân lần lượt với ba ma trận weight, cho ra , , . Tổng chiều rộng của là , trong khi và mỗi cái có tổng chiều rộng . Do đó là , còn và mỗi cái là . Các linear layer trong code thường lưu weight dưới dạng ; sau khi chuyển sang ký hiệu nhân phải của toán học, chiều rộng đầu vào đứng trước và chiều rộng đầu ra đứng sau, giúp ta so từng cột với bảng dưới đây.
Các phép chiếu trên tạo ra , , , nhưng vị trí token hiện tại chưa trao đổi thông tin với ngữ cảnh. Tiếp theo, được chia thành 32 head, còn , được chia thành 8 head. Bốn head dùng chung một KV head. Với một head, vector query lấy tích vô hướng với của các vị trí được phép truy cập, tích vô hướng được chia cho căn bậc hai của chiều rộng head để tránh thang số của điểm số tăng quá nhiều theo chiều rộng head, rồi các vị trí token tương lai bị mask. Softmax biến các điểm số tại những vị trí được phép thành các giá trị dương và được chuẩn hóa, với hệ số ; các hệ số này cộng lại bằng một và xác định mỗi token ngữ cảnh đóng góp bao nhiêu. “Attention weight” ở đây chỉ hệ số được tính từ đầu vào của lần gọi này, khác với các tham số model được lưu sau huấn luyện. Các trọng số này sau đó dùng để tính một tổng có trọng số trên . Kết quả từ mỗi head được nối lại và đi qua một output projection để quay về vector ẩn.
Viết tính toán cho một head dưới dạng ma trận:
là các trọng số của từng query trên các token ngữ cảnh, là causal mask, và là chiều head. Tích vô hướng xác định những vị trí nào liên quan đến query hiện tại, Softmax biến điểm số thành hệ số trọng số, và những hệ số này sau đó tổng hợp các vector value. Trước khi lấy tích vô hướng, Qwen3 cũng thực hiện chuẩn hóa query và key (QK Norm) và RoPE (Rotary Position Embedding — nhúng vị trí xoay): cái trước điều chỉnh thang số của query và key theo từng head, còn cái sau, qua một phép xoay phụ thuộc vị trí, làm cho tích vô hướng mang thông tin vị trí tương đối.
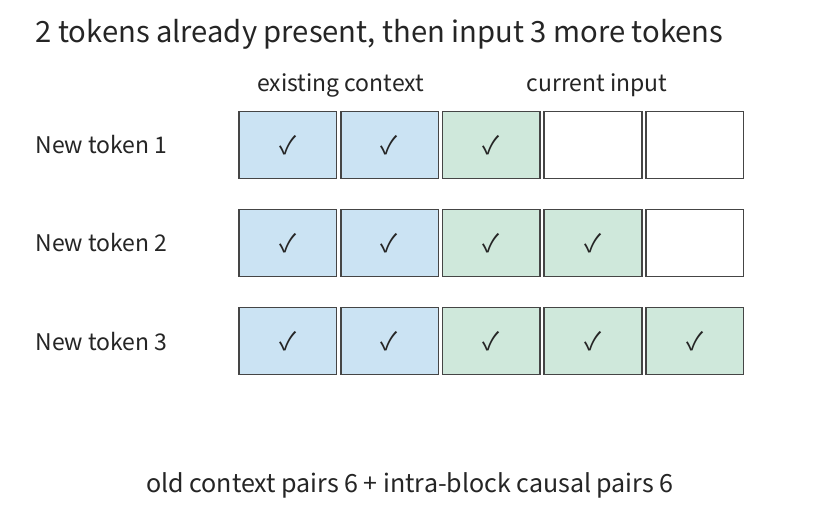
Giờ hãy đếm các tích vô hướng. Với token đầu vào mới và token ngữ cảnh hiện có, token mới thứ có thể truy cập token, với . Cộng dồn số token ngữ cảnh mà mỗi query có thể truy cập, ta được một hình chữ nhật cộng một tam giác:
Với mỗi cặp query–token ngữ cảnh, phép tích vô hướng của một head mất xấp xỉ FLOPs, và phần đóng góp kế tiếp vào mất thêm xấp xỉ FLOPs. Cộng trên tất cả head, độ phức tạp ma trận hiệu lực của và là:
Trong prefill, khi ngữ cảnh chưa được cache, nhân đôi độ dài chuỗi làm số hàng đầu vào của projection tăng gấp đôi, trong khi số cặp query-key của full attention tăng xấp xỉ bốn lần, vì các token mới thêm vào cũng phải tương tác với ngữ cảnh hiện có. Có hai cách phổ biến để tính những cặp query-key này: phép nhân ma trận hình chữ nhật đầy đủ trước tiên tạo ra tất cả các điểm số rồi mask tam giác trên, còn causal chunking bỏ qua hoàn toàn tam giác trên. Chunking cũng có thể hợp nhất việc chấm điểm, chuẩn hóa và tổng hợp lại với nhau, để điểm số được giải phóng khỏi bộ nhớ trên chip ngay khi vừa được dùng. Chương 5 sẽ theo dòng dữ liệu này để giải thích cách giảm đọc/ghi bộ nhớ trên chip cho các kết quả trung gian.
Do đó, giữ cố định chỉ giữ số hàng của projection cố định — chứ không giữ sự tương tác ngữ cảnh cố định. Ví dụ, chia một đầu vào dài thành hai đầu vào ngắn độc lập sẽ loại bỏ những cặp query-key vốn vượt qua ranh giới giữa hai đầu vào. Ngược lại, chỉ thêm ngữ cảnh phía trước cùng một request sẽ tăng số tích vô hướng cho mỗi token mới, trong khi số hàng trong projection đầu vào vẫn không đổi.
2.1.4 Mạng feedforward và độ phức tạp tính toán forward
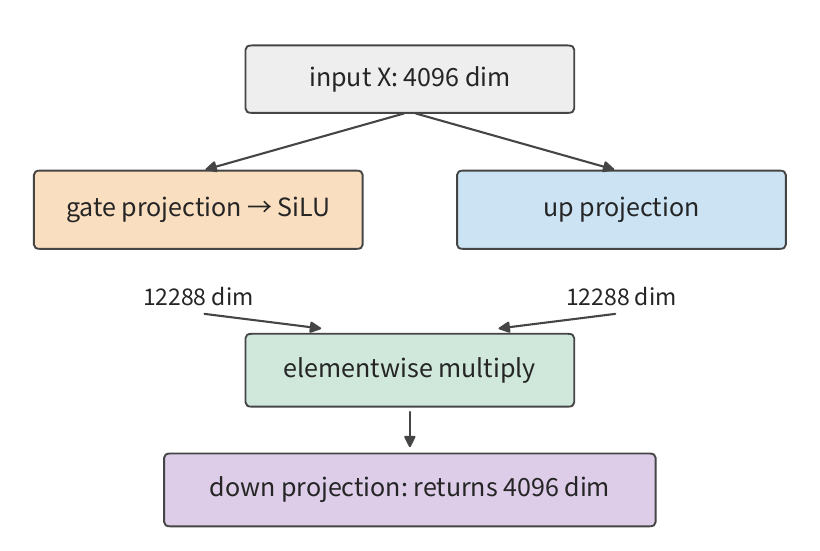
Attention xử lý việc trao đổi thông tin giữa các token, trong khi FFN thực hiện một biến đổi phi tuyến trên đặc trưng của từng token một cách độc lập. SwiGLU là một cấu trúc feedforward có cổng (gated): một nhánh biến đổi đặc trưng đầu vào, còn nhánh kia tạo ra một tín hiệu điều biến theo từng phần tử cho nó. SwiGLU dùng hàm kích hoạt SiLU , áp dụng một biến đổi phi tuyến để thay đổi cách các đặc trưng kết hợp với nhau. Qwen3-8B dùng cấu trúc này: đầu vào đi qua hai nhánh chiếu lên, gate và up; nhánh gate đi qua SiLU rồi được nhân theo từng phần tử với nhánh up, và cuối cùng một phép chiếu xuống đưa nó về chiều ẩn:
Ở đây biểu thị phép nhân theo từng phần tử; gate là nhánh cổng, up là nhánh chiếu lên, và down là nhánh chiếu xuống. Các vector trung gian do cả ba tạo ra đều được gọi là activations. gate và up mỗi cái nâng mỗi hàng từ chiều lên chiều, còn down đưa nó trở lại chiều. Ba ma trận cùng nhau do đó có tham số, và việc xử lý vector đặc trưng của token cần FLOPs. Qwen3-8B lấy ; FFN có khoảng 151 triệu tham số, và weight BF16 của nó chiếm 288 MiB. Các activation rộng hơn sau phép chiếu up cũng cần không gian tạm, nhưng chỉ trong thời gian của phép tính đó.
So sánh hai loại phép chiếu: các projection QKV và output của attention cộng lại có khoảng 41,94 triệu tham số. Cộng thêm khoảng 151 triệu tham số của FFN, FFN chiếm khoảng 78% trong số các tham số projection chính này, nên trong tính toán ngữ cảnh ngắn, ba ma trận FFN chiếm một tỷ trọng đáng kể. Khi đầu vào dài dần, độ phức tạp tính toán của FFN tăng tuyến tính theo số token, trong khi độ phức tạp của full attention tăng theo . Hai thứ tăng với tốc độ khác nhau, nên tỷ trọng tính toán giữa các thành phần này dịch chuyển khi độ dài ngữ cảnh thay đổi.
Ngoài các biến đổi ma trận, còn có những kết nối giữa các sub-layer trong một layer. Kết nối dư (residual connection) giữ lại đầu vào của sub-layer và, sau khi biến đổi của sub-layer hoàn tất, cộng nó theo từng phần tử vào output. Một đường do đó thực hiện một biến đổi mới, còn đường kia trực tiếp chuyển tiếp biểu diễn hiện có. Dưới đây, ta lắp ráp attention, feedforward và hai kết nối dư thành một layer hoàn chỉnh.
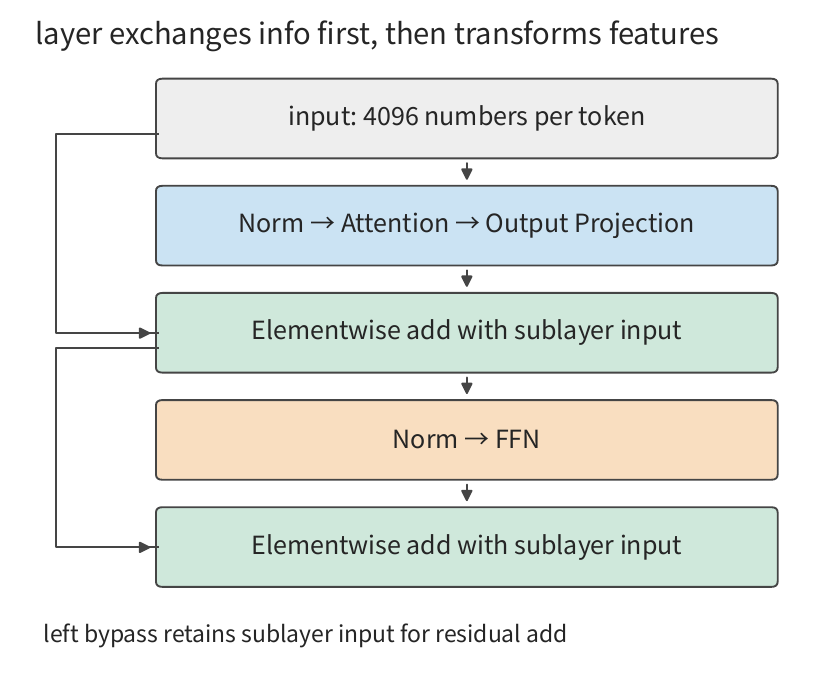
Bảng 2-1 Các module theo layer và giao diện đầu ra của Qwen3-8B
Hàng attention và hàng feedforward được cộng dồn trên 36 layer chính; word embedding đọc hàng tương ứng từ bảng từ vựng theo token ID, và không được tính như một phép nhân ma trận từ vựng (GEMM — General Matrix Multiplication). và của attention mỗi cái chỉ có 1024 chiều, trong khi query vẫn có 4096.
Đầu vào model
| Module và vai trò | Đầu vào → đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Tra cứu hàng word embedding | ID → | Bảng tra cứu | 0; truy cập hàng tính riêng | 1 |
Attention
| Module và vai trò | Đầu vào → đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Projection : tạo query | 36 | |||
| Projection , : tạo ngữ cảnh tái sử dụng được | , tổng 2 | 36 | ||
| và : tổng hợp ngữ cảnh theo nội dung | query head, mỗi head chiều | Không có weight projection mới | 36 |
| Output projection: hợp nhất các head | | | | 36 |
Feedforward và các kết nối
| Module và vai trò | Đầu vào → đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| SwiGLU: biến đổi đặc trưng theo từng token | Hai ma trận ; một ma trận | 36 | ||
| Chuẩn hóa, RoPE, activation và kết nối dư | Giữ nguyên hoặc áp dụng biến đổi theo từng phần tử lên các tensor trên | Vector chuẩn hóa, v.v. | Tính theo từng phần tử | 36 |
Giao diện đầu ra
| Module và vai trò | Đầu vào → đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Output head từ vựng: chuyển thành điểm số token (một lần, ở cuối toàn model) | 1 |
Bảng cho thấy hai kiểu tăng trưởng: công việc của các projection và FFN tăng theo , trong khi tương tác ngữ cảnh tăng theo . Ba phép chiếu lớn của FFN giải thích tại sao nó chiếm tỷ trọng tính toán cao trong ngữ cảnh ngắn; khi ngữ cảnh dài dần, tỷ trọng do tương tác ngữ cảnh chiếm tăng dần.
Cộng các biến đổi tuyến tính và tương tác ngữ cảnh của từng layer, rồi cộng output head, ta được độ phức tạp ma trận chính của Qwen3-8B:
Thuật ngữ đầu tiên tăng theo số hàng đầu vào, thuật ngữ thứ hai tăng theo số cặp query-key, và thuật ngữ cuối tăng theo số token thực sự trải qua phép chiếu từ vựng. Với đầu vào chứa 8192 token, attention được tính trên các cặp query-key nhân quả hiệu lực và output head chỉ xử lý token cuối cùng, tổng cộng là 133,6 TFLOPs; với 8192 token ngữ cảnh hiện có cộng một token thêm, tổng cộng là 20,0 GFLOPs.
Prefill xử lý đồng thời 8192 đầu vào token, và mọi token đều đi qua các projection và FFN. Decode chỉ thực hiện những phép toán này cho token mới, trong khi , của các token cũ được đọc từ cache. Cache do đó loại bỏ việc tính lại các projection và FFN cho token cũ, nhưng tính toán attention giữa query hiện tại với ngữ cảnh vẫn phải chạy. Mục tiếp theo tính dung lượng và khối lượng truy cập của cache này.
Bài tập 2-2 [Cốt lõi]: Cùng số hàng đầu vào, tại sao độ phức tạp tính toán attention lại khác nhau
Dùng Bảng 2-1, lấy và tính số FLOPs cho các projection và FFN, cho attention nhân quả hiệu lực, và cho phép chiếu từ vựng áp dụng lên token cuối cùng của mỗi chuỗi. Giữ cố định, đổi sang ; trước tiên dự đoán những thuật ngữ nào giữ nguyên, rồi tính phần chênh lệch. Cuối cùng, lấy một request duy nhất với đầu vào 8K làm ví dụ, so sánh việc xử lý toàn bộ đầu vào với việc tái sử dụng một tiền tố. Khi tái sử dụng, giữ lại KV của 6144 token đầu tiên và chỉ xử lý 2048 token mới thêm. Tìm xem cách sau tiết kiệm bao nhiêu phần trăm độ phức tạp ma trận so với việc xử lý toàn bộ đầu vào.
2.2 Tiêu thụ tài nguyên trong quá trình sinh tự quy hồi
Để tính tài nguyên cần cho việc sinh ra một phản hồi hoàn chỉnh, ta cần không chỉ các phép toán trong một forward pass đơn lùng, mà còn số lần model được gọi và thời gian trạng thái được giữ. Cùng một bộ weight có thể được dùng hàng trăm lần trong một request, trong khi KV cache vừa được đọc vừa tăng dần. Do đó số byte lưu trữ cuối cùng có thể khác với tổng số byte được truy cập tới vài bậc số.
2.2.1 Prefill, decode và tái sử dụng trạng thái
Trong prefill, model nhận một đoạn đầu vào đã biết và có thể tính biểu diễn của nhiều token cùng lúc. Sau khi logits của đầu vào token cuối cùng chọn ra output token đầu tiên, model bước vào giai đoạn decode: lần gọi tiếp theo đưa token đó vào làm đầu vào mới, tạo ra output kế tiếp, và mở rộng chuỗi từng bước. Cả hai giai đoạn dùng cùng một model, nhưng cái trước có nhiều đầu vào token đã biết, còn cái sau, trong quá trình sinh tuần tự thường lệ, mỗi request mỗi lần gọi chỉ thêm một token.
Nếu mỗi lần sinh một token lại gửi lại toàn bộ tiền tố cho model, thì các phép chiếu và tính toán mạng feedforward cho token cũ sẽ bị lặp lại. Trong một model nhân quả, token cũ không thể thấy các token được thêm sau; miễn là weight, chỉ số vị trí token và các điều kiện tính toán liên quan không thay đổi, , do token cũ tạo ra có thể được giữ lại. Các query sau đọc các giá trị , ngữ cảnh này và append , mới cho vị trí token hiện tại, tránh phần lớn việc tính lại cho token cũ.
Cache biến “tính lại biểu diễn của token cũ” thành “lưu trữ và truy cập trạng thái của token cũ”. Các vị trí token tương lai sẽ tự tạo của mình, dùng nó để chấm điểm của token cũ, rồi tổng hợp theo các trọng số thu được — vì vậy thứ được giữ lâu dài chính là và . Các query cũ đã hoàn thành nhiệm vụ của chúng; bước tiếp theo dùng một query mới. Chương 8 bàn thêm về cách chia sẻ trạng thái này giữa các request khác nhau.
KV cache BF16 của Qwen3-8B chiếm, mỗi token ngữ cảnh:
Con số 2 ban đầu tượng trưng lần lượt cho key và value; trong layer, mỗi layer lưu nhóm vector chiều rộng , mỗi phần tử chiếm byte. Do đó việc lưu token ngữ cảnh cần . của Qwen3-8B tương ứng 1,125 GiB, và xử lý thêm một đầu vào token thì tăng thêm 144 KiB. Giảm một nửa số layer hoặc số KV head cũng làm giảm một nửa tốc độ tăng; khi batch size tăng, mỗi request độc lập lại thêm một ngữ cảnh riêng của nó.
2.2.2 Dấu chân bộ nhớ và khối lượng truy cập dữ liệu
KV cache lưu các kết quả đã tính sẵn, tránh tính lại trong quá trình sinh tiếp theo. Để phân tích số tính toán được tiết kiệm so với chi phí lưu trữ bổ sung, ta chia dữ liệu thành ba loại theo mục đích và vòng đời: weight, trạng thái ngữ cảnh và dữ liệu tạm.
| Loại dữ liệu | Lưu trữ và tái sử dụng | Các mục chính được tính trong chương này |
|---|---|---|
| Weight | Thường giữ nguyên qua nhiều lần gọi | Byte thường trú, tập weight được truy cập, tái sử dụng trong batch |
| Trạng thái ngữ cảnh | Giữ theo từng request, liên tục được append hoặc cập nhật | Dung lượng thực tế chiếm đóng, khối lượng đọc/ghi mỗi bước, và tính toán cần cho việc cập nhật |
| Dữ liệu tạm | Sinh ra trong operator hoặc giai đoạn tương ứng, giải phóng sau khi dùng | Kích thước tensor, lượng dữ liệu đi qua giao diện lưu trữ tương ứng, những phần phải giữ đồng thời |
Trước hết là weight. Toàn bộ weight BF16 của Qwen3-8B chiếm khoảng 16,38 GB, tức 15,26 GiB. Một khi model được nạp, dữ liệu này được nhiều request dùng lặp lại. Trong một forward pass, lớp embedding tra cứu các hàng theo token ID, các projection và FFN bên trong layer dùng ma trận tương ứng, và output head cuối cùng tính các điểm số đầu ra. Vì vậy tập weight được truy cập được quyết định bởi các phép toán cụ thể trong đồ thị tính toán.
Với một phép nhân ma trận , mọi hàng đầu vào đều dùng cùng một ma trận weight. Một khi một khối weight được nạp vào bộ nhớ trên chip, nó có thể được dùng lần lượt cho nhiều hàng đầu vào, để một lần đọc tham gia nhiều phép tích-tích-lũy hơn. Khi số hàng được xử lý tăng, tính toán tăng theo, trong khi dung lượng của toàn bộ ma trận giữ cố định. Chương 5 giải thích thêm về việc dung lượng trên chip và tiling quyết định một bộ weight có thể được tái sử dụng bao nhiêu lần.
Trạng thái ngữ cảnh đã được tính ở mục 2.2.1; bộ nhớ mà dữ liệu tạm chiếm bao nhiêu tùy thuộc vào những tensor nào tồn tại đồng thời. Sau khi một layer giải phóng các buffer của nó, layer tiếp theo có thể dùng lại cùng không gian; hợp nhất operator (operator fusion — gộp nhiều phép toán liền kề thành một chương trình thực thi duy nhất) cũng có thể giữ một số giá trị trung gian chỉ trong thanh ghi hoặc bộ nhớ trên chip. Do đó khi tính khối lượng đọc/ghi, ta phải đếm mọi lần truy cập; khi tính đỉnh bộ nhớ, ta phải xác định những tensor nào vẫn cần được giữ tại cùng một thời điểm. Chương 5 phân tích điều này thêm với các chương trình cụ thể.
Dung lượng lưu trữ phụ thuộc vào dữ liệu nào phải được giữ tại một thời điểm nhất định, trong khi khối lượng truy cập phụ thuộc vào số lần dữ liệu được đọc và ghi trong lúc thực thi. Ví dụ, nếu một bước decode đọc toàn bộ ngữ cảnh cũ một lần, khối lượng đọc logic là ; chạy nhiều bước liên tiếp sẽ tích lũy dần đại lượng này. Chỉ sau khi xác định các lần truy cập này thực sự đi qua tầng lưu trữ nào, ta mới có thể chia tương ứng cho băng thông của giao diện đó.
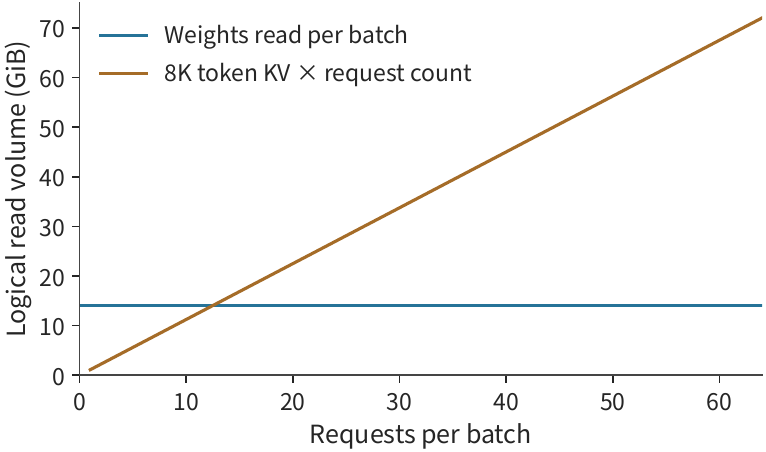
Ví dụ làm việc 2-2: Khi batch size tăng, khi nào khối lượng đọc ngữ cảnh vượt khối lượng đọc weight? Với Qwen3-8B, mỗi batch đọc một lần các weight dùng chung cần thiết, tương ứng khoảng 15,14 GB dữ liệu, với việc tra cứu hàng embedding được tính riêng cho từng request. Ngữ cảnh 8K BF16 của mỗi request là 1,125 GiB, giả sử các request độc lập mỗi cái đọc một lần ngữ cảnh cũ của riêng mình.
Giải: Gọi khối lượng đọc weight dùng chung mỗi batch là ; vì ngữ cảnh của mỗi request độc lập, khối lượng đọc ngữ cảnh là . Lập hai đại lượng bằng nhau:
Thay bytes và bytes, batch size nguyên nhỏ nhất là 13 khi , và là 51 khi . Rút ngắn độ dài ngữ cảnh xuống một phần tư giá trị ban đầu làm tăng khoảng bốn lần số request cần để khối lượng đọc ngữ cảnh vượt khối lượng đọc weight. Ngữ cảnh càng dài, lợi ích của việc tái sử dụng weight trong batch càng sớm chạm giới hạn, vì mỗi request thêm vào lại đóng góp thêm một lần đọc ngữ cảnh độc lập.
Theo đường dữ liệu từ Chương 1, việc nạp đưa các weight từ bộ nhớ lưu trữ vào GPU memory, và quá trình thực thi sau đó đưa các weight cần thiết đến đơn vị tính toán. KV và activation giữa các layer cũng có thể được lưu và dùng trong accelerator. Do đó cùng một lần truy cập logic có thể nằm trên chip, đi qua HBM, hoặc truyền giữa các accelerator; Chương 4 phân tích dung lượng lưu trữ và băng thông truyền của từng đường đi riêng.
2.2.3 Tính toán và khối lượng đọc/ghi trạng thái cho một phản hồi hoàn chỉnh
Một phản hồi hoàn chỉnh thực thi nhiều bước lặp đi lặp lại, và cùng một ngữ cảnh được đọc nhiều lần trong suốt quá trình đó. Xét một request sinh tuần tự thường lệ đơn lẻ: , một tiền tố được phục hồi độ dài , token trong đầu vào hiện tại, và cuối cùng trả về token. Gọi . Prefill xử lý đầu vào mới và tạo ra output đầu tiên, kế tiếp là lần gọi decode. Token trả về cuối cùng chưa được đưa ngược lại vào model, nên KV của nó không tự động được lưu ở cuối request.
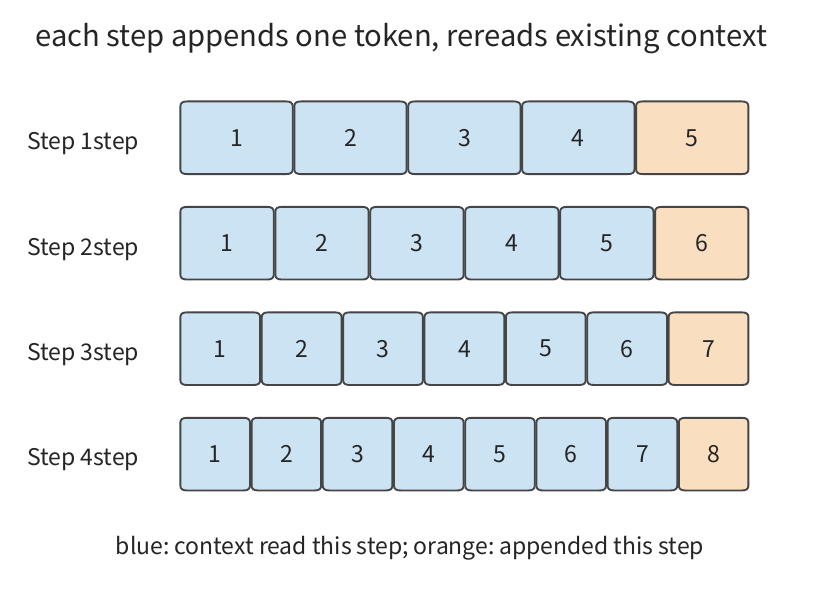
Mỗi hàng trong Hình 2-7 nhiều ô đã tô hơn hàng phía trên nó một ô: một vị trí được append trước đó giờ cũng trở thành một phần của ngữ cảnh. Trước khi thực thi bước decode thứ (với bắt đầu từ 0), độ dài ngữ cảnh là . Vì vậy nếu mỗi bước decode đọc hết toàn bộ ngữ cảnh trước đó một lần, khối lượng đọc tích lũy là:
Kích thước trạng thái mới mà decode thêm vào là ; nếu giữ toàn bộ ngữ cảnh, KV cuối cùng hiệu lực là . Tổng KV mới cho request này cũng nên bao gồm được prefill ghi. Việc phục hồi và truyền một tiền tố hiện có được tính riêng. Mỗi thành phần trong tổng ứng với ngữ cảnh đã có lúc bắt đầu một bước decode: những vị trí xuất hiện sớm hơn tham gia nhiều query sau hơn, còn vị trí xuất hiện muộn hơn tham gia ít hơn.
Ví dụ làm việc 2-3: Tại sao khối lượng đọc KV tích lũy từ quá trình sinh từng bước lại vượt xa dung lượng lưu trữ? Tìm kích thước KV được lưu ở cuối request, và tổng khối lượng KV hiện có được đọc trong lúc sinh.
Giải: Lấy , , , nên ; trong toàn bộ quá trình, tổng số lần đọc KV của các token ngữ cảnh đạt 8.912.384. KV mỗi token chiếm 144 KiB, nên khối lượng đọc tích lũy khoảng 1224 GiB. Trong lúc sinh chỉ có 144 MiB KV được thêm mới, và cuối cùng lưu tổng cộng khoảng 1,27 GiB. Khối lượng đọc tích lũy gần gấp một nghìn lần dung lượng lưu trữ cuối cùng, vì mọi token đã có trong ngữ cảnh đều được đọc lại bởi mọi bước decode tiếp theo; trong ví dụ này, tuyệt đại đa số ngữ cảnh là 8192 đầu vào token do prefill ghi.
Tập hợp các lần gọi này cũng quyết định tổng lượng tính toán. Các projection tuyến tính và FFN xử lý một hàng mỗi lần gọi decode, trong khi tương tác ngữ cảnh tăng theo . Gọi phép tính ma trận cố định mỗi bước là , và tính toán cần để tương tác với mỗi token ngữ cảnh là ; khi đó
Khi độ dài output thay đổi, công việc tích lũy từ phần cố định mỗi bước tăng tuyến tính theo , trong khi phần được thêm vào bởi ngữ cảnh đang lớn dần trong lúc sinh làm cho một phần của tổng tính toán tăng theo bình phương số bước sinh. Trả về một token duy nhất tương ứng , , chỉ thực thi prefill; trường hợp đặc biệt này cũng minh họa tại sao một phản hồi hoàn chỉnh gồm bước decode tiếp theo.
Hình 2-7 tích lũy các lần đọc theo số bước sinh, trong khi Hình 2-8 tích lũy các lần đọc theo số request. Với nhiều request độc lập, dung lượng trạng thái và truy cập ngữ cảnh cộng dồn riêng theo từng request, còn weight trong batch thì dùng chung. Khi các độ dài khác nhau, thay và của từng request: output càng dài, ngữ cảnh hiện có được đọc càng nhiều lần; input càng dài, bước decode đầu tiên càng phải truy cập nhiều ngữ cảnh hơn. Với các cuộc hội thoại thực tế, trước tiên có thể dựng chuỗi các lần gọi này từ độ dài đầu vào của từng lượt, tình trạng cache-hit, và số token trả về; mục Known-Prefill Sealed Chat Accounting cung cấp quá trình thay số chi tiết.
Bài tập 2-3 [Mở rộng]: Dung lượng KV và khối lượng đọc tích lũy tăng trưởng ra sao khi độ dài output thay đổi?
Dùng Qwen3-8B với , lần lượt trả về và token. Tìm số bước decode tiếp theo, kích thước KV cuối cùng, và khối lượng đọc tích lũy của ngữ cảnh cũ. Giải thích tại sao, khi số output xấp xỉ gấp đôi, dung lượng KV mới được thêm trong lúc sinh, tổng dung lượng KV cuối cùng, và khối lượng đọc tích lũy lại tăng với những tốc độ khác nhau. Sau đó giảm một nửa độ rộng bit của KV và xác định trong ba đại lượng nào bị giảm một nửa.
2.3 Đại diện trạng thái ngữ cảnh và cơ chế truy cập
Khi model tiếp tục sinh, nó cần tận dụng nội dung mà nó đã đọc. Xét hai cách ghi chép: cách thứ nhất để lại một bản ghi trên mỗi trang và lấy ra trang nào cần; cách thứ hai chỉ giữ một bản tóm tắt cố định độ dài, viết lại mỗi lần đọc được nội dung mới. Cách thứ nhất tăng theo lịch sử; cách thứ hai giữ nguyên kích thước nhưng không đảm bảo khôi phục mọi chi tiết của từng token.
Áp vào model, một lớp cơ chế lưu key và value cho mọi vị trí token, còn sự hồi quy trạng thái hữu hạn (finite state recurrence) gộp các đóng góp lịch sử vào một trạng thái cố định độ dài. Cả ghi chú theo từng token lẫn các bản tóm tắt hồi quy đều được lưu dưới dạng vector hoặc ma trận số. Những biểu diễn này, được lưu sau khi model xử lý ngữ cảnh và tái sử dụng trong tính toán tiếp theo, được gọi là trạng thái ngữ cảnh (context state). Độ dài ngữ cảnh đo bằng số token, còn dung lượng trạng thái đo bằng số byte thực tế được lưu.
Khi so sánh các cơ chế này, trước tiên nhìn xem lịch sử để lại gì, rồi nhìn bước tiếp theo lấy thông tin cần thiết ra sao: có thể biểu diễn mỗi token bằng ít chiều hơn, hoặc chỉ truy cập trực tiếp các vị trí gần đây, tổng hợp nhiều vị trí thành ít mục hơn, hoặc lọc trước khi đọc. Một lớp cơ chế khác liên tục cập nhật một trạng thái cố định độ dài, từ đó các query lấy kết quả của mình. Những sắp xếp này lần lượt thay đổi chiều rộng biểu diễn, số mục và cách truy cập; phần lưu trữ và đọc được tiết kiệm phải cân với công việc bổ sung của việc chọn lọc, nén và cập nhật.
2.3.1 Multi-head attention và KV sharing
Cách trực tiếp nhất để tiết kiệm ghi chú theo từng token là giảm số bản sao , được lưu cho mỗi token. Multi-head attention (đa head) để các query head khác nhau học những quan hệ khác nhau trong ngữ cảnh một cách riêng lẻ. Trong multi-head attention (MHA), mỗi head có , head riêng; multi-query attention (MQA) để tất cả head dùng chung một bộ , ; grouped-query attention (GQA) gom các head thành nhóm, mỗi nhóm dùng chung một bộ , . Sau khi dùng chung, số nhóm , phải lưu cho mỗi token ngữ cảnh giảm, trong khi số token ngữ cảnh giữ nguyên.
Lấy một layer đơn lẻ chỉ có bốn query head làm ví dụ. MHA lưu một bộ , cho mỗi bốn query head; GQA có thể để hai query head đầu dùng chung một bộ , , và hai query head sau dùng chung bộ thứ hai; MQA để cả bốn query head dùng chung một bộ. Với cùng độ dài ngữ cảnh và chiều rộng head, số bộ KV phải lưu lần lượt là bốn, hai và một. Vì vậy trong ví dụ này, GQA giảm một nửa dung lượng lưu trữ ngữ cảnh. Cả bốn query head vẫn có thể tạo ra bốn tập điểm số khác nhau trên cùng ngữ cảnh — đây chính là sự khác biệt giữa “dùng chung biểu diễn ngữ cảnh” và “gộp các query”.
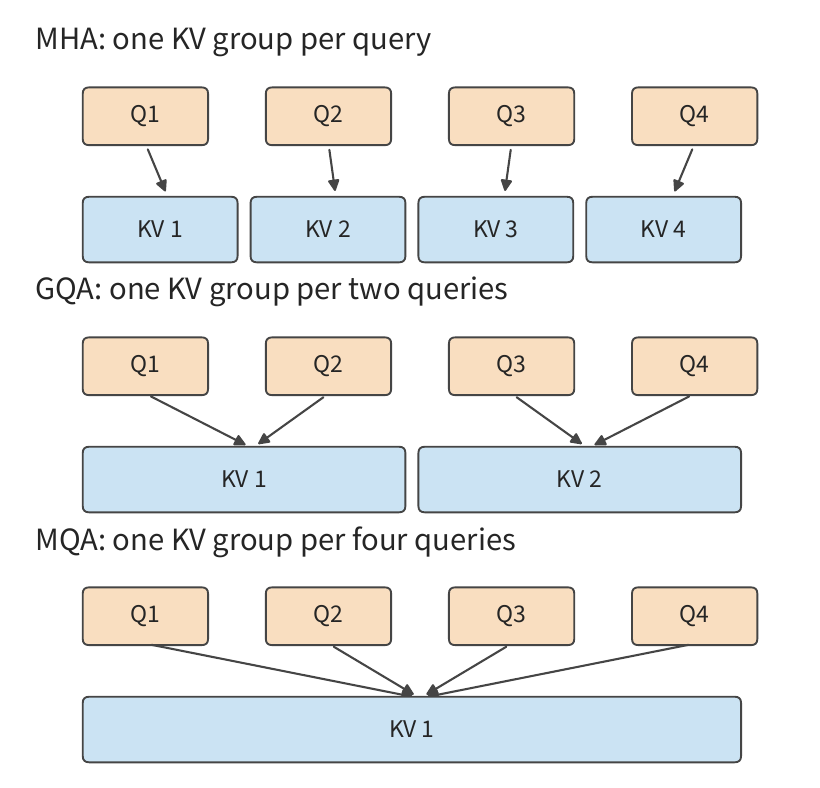
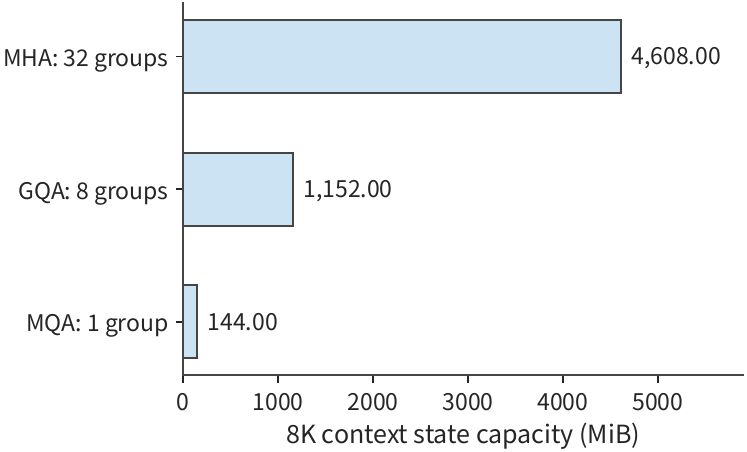
Qwen3-8B áp dụng sơ đồ chia sẻ này, để mỗi bốn query head dùng chung một bộ KV, tổng cộng 32 query head và 8 KV head. Nếu mỗi query head lưu KV riêng, dung lượng sẽ gấp bốn lần cấu hình hiện tại; nếu tất cả query dùng chung một bộ, dung lượng sẽ là một phần tám. Cấu hình GQA thực tế này cần 1,125 GiB để lưu 8192 token. Con số dung lượng ở cuối mục này cố định độ dài ngữ cảnh và chiều rộng head trong khi chỉ thay đổi số nhóm KV, nên tỷ lệ chiều cao các cột biểu thị trực tiếp tỷ lệ dùng chung.
Dùng chung , làm thay đổi dữ liệu được truy vấn, nhưng 32 head vẫn tính điểm số và output có trọng số một cách riêng lẻ. Vì vậy dung lượng projection và lưu trữ KV giảm theo số nhóm, trong khi các tương tác và vẫn cộng dồn theo số query head. Một lần đọc , cũng có thể phục vụ nhiều query head trong cùng nhóm, nên tính toán thực tế dùng lại cùng dữ liệu.
Ta có thể dự đoán thay đổi tài nguyên trực tiếp từ số nhóm. Giảm một nửa sẽ giảm một nửa cả tham số projection key-value lẫn dung lượng trạng thái ngữ cảnh; số query head giữ nguyên, nên tính toán cho tương tác query–ngữ cảnh vẫn cộng dồn theo số head ban đầu.
KV sharing cũng minh họa cách các ràng buộc hạ tầng ảnh hưởng đến thiết kế model. Bài báo gốc về MQA dẫn thẳng chi phí băng thông bộ nhớ của phương pháp inference theo từng bước làm động cơ; GQA tìm cách cân bằng giữa chất lượng của MHA và tốc độ của MQA. Giảm số KV head làm thay đổi cả những quan hệ attention mà model có thể biểu đạt lẫn trạng thái mà phía phục vụ phải lưu và đọc.
2.3.2 Nén latent và đường thực thi MLA
GQA và MQA tiết kiệm không gian bằng cách giảm số nhóm KV, còn multi-head latent attention (MLA) tiết kiệm không gian bằng cách giảm số chiều của biểu diễn ngữ cảnh. Đầu vào trước tiên có thể được chiếu vào một latent số chiều thấp, rồi chiếu lên để thu được , dùng cho attention. Model học những biểu diễn số chiều thấp và các phép chiếu lên này trong lúc huấn luyện, và khi sinh thì lưu ngữ cảnh dưới dạng .
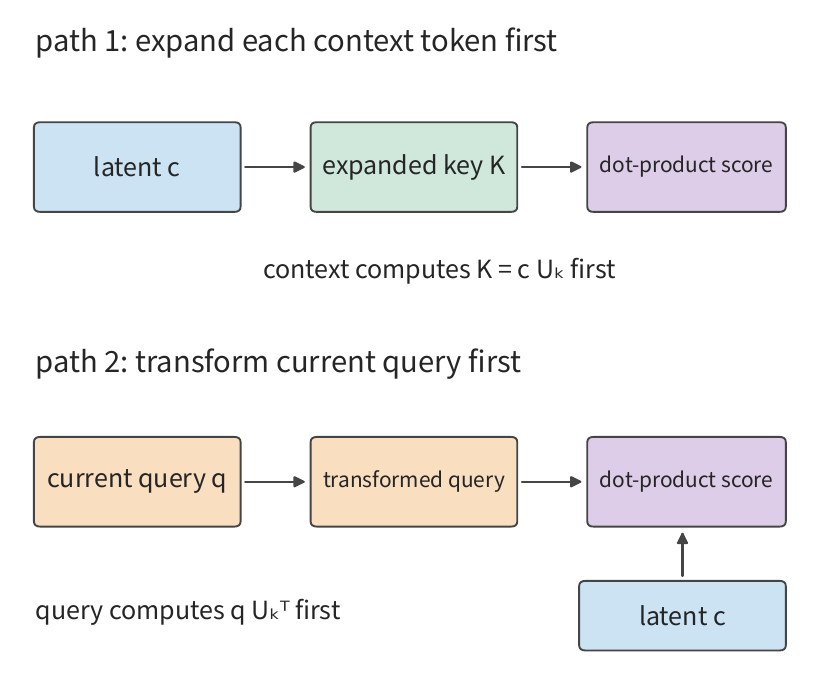
Lý do chỉ lưu latent như sau. Gọi phép chiếu lên của key là , các latent ngữ cảnh xếp thành ma trận theo hàng, và key được mở rộng là . Tính kết hợp của nhân ma trận cho
Vế trái phục hồi key cho từng token ngữ cảnh trước; vế phải biến đổi query hiện tại trước. Với một query mới đơn lẻ, vế phải chỉ cần một phép biến đổi query, sau đó lấy tích vô hướng trực tiếp với các latent. Vector value cũng có thể được chiếu lên sau khi tổng hợp có trọng số: tổng hợp các vector số chiều thấp trước, rồi khôi phục chiều đầu ra. Theo cách này, phép chiếu lên vốn được thực hiện cho mọi token ngữ cảnh nay được thực hiện cho query hiện tại và kết quả tổng hợp.
Chương này dùng Gated MLA (Gated Multi-head Latent Attention — MLA có cổng) của Kimi K3 làm ví dụ; cổng dùng một hệ số được học để điều biến output attention. Đường nén lưu một latent 512 chiều cùng một nhánh 64 chiều bổ sung tham gia phép tích vô hướng . Tất cả các layer MLA của Kimi K3 dùng NoPE (No Position Encoding — không mã hóa vị trí): query và key không nhận RoPE, còn thông tin vị trí do gating và suy giảm hồi quy của các layer KDA cung cấp (mục 2.3.4); bản tham chiếu vẫn chiếu và cache nhánh 64 chiều này, chỉ là không xoay nó, nên mỗi token lưu chiều. Với 24 layer MLA, ngữ cảnh 8192 token và BF16, dung lượng lưu trữ là , tức 216 MiB.
Cache giãn nở trước tiên phục hồi latent thành , theo từng head, rồi lưu những vector này; cùng 8192 token cần khoảng 11,25 GiB. Cache nén thay vào đó lưu latent trước khi chiếu lên. Chênh lệch dung lượng giữa hai loại do đó đến từ phía nào của biến đổi tuyến tính mà cache nằm: cache nén biến đổi query hiện tại ở mỗi bước, còn cache giãn nở đọc trực tiếp các vector ngữ cảnh của từng head.
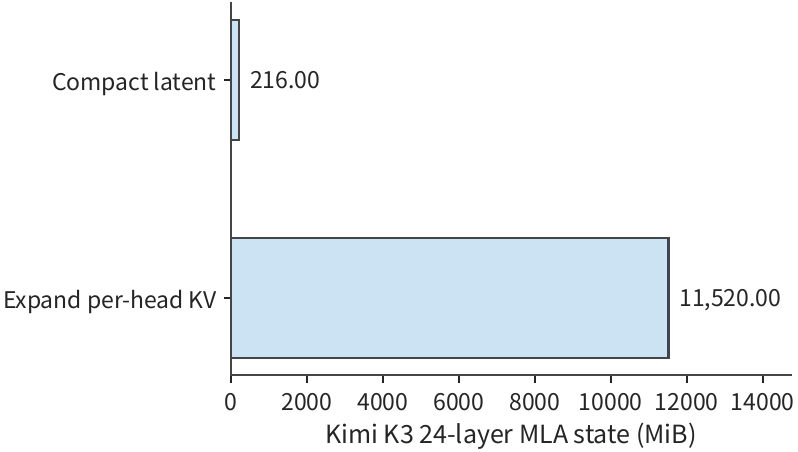
Phép biến đổi này giảm chiều rộng biểu diễn mỗi token ngữ cảnh, nhưng vẫn phải lưu một vector latent cho mỗi token. Vì vậy dung lượng lưu trữ và phép tính tích vô hướng vẫn tăng theo độ dài ngữ cảnh. Ngữ cảnh càng dài, biểu diễn nén tiết kiệm càng nhiều khối lượng đọc; ngữ cảnh càng ngắn, chi phí tương đối của chính phép biến đổi query càng cao.
2.3.3 Cửa sổ cục bộ, nén ngữ cảnh và chỉ mục hóa thưa
Giả sử model đã đọc một đoạn văn bản dài và giờ phải xử lý một token mới. Model có thể đọc trực tiếp dải vị trí gần nhất, hoặc đọc các mục được tạo bằng cách tổng hợp nhiều token cũ, hoặc trước tiên tìm các mục liên quan đến query hiện tại rồi đọc trạng thái attention chính của đúng những mục đó. Ba hành động này lần lượt sinh ra cửa sổ cục bộ (local window), nén ngữ cảnh (context compression) và chọn lọc thưa (sparse selection). Cả ba đều có thể kết hợp, nhưng phải đo riêng biệt: cửa sổ giới hạn phạm vi gần đây, nén giảm số mục lâu dài, còn chỉ mục chọn những mục nào sẽ đọc ở bước hiện tại. Việc tự lọc cũng đòi hỏi đọc các biểu diễn chỉ mục và tính điểm — không thể chỉ đếm trạng thái attention chính của những mục cuối cùng được chọn.
Hãy trước tiên phân biệt ba đối tượng. Sliding-Window Attention (SWA — attention cửa sổ trượt) đọc trực tiếp dải vị trí gần nhất; với độ dài cửa sổ 128, những vị trí trước đó rơi khỏi cửa sổ cục bộ này. Global main KV là biểu diễn dài hạn được attention chính đọc, có thể đã gộp nhiều vị trí; “toàn cục” (global) chỉ ra nó bao phủ một lịch sử dài hơn, không phải mỗi lần đọc chạm vào tất cả các mục. Index K là một biểu diễn riêng, nhỏ hơn dùng để truy vấn: indexer dùng nó để chấm điểm các mục trước, rồi attention chính đọc main KV được chọn. Điểm chỉ mục dùng để chọn các mục cache; riêng attention chính dùng query của chính nó để tính các trọng số tổng hợp cuối cùng.
Model học qua huấn luyện để tóm tắt một dải đầu vào thành một biểu diễn dùng chung. Một bản ghi main KV 512 chiều vừa kiêm key vừa kiêm value trong attention, dùng chung bởi nhiều query head, dung lượng tính theo từng bản ghi. SWA lưu chi tiết gần đây, còn nhánh toàn cục cung cấp thông tin trước đó, và query hiện tại dùng cả hai cùng lúc.
DeepSeek V4-Flash kết hợp bộ cơ chế này trong một model duy nhất, với 43 layer backbone, chiều ẩn 4096, và 64 attention head, mỗi head 512 chiều. trước được chiếu từ 4096 chiều xuống 1024 chiều, rồi được mở rộng thành query chiều; KV dùng chung được chiếu từ 4096 chiều xuống 512 chiều. Output dùng một phép chiếu hạng thấp (low-rank) chia thành 8 nhóm — tức là trước chiếu sang một chiều trung gian hẹp hơn rồi mới chiếu sang chiều mục tiêu. Các chiều đầu vào và đầu ra của mỗi phép chiếu quyết định hình dạng ma trận tương ứng.
DeepSeek V4-Flash dùng hai loại attention nén: Compressed Sparse Attention (CSA — attention thưa nén) trước tiên nén ngữ cảnh rồi chọn các mục liên quan qua chỉ mục; Heavily Compressed Attention (HCA — attention nén nặng) gộp nhiều vị trí thành ít mục thô ráp hơn để query truy cập. Cả hai đều dùng để giảm dung lượng lưu trữ và truy cập cho ngữ cảnh dài; chúng khác nhau ở mức độ nén và việc các mục có được lọc thêm hay không. Backbone của nó gồm 2 layer cửa sổ thuần túy, 21 layer CSA và 20 layer HCA, với độ dài cửa sổ 128. CSA lưu ngữ cảnh ở tỷ lệ nén 4 và duy trì một chỉ mục; HCA lưu ngữ cảnh thô ráp hơn ở tỷ lệ nén 128. Dùng BF16 làm định dạng lưu trữ tham chiếu, mỗi mục nén hoàn chỉnh trong CSA giữ một trạng thái attention chính 512 chiều, cộng một mục chỉ mục riêng 128 chiều. Với token đã có, số mục hoàn chỉnh được tính là ; những khối chưa hoàn chỉnh vẫn cần buffer riêng của chúng.
Tỷ lệ nén mô tả số mục đầu ra, và không nhất thiết bằng toàn bộ dải đầu vào mà một mục bao phủ. CSA của V4 tạo một bản ghi cho mỗi bốn token mới, nhưng dùng các khối liền kề chồng lấn: ngoại trừ cách xử lý ranh giới của khối đầu tiên, mỗi mục tổng hợp thông tin từ tám token trải qua hai khối liền kề bằng hai tập phép chiếu khác nhau; mỗi token thêm nữa còn dùng một trọng số theo kênh được học. HCA tạo một bản ghi cho mỗi 128 token, không dùng sự chồng lấn khối liền kề này, và không dùng chỉ mục top-k (chỉ lấy mục có điểm chỉ mục cao nhất) — thay vào đó nó đọc tất cả các mục thô ráp đã hoàn chỉnh. Chỉ CSA2 của V4.1 (phiên bản thứ hai của CSA) mới loại bỏ phép nén chồng lấn mà CSA của V4 dùng.
Một lần query CSA, attention chính đọc tối đa cửa sổ cộng 512 mục nén, nhưng việc chấm điểm chỉ mục vẫn quét qua tất cả các mục chỉ mục nén đã lưu. Tại , một layer CSA giữ 2048 mục nén: trạng thái attention chính khoảng 2 MiB, chỉ mục khoảng 0,5 MiB, và cửa sổ khoảng 0,125 MiB; các mục nén được attention chính chọn tổng cộng tối đa khoảng 0,5 MiB, nhưng việc quét chỉ mục vẫn phải xử lý tất cả 2048 mục chỉ mục. Trong khi đó HCA có 64 mục hoàn chỉnh, với trạng thái attention chính khoảng 0,0625 MiB, và truy cập trạng thái cửa sổ cộng bộ mục nén thô ráp này.
Cộng trên toàn bộ 43 layer, dùng định dạng BF16 tham chiếu nêu trên, ở ngữ cảnh 8192 token thì cửa sổ, ngữ cảnh nén và chỉ mục tổng cộng đạt 59,125 MiB; ngoài ra còn có khoảng 11,641 MiB buffer nén FP32, cộng lại khoảng 70,8 MiB. Các lần đọc attention chính (gồm cửa sổ) cộng chỉ mục cho query cuối cùng tổng cộng 27,625 MiB. Mục State Breakdown liệt kê chi tiết những con số này, làm rõ số mục được chọn, kích thước trạng thái được lưu, và khối lượng đọc mỗi bước mỗi cái đại diện cho điều gì.
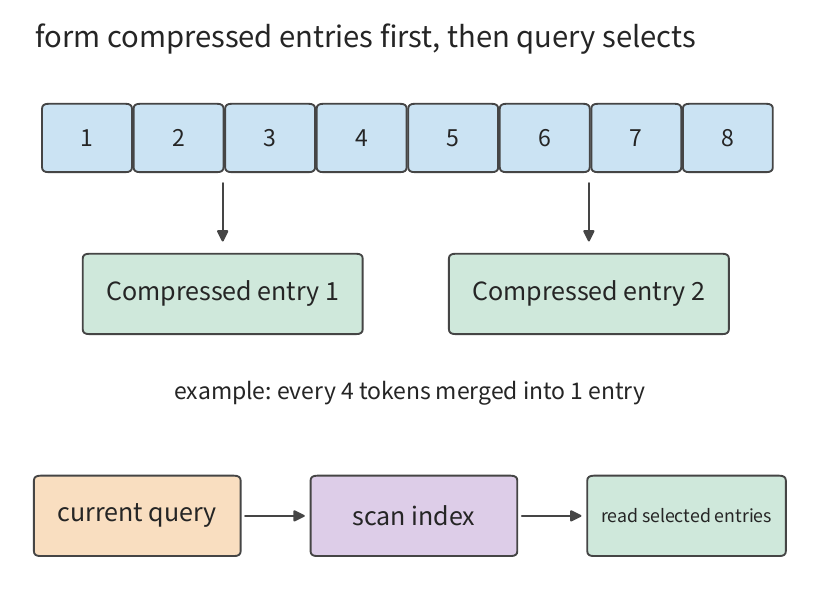
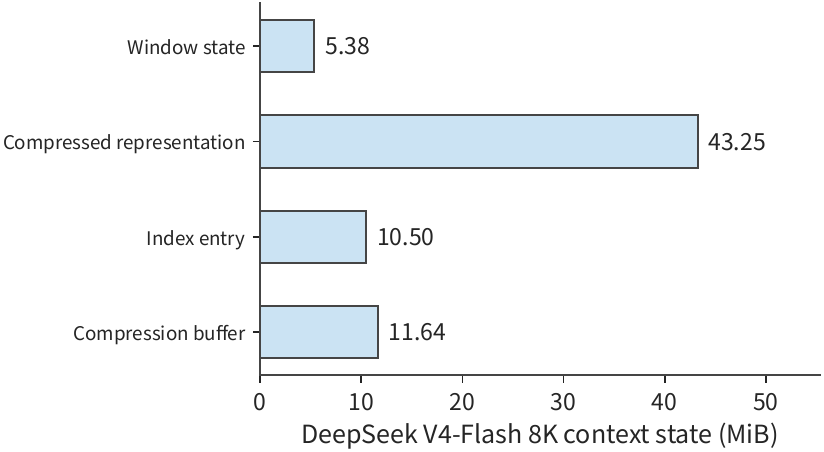
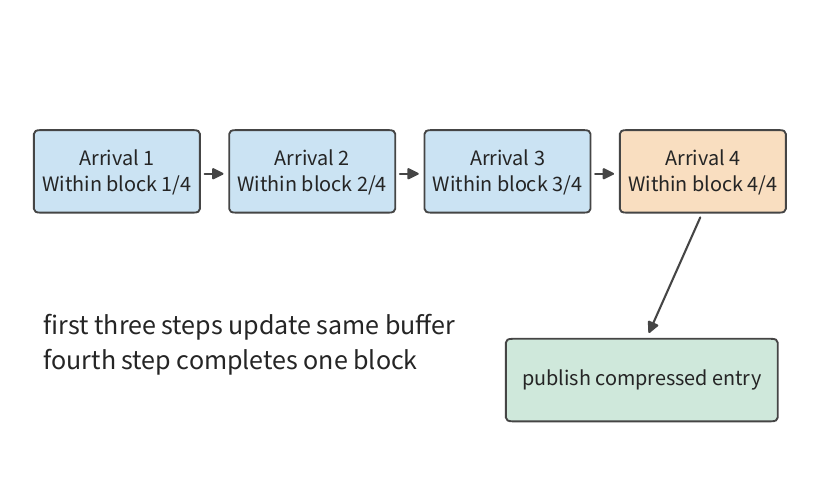
Việc nén cũng đưa đến một nhịp cập nhật khác với nhịp của query. Khi một token mới đến, khối nén hiện tại được cập nhật trước; một khi số token tích lũy đạt tỷ lệ nén, một mục lâu dài được tạo ra. CSA hoàn tất một khối mỗi bốn token, HCA mỗi 128 token. Vì vậy, khi xử lý cùng một đầu vào token, việc attention chính truy cập bao nhiêu mục, chỉ mục quét bao nhiêu mục, và khối nén có hoàn thành hay không, mỗi cái đều phải tính riêng. Khi xử lý token thứ 128, cả hai loại khối nén có thể hoàn thành cùng lúc.
Bài tập 2-4 [Mở rộng]: KV sharing và nén ngữ cảnh thay đổi dung lượng lưu trữ và truy cập ra sao
Trước tiên đổi số KV head của Qwen3-8B từ 8 xuống 4, giữ nguyên 32 query head, và tính thay đổi của dung lượng KV, số tham số projection KV, và tính toán cần cho tương tác query–ngữ cảnh. Sau đó, với các layer CSA của DeepSeek V4-Flash, tăng ngữ cảnh từ 8192 lên 16384, và với tỷ lệ nén 4 cùng mức tối đa 512 mục nén được chọn mỗi query, tính số mục được lưu, số mục chỉ mục được quét, và cận trên của các mục được chọn. Giải thích tại sao ba đại lượng này không tăng với cùng một tốc độ.
2.3.4 Attention tuyến tính và hồi quy trạng thái hữu hạn
Các cơ chế ở mục 2.3.1 đến 2.3.3 vẫn phân biệt được giữa từng mục ngữ cảnh được lưu. Hồi quy trạng thái hữu hạn đi theo hướng khác: mỗi khi một token mới đến, đóng góp của nó được gộp vào trạng thái hiện có, và query hiện tại dùng trực tiếp trạng thái đã cập nhật; bước tiếp theo tiếp tục ghi đè trạng thái này. Điều này tương ứng với hình ảnh được nêu ra ở đầu mục 2.3: liên tục viết lại một bản tóm tắt cố định độ dài. Lớp attention tuyến tính này sắp xếp lại thứ tự tính toán của query, key và value, không còn tính rõ ràng điểm attention cho từng cặp query-key. Khi chiều đặc trưng cố định, kích thước ma trận trạng thái không đổi, và tính toán để xử lý một chuỗi tăng tuyến tính theo độ dài chuỗi.
Phép toán cơ bản để dựng trạng thái là tích ngoài (outer product): nhân từng cặp phần tử từ một vector key và một vector value để tạo một bảng liên kết hai chiều. Xét ma trận thu được bằng cách cộng dồn các tích ngoài key-value. Mỗi khi một token mới đến, trước tiên đọc trạng thái cũ, rồi ghi đóng góp của vị trí hiện tại; query hiện tại đọc output của mình trực tiếp từ ma trận trạng thái:
Nếu chiều rộng key là và chiều rộng value là , trạng thái luôn có phần tử. Một token mới làm thay đổi nội dung ma trận, chứ không làm thay đổi kích thước của nó. Danh sách ngữ cảnh theo từng token do đó trở thành một tập các liên kết key-value được tích lũy; các query lấy output của mình từ tập liên kết này.
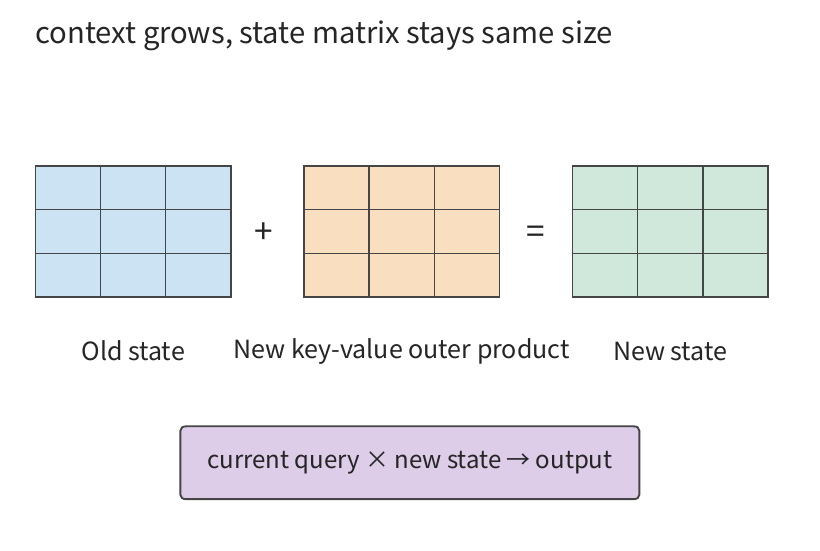
Attention hồi quy thực tế thêm gating và hiệu chỉnh vào phép tích lũy đơn giản. Kimi Delta Attention (KDA) là một cơ chế attention hồi quy có cổng mà Kimi dùng, giữ thông tin ngữ cảnh trong một ma trận liên kết cố định độ dài. KDA dùng gating cùng với một cập nhật delta; ở đây, delta chỉ một hiệu chỉnh được ghi dựa trên lỗi dự đoán hiện tại. Mỗi cập nhật không chỉ ghi thông tin mới mà còn dùng key hiện tại để kiểm tra dự đoán của trạng thái hiện có, rồi ghi một hiệu chỉnh tương ứng; thông tin cũ được giữ dưới dạng một liên kết đã tổng hợp, key hiện tại xác định hiệu chỉnh rơi vào đâu, và một cổng suy giảm (decay gate) xác định bao nhiêu thông tin cũ được giữ lại. KDA cập nhật một ma trận liên kết cố định độ dài thay vì append các mục vào một danh sách lưu theo từng token.
Mỗi layer KDA trong Kimi K3 có 96 head, mỗi head có một ma trận hồi quy . Lưu ở FP32, một layer chiếm 6 MiB, và cả 69 layer chiếm 414 MiB. Một bước decode duy nhất đọc ma trận cũ, gộp thông tin mới vào, rồi ghi lại; trong trường hợp lý tưởng, tổng khối lượng đọc–ghi là 828 MiB. Khối lượng đọc–ghi này không tăng theo độ dài ngữ cảnh: với ngữ cảnh ngắn nó là một chi phí cố định đáng kể, còn với ngữ cảnh dài nó tránh được khối lượng quét vốn sẽ tăng dần theo số token ngữ cảnh.
Prefill và decode cũng khác nhau ở cách cài đặt. Decode dùng hồi quy từng bước; một dải đầu vào đã biết thay vào đó có thể được tính song song bằng một thuật toán theo khối (block-wise), truyền trạng thái giữa các khối. Các đại lượng trung gian bên trong một khối và trạng thái truyền giữa các khối chiếm không gian tạm, nên chỉ riêng kích thước của trạng thái hồi quy cuối cùng là chưa đủ để dự đoán đỉnh bộ nhớ trong lúc prefill. Chương 5 phân tích vấn đề này dựa trên quá trình phân bổ và giải phóng buffer.
2.3.5 Thành phần trạng thái trong attention lai
Các model thực tế thường trộn các layer trạng thái hữu hạn với các layer attention toàn cục. Cách này khai thác khả năng nén ngữ cảnh của cấu trúc hồi quy trong khi vẫn giữ lại một mức khả năng truy cập trực tiếp ngữ cảnh toàn cục. Trạng thái của toàn model gồm nhiều phần: phần thì cố định kích thước, phần thì tăng theo độ dài ngữ cảnh.
Kimi K3 có tổng cộng 93 layer: 69 layer KDA và 24 layer MLA. Với ngữ cảnh 8.192 token, MLA nén ở BF16, trạng thái hồi quy FP32, và các slot conv ngắn (short convolution) BF16 (conv ngắn trộn đầu vào của vài vị trí liền kề theo chiều chuỗi, và slot lưu đầu vào gần đây cần cho cập nhật tiếp theo), ba thành phần lần lượt là 216 MiB, 414 MiB và 19,4 MiB, tổng cộng khoảng 649,4 MiB. Nếu dùng cache unrolled (mở rộng) tham chiếu, riêng thuật ngữ MLA đã là 11,25 GiB, làm thay đổi tổng thể tương ứng.
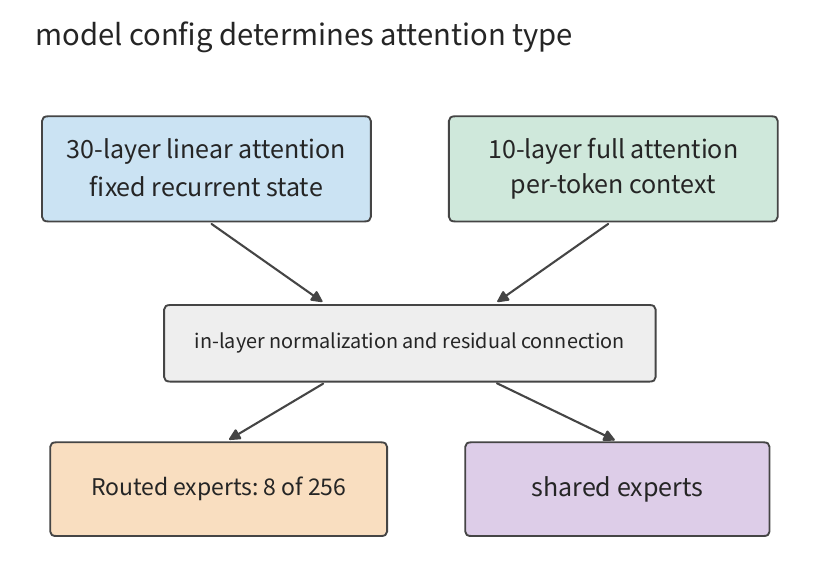
Qwen3.6-35B-A3B cũng cần tính riêng dấu chân trạng thái của các layer attention tuyến tính và các layer attention đầy đủ của nó. 30 layer attention tuyến tính cộng 10 layer attention đầy đủ có KV toàn cục 20 KiB mỗi token ngữ cảnh mỗi request, cộng một trạng thái hồi quy FP32 cố định 60 MiB và một slot conv ngắn BF16 1,875 MiB. Ở ngữ cảnh 8.192 token, ba thành phần tổng cộng 221,9 MiB. Những trạng thái này đến từ nhánh attention. Nhánh Mixture of Experts (MoE — hỗn hợp chuyên gia) kế tiếp cung cấp nhiều mạng con feedforward, từ đó một router chọn một tập con cho từng token để thực thi, xác định những weight nào trong cùng backbone thực sự được dùng. Các mạng con có thể chọn này được gọi là routed expert (chuyên gia được định tuyến), và nhánh do mọi token thực thi được gọi là shared expert (chuyên gia dùng chung). Attention và MoE cùng nhau tạo thành model hoàn chỉnh.
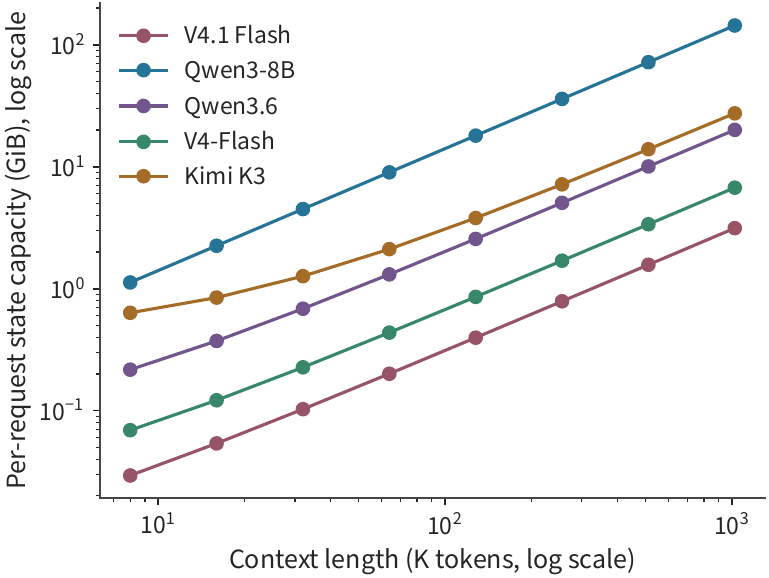
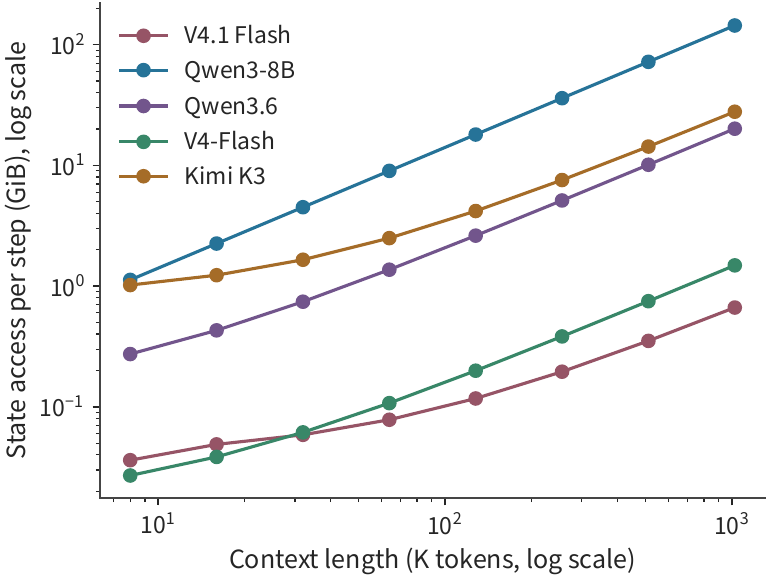
Hình dạng của năm đường cong trạng thái này đến từ những biểu diễn khác nhau. Với mỗi token thêm vào, Qwen3-8B append và trên tất cả các layer GQA; với Kimi K3, chỉ phần MLA append ngữ cảnh, còn phần KDA giữ một ma trận cố định; DeepSeek V4-Flash thêm một mục mỗi lần một khối nén hoàn thành. V4.1 Flash còn đi xa hơn, để nhiều layer đọc cùng một cache toàn cục dùng chung, trong khi Qwen3.6 kết hợp các layer hồi quy với các layer attention đầy đủ. Với ngữ cảnh dài, tốc độ tăng trưởng quyết định dung lượng được thêm; với ngữ cảnh ngắn, những thành phần cố định như ma trận hồi quy quyết định dấu chân khởi đầu.
Cộng một trạng thái hồi quy cố định vào ngữ cảnh theo từng token, ta được mô hình dung hạn cho cấu trúc lai:
là số byte trạng thái được thêm mỗi token ngữ cảnh, và là độ dài ngữ cảnh mà hai thành phần chiếm không gian bằng nhau. Với Qwen3.6, phần cố định là MiB và mỗi token thêm 20 KiB, cho ; với biểu diễn nén của Kimi K3, mỗi token thêm 27 KiB và phần cố định khoảng 433,4 MiB, cho điểm giao nhau vào khoảng 16,4K token ngữ cảnh. Dưới điểm giao nhau, rút ngắn ngữ cảnh chỉ tiết kiệm một phần nhỏ không gian; cao vượt xa điểm giao nhau, giảm chiều rộng biểu diễn mỗi token tiết kiệm dung lượng hiệu quả hơn. DeepSeek V4-Flash thay vào đó thêm các mục khi những khối nén hoàn thành, nên đường cong của nó tăng theo mẫu bậc thang.
Những trạng thái này hỗ trợ những cách truy cập thông tin khác nhau: KV toàn cục để các query chọn trực tiếp bất kỳ token cũ nào, ma trận hồi quy giữ các quan hệ ngữ cảnh qua cập nhật từng bước, và chỉ mục nén tìm kiếm nội dung liên quan trong số ít mục hơn. Mục 2.6.3 sẽ so sánh nhu cầu tài nguyên cùng với các tác vụ truy vấn cụ thể.
Bài tập 2-5 [Cốt lõi]: Ở độ dài ngữ cảnh nào thì dung lượng KV vượt trạng thái cố định?
Với Qwen3.6, lấy trạng thái cố định 61,875 MiB và 20 KiB mỗi token ngữ cảnh; với biểu diễn nén của Kimi K3, trạng thái hồi quy chiếm 414 MiB, trạng thái convolution chiếm 20.348.928 bytes, và mỗi token ngữ cảnh lại thêm 27 KiB. Với mỗi model, tính độ dài ngữ cảnh mà trạng thái tăng theo ngữ cảnh bằng dung lượng trạng thái cố định, và tổng dung lượng trạng thái ở ngữ cảnh 32K và 128K. Nếu ngân sách trạng thái chỉ là 256 MiB, mỗi model tối đa chứa được bao nhiêu token ngữ cảnh? Giải thích tại sao, khi ngân sách dung lượng nhỏ hơn kích thước trạng thái cố định, việc rút ngắn ngữ cảnh vẫn không làm vừa trạng thái của model.
2.3.6 Lưu bao nhiêu cho mỗi token, đọc bao nhiêu mỗi lần decode
So sánh chi phí ngữ cảnh của các model cần nêu đồng thời ba đại lượng: mức tăng lưu trữ trung bình cho mỗi token thêm vào trong lịch sử toàn cục, trạng thái thực tế được lưu ở độ dài , và lịch sử mà một query decode cần đọc. KV toàn cục tăng theo ngữ cảnh; cửa sổ trượt chỉ giữ một dải gần đây; trạng thái hồi quy có kích thước cố định nhưng vẫn phải đọc và ghi ở mỗi bước. Chia cả ba cho độ dài ngữ cảnh sẽ che mất những mẫu tăng trưởng khác nhau của chúng.
Xét một request mà query hiện tại có thể truy cập một ngữ cảnh tổng cộng token, gồm cả vị trí của chính token query. Bảng dưới tính dung lượng lịch sử toàn cục, và khối lượng đọc logic cho một query duy nhất, ở độ chính xác và đường cache chỉ định trong từng hàng: K/V được chọn hoặc latent dùng chung của mỗi layer được đọc một lần, dùng lại giữa việc chấm điểm QK và tính toán PV (tức phép ở trên, tổng hợp các value bằng trọng số attention) cho mỗi query head, cộng cửa sổ SWA cục bộ và quét chỉ mục. Các cập nhật trạng thái của ma trận hồi quy, convolution và compressor được bàn riêng sau bảng.
| Model và đường cache | Tăng trưởng lịch sử toàn cục trung bình (B/token) | Lịch sử toàn cục 8K (MiB) | Lượng đọc attention KV + chỉ mục mỗi decode (MiB) |
|---|---|---|---|
| Qwen3-8B, BF16 GQA | 147.456 | 1.152 | 1.152 |
| Qwen3-32B, BF16 GQA | 262.144 | 2.048 | 2.048 |
| Qwen3-30B-A3B, BF16 GQA | 98.304 | 768 | 768 |
| Qwen3-235B-A22B, BF16 GQA | 192.512 | 1.504 | 1.504 |
| Qwen3.5-397B-A17B, phần full-attention BF16 | 30.720 | 240 | 240 |
| Qwen3.6, phần full-attention BF16 | 20.480 | 160 | 160 |
| Kimi K3, đường MLA nén BF16 | 27.648 | 216 | 216 |
| DeepSeek V4-Flash, định dạng lai sản xuất | 3.514,25 | 27,455 | 12,556 |
| DeepSeek V4.1 Flash, định dạng lai sản xuất | 890 | 6,953 | 11,375 |
Hai biểu diễn MLA của Kimi K3 minh họa cách đường cache ảnh hưởng dung lượng: trong bảng, đường nén thêm 27.648 B mỗi token, trong khi bản tham chiếu Hugging Face được dùng trong cuốn sách này, vốn unroll K/V, thêm 1.474.560 B mỗi token. Mục tính toán cache giữa các model liệt kê chính xác số byte của cả hai đường.
Cả hai thế hệ hàng Flash đều dùng một định dạng lai sản xuất: các bản ghi chính của V4-Flash là hỗn hợp FP8/BF16 mỗi bản 584 B, với một chỉ mục MXFP4 (một định dạng trong đó cứ 32 giá trị 4-bit dùng chung một hệ số scale); định dạng của V4.1 Flash được mô tả bên dưới. Các con số về V4-Flash ở mục 2.3.3 thay vào đó được tính bằng định dạng tham chiếu BF16, và dưới cùng ngữ cảnh 8K, lịch sử toàn cục của nó là 53,75 MiB (cộng một cửa sổ 5,375 MiB), với một query đọc 27,625 MiB. Con số 27,455 MiB của V4-Flash trong bảng là kích thước thường trú của lịch sử toàn cục theo định dạng sản xuất, và chỉ tình cờ xấp xỉ về mặt số học với khối lượng đọc 27,625 MiB theo định dạng tham chiếu BF16.
Attention lai cũng thêm trạng thái cố định. Dưới điều kiện của chương này là hồi quy FP32 và conv ngắn BF16, ma trận hồi quy cộng các slot conv của Qwen3.5 tổng cộng 184,219 MiB, của Qwen3.6 tổng cộng 61,875 MiB, và của Kimi K3 tổng cộng 433,406 MiB. Những trạng thái cố định này, cùng với cache ngữ cảnh trong bảng, cùng nhau quyết định dấu chân bộ nhớ hiện tại; một bước decode cũng phải đọc và ghi ma trận hồi quy và cập nhật slot conv.
Ngoài việc tiết kiệm trạng thái riêng cho từng layer, trạng thái cũng có thể được dùng chung giữa các layer. Đã lâu rồi, decoder-only vẫn là kiến trúc chủ đạo cho các model ngôn ngữ tổng quát sinh nội dung: xử lý đầu vào và sinh theo từng token dùng cùng các layer backbone, và mỗi layer thường tự tạo KV của mình từ trạng thái ẩn của chính nó. V4.1 Flash đưa ra một điều chỉnh quan trọng cho sự phân công này, tách việc dựng biểu diễn ngữ cảnh khỏi các query kế tiếp, để việc xử lý đầu vào cần ít tính toán backbone hơn nhiều. Báo cáo kỹ thuật gọi thiết kế này là CED, và ghi nhận rằng nó lấy cảm hứng từ cách tiếp cận của YoCo là dùng chung KV giữa các layer.
Ở đây, “encoder phụ trách hiểu, decoder phụ trách sinh” chỉ cụ thể vào những vai trò khác nhau mà hai phần này đảm nhận khi dựng biểu diễn ngữ cảnh so với tính toán để sinh. Encoder tuân thủ ràng buộc nhân quả, và nó không phải là encoder sequence-to-sequence truyền thống có thể truy cập toàn bộ đầu vào theo chiều hai chiều; encoder vẫn cần thiết khi sinh các token mới. Sự bất đối xứng này nằm ở chỗ thông tin được sinh ra ở đâu và mỗi giai đoạn phải thực thi những layer nào, chứ không phải là trao đầu vào và đầu ra cho hai model không bao giờ tham gia tính toán của nhau.
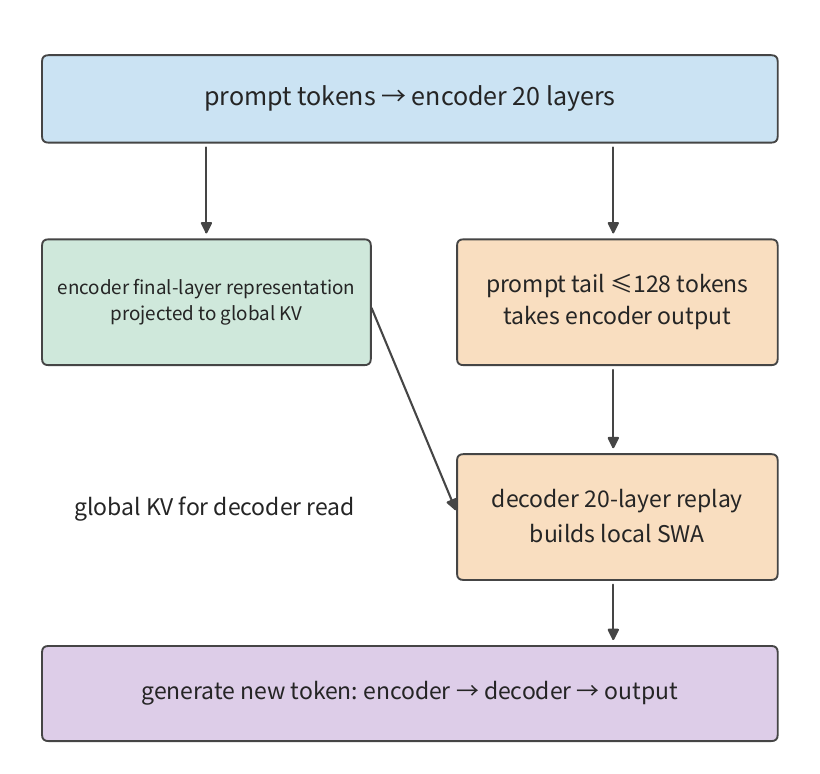
Để hiểu cấu trúc này, trước tiên nên tách “sinh biểu diễn toàn cục” khỏi “truy vấn biểu diễn toàn cục”. CED của V4.1 Flash chia tuần tự backbone văn bản 40 layer thành một encoder nhân quả 20 layer đầu tiên và một decoder 20 layer tiếp theo. Hai phần thuộc cùng một model tự quy hồi, và bên trong encoder, mỗi token chỉ truy cập thông tin tại hoặc trước vị trí hiện tại của nó.
Encoder xử lý đầu vào trước. KV toàn cục mà decoder cần được tạo bằng cách chiếu biểu diễn lớp cuối cùng của encoder, không đòi hỏi mọi đầu vào token đều phải đi qua tất cả các layer decoder trước. SWA cục bộ của mỗi layer decoder vẫn phụ thuộc vào biểu diễn đầu vào của chính layer đó, nên output của encoder cho tối đa 128 token cuối cùng của prompt phải được đưa vào decoder để dựng trạng thái cục bộ — từ đây gọi là replay cửa sổ đuôi (tail-window replay). Một khi quá trình sinh từng token bắt đầu, mỗi token mới đi tuần tự qua cả 40 layer của encoder và decoder. Chương 3 sẽ tính công việc đầu vào này được tiết kiệm bao nhiêu, và chương 8 phân biệt hai kiểu replay của encoder và decoder.
Chi phí của ngữ cảnh dài cũng phụ thuộc vào việc bao nhiêu layer lưu dư thừa cùng một thông tin. Báo cáo kỹ thuật của V4.1 liệt kê trực tiếp dung lượng HBM, SSD và bộ nhớ chủ, cùng băng thông di chuyển KV, làm các ràng buộc thiết kế. V4.1 không tiếp tục tăng tỷ lệ nén chuỗi so với V4: V4 dùng CSA 4:1 và HCA 128:1, còn V4.1 bỏ HCA, nén các mục toàn cục của encoder ở tỷ lệ 2:1 và giữ của decoder ở 1:1. V4.1 thu nhỏ cache chủ yếu qua việc dùng chung giữa các layer và độ chính xác thấp hơn, trong khi vẫn giữ lịch sử theo từng token mịn hơn.
Việc dùng chung cũng làm thay đổi thông tin mà mỗi layer có thể tự chọn. Một layer dùng lại cache không còn tự sinh K/V toàn cục của mình, nhưng mỗi layer vẫn giữ query Q riêng và SWA cục bộ riêng, nên nó có thể tính các trọng số attention khác nhau trên các mục dùng chung, tạo ra output mới. Việc dùng chung cache loại bỏ một loại biểu diễn độc lập theo từng layer, nhưng không biến tính toán của mọi layer thành cùng một phép toán.
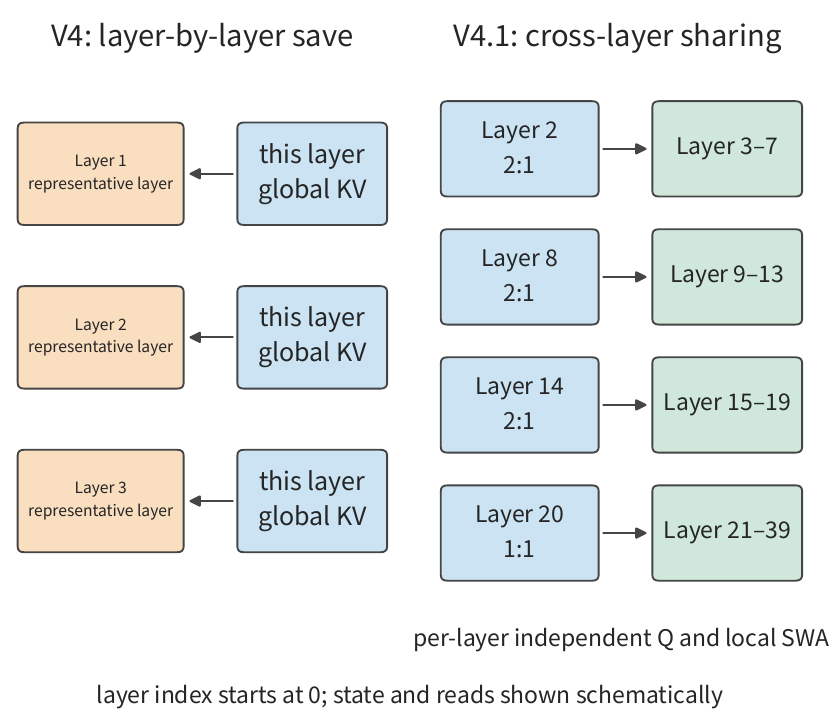
Giờ hãy thay quan hệ dùng chung này vào phép tính dung lượng. DeepSeek V4.1 Flash, phát hành tháng 9 năm 2026, có backbone văn bản 40 layer, nhưng chỉ 4 layer có KV toàn cục độc lập: đánh số bắt đầu từ 0, các layer 2, 8 và 14 mỗi cái tạo một bản ghi nén cho mỗi hai token, layer 20 tạo một bản ghi mỗi token, và tất cả các layer attention toàn cục còn lại dùng chung những cache này. 512 giá trị của một bản ghi chính dùng FP4 (một định dạng dấu chấm động chiếm 4 bit mỗi giá trị), với thêm một byte hệ số scale cho mỗi 16 giá trị, nên mỗi bản ghi chiếm byte; một bản ghi chỉ mục chiếm byte. Mức tăng lưu trữ KV toàn cục trung bình là
Để so sánh, V4-Flash đời trước có 21 layer nén 4:1 và 20 layer nén 128:1. Dùng định dạng của FlashMLA chính thức (thư viện tính toán attention MLA mã nguồn mở của DeepSeek), với bản ghi chính 584 B và bản ghi chỉ mục 68 B, mức tăng lưu trữ KV toàn cục trung bình của nó là
Hai mức tăng KV toàn cục trung bình chênh nhau khoảng 3,95 lần, tương ứng với các giá trị làm tròn 3.514 và 890 B/token trong biểu đồ chính thức. Ngoài cache ngữ cảnh toàn cục, cửa sổ cục bộ của V4.1 giữ tối đa 128 bản ghi mỗi layer, mỗi bản ghi FP8 (một định dạng dấu chấm động chiếm 1 byte mỗi giá trị) + scale chiếm 528 B, tổng cộng 2,578 MiB trên 40 layer. Lịch sử toàn cục tăng theo ngữ cảnh, trong khi dung lượng của cửa sổ cục bộ giữ cố định một khi đã đầy.
Theo dõi quá trình sinh từng bước cũng làm lộ nhịp tăng trưởng của cache toàn cục. Với V4.1, cache toàn cục chỉ tăng 356 B khi đi từ một độ dài chẵn sang độ dài lẻ kế tiếp — đây là đóng góp một bản ghi mỗi token từ layer 20; khi sang độ dài chẵn kế tiếp, ba compressor nén 2:1 ở các layer 2, 8 và 14 mỗi cái hoàn thành thêm một bản ghi, thêm B trong bước đó. Một khi cửa sổ đã đầy, các lần ghi sau ghi đè các slot cũ và dung lượng ngừng tăng, nhưng việc ghi vẫn diễn ra: 40 layer SWA cộng nhau ghi B mỗi bước, với các cập nhật compressor được tính riêng.
Các layer dùng chung một cache toàn cục vẫn cần đọc dữ liệu, và một số layer còn phải chỉ mục lại; dưới kịch bản 8K, dùng định dạng lai sản xuất từ bảng, khối lượng đọc logic attention KV (gồm SWA cục bộ) và chỉ mục cho V4-Flash và V4.1 Flash lần lượt là 12,556 và 11,375 MiB — việc dùng chung giữa các layer chủ yếu giảm không gian dành cho lưu trữ dư thừa.
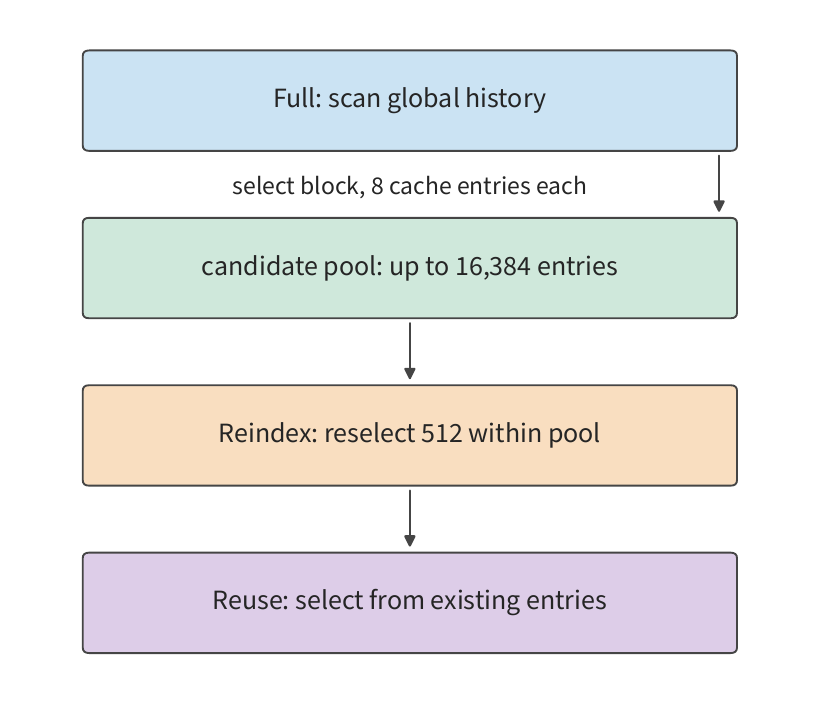
Việc dùng lại cache và chọn lọc mục cũng có thể được sắp xếp độc lập. CSA2 của V4.1 chia các layer thành ba chế độ. Layer Full thực thi toàn bộ pipeline “sinh KV toàn cục, chỉ mục hóa, chọn lọc và attend”. Layer Reindex dùng chung KV nhưng dùng query chỉ mục của riêng nó để chọn lại top-k; layer Reuse dùng lại các mục cache đã chọn nguyên trạng cùng với chính cache đó. Trong số 38 layer attention toàn cục của V4.1, 4 là Full, 4 là Reindex, và 30 là Reuse; thêm hai layer chỉ dùng SWA. Layer Full đầu tiên của decoder quét toàn bộ tập toàn cục và chọn tới mục ứng viên; mục 2.3.2 của báo cáo kỹ thuật gọi tập này là candidate pool (tổ ứng viên), trong đó ứng viên là các mục cache sẵn có để attention truy vấn. Các layer Reindex kế tiếp mỗi cái chọn tối đa 512 mục từ trong pool. Do đó khối lượng tìm kiếm cho các layer sau có cận trên, mặc dù phép quét toàn cục ban đầu vẫn tăng theo ngữ cảnh.
Ví dụ, xét một query đối mặt với 131.072 mục cache toàn cục, được gom thành 16.384 khối, mỗi khối 8 mục. Layer Full đầu tiên của decoder trước tiên chấm điểm tất cả các mục cache, dùng điểm cao nhất trong mỗi khối làm điểm của khối đó, và chọn 2.048 khối, tạo thành 16.384 mục ứng viên. Layer đó sau đó vẫn chọn top-512 từ các điểm số toàn cục; các layer Reindex kế tiếp tính lại điểm trong số các ứng viên bằng một query chỉ mục mới, mỗi layer chọn 512 mục cache. Candidate pool giới hạn phạm vi tìm kiếm cho các layer sau, và top-512 của mỗi layer xác định nó cuối cùng đọc những mục nào.
Candidate pool giới hạn khối lượng tìm kiếm cho các layer sau, nhưng nó cũng có nghĩa là bước sàng lọc ban đầu ảnh hưởng đến việc chọn lọc về sau: một khi một mục cache rơi khỏi candidate pool, các layer Reindex kế tiếp trong query này không thể chọn nó nữa. Huấn luyện model phải thích ứng với phạm vi tìm kiếm này, và Chương 10 giải thích cách V4.1 đưa hạn chế ứng viên này vào post-training.
2.4 Tính toán có điều kiện và tái sử dụng weight chuyên gia
Mục 2.3 đã giảm trạng thái ngữ cảnh qua việc dùng chung, nén và hồi quy. Một nguồn dữ liệu lớn khác là weight model: liệu mỗi token có phải dùng mọi tham số trong model không? Mục này lấy FFN làm điểm xuất phát cho câu hỏi đó.
Một FFN dense áp dụng cùng các ma trận cho mọi token; MoE rải tham số ra nhiều chuyên gia (expert), và một router chọn một số ít chuyên gia cho mỗi token. Cách này cho phép tách riêng việc “model lưu bao nhiêu tham số” và “một token kích hoạt bao nhiêu tham số”, và việc mỗi token chọn gì trong một batch cũng ảnh hưởng đến tập weight thực sự được truy cập.
2.4.1 Mạng feedforward dày đặc và định tuyến chuyên gia
Một nhánh MoE điển hình trước tiên tính các điểm định tuyến từ đầu vào, chọn top-k chuyên gia theo điểm định tuyến, gửi token đến những chuyên gia được chọn, và cuối cùng hợp nhất các output theo trọng số định tuyến. Khi có shared expert, còn có một nhánh mà mọi token đều đi qua. Bản thân các chuyên gia thường vẫn được dựng từ ba ma trận — gate, up và down — để chúng có thể được mở rộng từng ma trận theo phép tính SwiGLU từ mục 2.1.4.
Lấy Qwen3.6-35B-A3B làm ví dụ. Backbone văn bản của nó có 40 layer với chiều ẩn 2048; mỗi layer có 256 routed expert, chọn 8 expert mỗi token, dùng chiều trung gian expert 512, và cũng có shared expert. Một routed expert đơn lẻ có tham số, tương ứng 6 MiB ở BF16. Tất cả routed expert trong một layer chiếm 1,5 GiB, và tám expert được chọn cho một token chiếm 48 MiB.
Giả sử chuyên gia thực sự nhận token; ma trận gate/up của nó là , ma trận down là , và FLOPs ma trận chính là . Cộng đại lượng này trên tất cả chuyên gia cho tổng FLOPs ma trận của mọi routed expert. Router trước tiên quyết định từng ; các expert được chọn thực thi ba phép chiếu, rồi các kết quả được gom và hợp nhất có trọng số; nhánh dùng chung chạy trên mọi hàng đầu vào.
Gọi là tổng số routed expert, là số expert được chọn mỗi token, và là số tham số của một expert. Khi đó mỗi layer lưu tham số routed expert, và công việc ma trận được thực thi mỗi token xấp xỉ . Tăng mở rộng tập tham số có thể chọn; chỉ khi số lượng thực sự được chọn hoặc kích thước expert tăng mới trực tiếp làm tăng tính toán theo token này. Tên “A3B” của Qwen3.6 phản ánh bậc kích hoạt của nó; tổng số tham số toàn văn khoảng 34,66 tỷ, và weight BF16 khoảng 69,321 GB.
2.4.2 FLOPs thực tế và đọc weight theo từng batch
Đại lượng ở mục 2.4.1 chỉ tính công việc chuyên gia của một token duy nhất; khi một batch token được định tuyến cùng nhau, ta cũng cần biết chúng rơi vào bao nhiêu expert khác nhau.
Ví dụ 2-4: Cùng FLOPs chuyên gia, tại sao khối lượng đọc weight lại chênh nhau 32 lần? Với cùng một layer của Qwen3.6, so sánh việc phân phối đều với việc phân phối tập trung.
Giải: Ngay cả khi số tham số được kích hoạt giống nhau, việc đọc weight trong một batch vẫn có thể khác. Giả sử request mỗi cái thực thi một bước decode đồng thời, mỗi request đóng góp một đầu vào token ở bước này, nên . Mỗi token chọn 8 expert, tổng cộng có 512 lượt định tuyến token–expert. Nếu những lượt này trải đều trên 256 expert, mỗi expert trung bình nhận 2 token, và batch hiện tại chạm tới mọi routed expert; nếu mọi token tập trung vào cùng một nhóm 8 expert, mỗi expert nhận 64 token, và batch hiện tại chỉ chạm tám bộ weight expert.
Gọi là số expert khác nhau thực sự được truy cập trong batch này. Nếu không có lượt định tuyến nào đến chuyên gia nào bị loại bỏ trong lúc định tuyến, thì , do đó
Biểu thức đầu cộng dồn theo tổng số hàng được định tuyến; biểu thức thứ hai cộng dồn theo các weight khác nhau thực sự được đọc. Trong ví dụ này, cả hai mẫu định tuyến đều tạo ra 512 lượt định tuyến token–expert; một token được định tuyến tới tám expert chiếm một hàng trong mỗi ma trận đầu vào của tám expert. 512 hàng này đến từ 64 token ban đầu, nên FLOPs ma trận là như nhau; nhưng lần lượt là 256 và 8, cho khối lượng đọc theo layer lần lượt là 1,5 GiB và 48 MiB — chênh nhau 32 lần. Trên cả 40 layer, tất cả routed expert cộng lại lưu 60 GiB, trong khi định tuyến tập trung mỗi batch chỉ chọn 1,875 GiB weight.
| Mẫu định tuyến ở | Số expert khác nhau được truy cập mỗi layer | Số token mỗi expert | Khối lượng đọc routed expert lý tưởng mỗi layer |
|---|---|---|---|
| Phân phối đều | 256 | 2 | 1,5 GiB |
| Phân phối tập trung vào cùng 8 expert | 8 | 64 | 48 MiB |
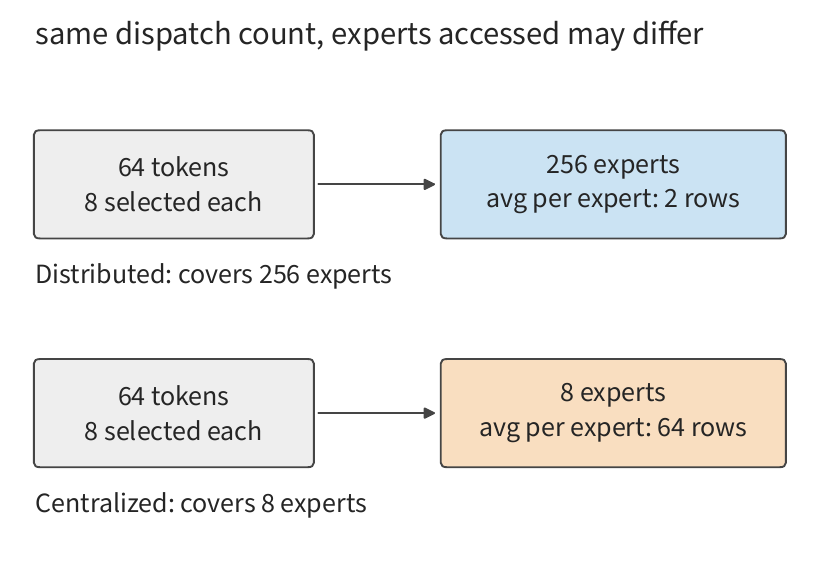
Chênh lệch khối lượng đọc đến từ việc mỗi bộ weight phục vụ bao nhiêu hàng đầu vào: dưới định tuyến đều mỗi expert xử lý hai token, dưới định tuyến tập trung mỗi expert xử lý 64 token. Phép tính thực hiện với cùng một bộ weight tăng lên 32 lần so với lượng ban đầu, trong khi khối lượng truy cập weight lý tưởng giảm còn một phần ba mươi hai. Cùng lúc đó, thay vì thực thi nhiều phép nhân ma trận mà chỉ có hai hàng đầu vào, hệ thống giờ thực thi vài phép nhân ma trận với 64 hàng đầu vào; cả việc tái sử dụng weight lẫn hiệu suất tính toán đều bị ảnh hưởng vì thế.
Cộng theo layer để so sánh toàn model: Qwen3.6, decode với trên ngữ cảnh 8192 token hiện có, cần khoảng 7,33 GFLOPs, ít hơn khoảng 20,0 GFLOPs của Qwen3-8B. Chênh lệch FLOPs toàn model đến từ một số thay đổi cấu trúc: backbone 2048 chiều với các projection được thu nhỏ, 30 layer tuyến tính dùng trạng thái hồi quy, và MoE chỉ thực thi các expert được chọn cộng nhánh dùng chung mỗi lần gọi. Số expert lớn hơn làm tăng tổng số tham số, trong khi công việc mỗi lần gọi phụ thuộc vào những phép toán thực sự được thực thi.
Kích hoạt thưa cho phép tách riêng việc điều chỉnh tổng số tham số và số tham số thực sự dùng mỗi token, để một model truy cập được tập tham số lớn hơn với ít tính toán hơn. Trong quá trình phục vụ, kết quả định tuyến xác định bao nhiêu token dùng lại mỗi bộ weight expert — chính là khác biệt về mẫu truy cập mà Ví dụ 2-4 minh họa.
2.4.3 Shared expert và tính toán không gian tiềm ẩn
Khoảng cách ở trên được quyết định bởi số hàng đầu vào mà một expert nhận. Ta cũng cần xét đến kích thước của chính expert: shared expert xử lý mọi đầu vào, còn các expert không gian tiềm ẩn (latent-space) trước tiên thu nhỏ chiều đầu vào. Cả hai đều thay đổi số weight mà một expert cần và lượng tính toán nó thực hiện.
DeepSeek V4-Flash có 256 routed expert mỗi layer, chọn 6 expert mỗi token, và cũng có 1 shared expert; các routed expert có chiều trung gian 2048. Ma trận gate/up của một expert đơn lẻ là , và ma trận down đưa chiều rộng từ 2048 về lại 4096; ba phép chiếu cộng lại chứa 25.165.824 tham số. Ba layer đầu tiên dùng định tuyến băm (hash routing), các layer sau dùng định tuyến theo điểm: định tuyến băm xác định expert từ chính token, còn định tuyến theo điểm chọn các expert dựa trên biểu diễn hiện tại.
Shared expert xử lý các vector đặc trưng của tất cả token trong bước này, trong khi routed expert chỉ xử lý token được định tuyến đến nó. Nếu shared expert có tham số, FLOPs ma trận expert của một layer bằng . Trong một bước decode đơn lẻ thường lệ, mỗi request đóng góp một token mới, nên ; còn prefill cộng dồn mọi token được xử lý trong bước này trên tất cả request. DeepSeek V4-Flash chọn sáu routed expert mỗi token và thực thi một shared expert, và FLOPs của nó chính xác là tổng của hai phần này; tuy nhiên, dung lượng đòi hỏi phải lưu cả 256 routed expert cộng nhánh dùng chung.
Kimi K3 có 896 routed expert mỗi layer MoE, và mỗi token chọn 16 trong số đó. Đầu vào trước được chiếu từ không gian backbone 7168 chiều sang một không gian latent 3584 chiều, rồi đi qua một biến đổi expert với chiều trung gian 3072, và sau khi hợp nhất lại được chiếu về không gian backbone. Shared expert xử lý trực tiếp biểu diễn backbone. Giảm số chiều thu nhỏ kích thước ma trận của routed expert trong khi thêm hai phép chiếu để vào và ra khỏi không gian latent.
Nếu các expert được phân bổ trên các card khác nhau, các token đầu vào phải được gửi đến card chứa từng expert, và các kết quả phải được hợp nhất lại sau khi expert tính xong. Do đó khối lượng truyền thông phụ thuộc vào chỗ các expert được đặt và chỗ các đầu vào được lưu. Chương 6 bàn về phân vùng nhiều card, và chương 9 giới thiệu placement CPU/GPU cùng tách AF, giao attention và FFN cho các tài nguyên khác nhau.
Bài tập 2-6 [Mở rộng]: Số lượng chuyên gia và mẫu định tuyến ảnh hưởng đến tính toán và việc đọc weight ra sao
Với một layer của Qwen3.6, lấy , 256 routed expert, và 8 expert được chọn mỗi token. Xét cả định tuyến đều và định tuyến tập trung vào cùng nhóm 8 expert, ghi số token nhận được của mỗi expert, rồi tính FLOPs, số expert được truy cập, và khối lượng đọc weight BF16. Tiếp theo, giảm một nửa tổng số expert, nhân đôi chiều trung gian, và giảm một nửa số expert được chọn mỗi token, rồi xác định tổng số tham số expert và FLOPs ma trận expert thực thi có thay đổi không. Cuối cùng, giải thích cách đưa số tham số và FLOPs của shared expert vào phép tính trên; với một model dùng expert không gian latent, cũng giải thích cách tính các phép chiếu vào và ra khỏi không gian latent.
2.5 Hình dạng mạng và tổ chức tính toán
Trạng thái ngữ cảnh và việc chọn expert thay đổi các tập dữ liệu chính liên quan; độ sâu, chiều rộng và cách kết nối của mạng thêm nữa quyết định các ma trận của công việc này lớn cỡ nào và công việc thực thi theo thứ tự nào. Các model có số tham số tương tự vẫn có thể có đồ thị tính toán khác nhau; các model có FLOPs ma trận tương tự vẫn có thể khác nhau về thời gian chiếm buffer và số bước tuần tự.
2.5.1 Độ sâu, chiều rộng và độ mịn chuyên gia
Tạm gác từ vựng và các tham số vector nhỏ sang một bên. Nếu chiều rộng FFN giữ một tỷ lệ cố định với chiều ẩn, số tham số của backbone dense xấp xỉ tỷ lệ thuận với . Giảm một nửa chiều ẩn và tăng gấp bốn số layer có thể giữ số tham số này xấp xỉ như cũ, nhưng độ dài của chuỗi phụ thuộc layer-lớp cũng tăng gấp bốn. Mỗi ma trận nhỏ hơn, nhưng tính toán đi qua nhiều layer hơn; mỗi layer cũng phải tự lưu trạng thái ngữ cảnh của mình. Do đó số layer và chiều rộng thay đổi độ mịn tính toán và độ sâu phụ thuộc trong cùng một ngân sách tham số.
Cấu trúc expert có thể được điều chỉnh tương tự trong khi giữ nguyên số tham số và FLOPs. Tổng tham số routed expert của một layer là , và FLOPs expert mỗi token là . Giảm một nửa số expert , nhân đôi chiều rộng trung gian , và giảm một nửa số được chọn để cả hai đại lượng giữ nguyên. 128 expert chiều rộng 1536, chọn 8 mỗi token, của Qwen3-235B-A22B có thể so sánh với 64 expert chiều rộng 3072, chọn 4 mỗi token. Chiều đầu ra của router và số hàng mỗi expert nhận được vẫn thay đổi, làm thay đổi hình dạng của phép nhân ma trận gom nhóm (grouped matrix multiplication — tổ chức phép nhân ma trận của nhiều expert thành một lần thực thi).
Dùng một ví dụ làm việc để kiểm tra đường cơ sở với hai biến thể. Trong một ví dụ 16 token, cả ba độ mịn expert đều cho cùng FLOPs ma trận expert; cả đường cơ sở lẫn biến thể 64 expert đều khoảng 454 GFLOPs. Giảm một nửa số expert trong khi nhân đôi chiều rộng mỗi expert đóng gói cùng một lượng weight vào ít ma trận lớn hơn; nhân đôi số expert trong khi giảm một nửa chiều rộng thay vào đó tạo ra nhiều ma trận nhỏ hơn. Router phải tính điểm định tuyến cho mọi expert, nên số tham số của nó cũng tỷ lệ với số expert. Mục Expert Granularity Calculation thống kê riêng các ma trận định tuyến và expert, cho thấy tại sao hình dạng ma trận vẫn khác nhau ngay cả khi tổng số tham số expert giống nhau.
Hình dạng của ma trận và trạng thái cũng quyết định đơn vị phân công việc nhỏ nhất cho việc chia việc nhiều card. 128 expert có thể được chia thành tám nhóm, mỗi nhóm 16; bốn KV head, chia theo từng head nguyên vẹn, chỉ tạo được bốn phần, nên thực thi trên tám card đòi hỏi phải nhân bản một phần KV hoặc điều chỉnh việc gom nhóm. Chương 5 phân tích hiệu quả thực thi từ góc tiling ma trận, và chương 6 sẽ giao các ma trận và trạng thái này cho từng card cụ thể.
2.5.2 Kết nối dư và trạng thái xuyên layer
Bên cạnh số layer và chiều rộng, ta cũng cần xem các layer kết nối với nhau ra sao. Kết nối dư (residual connection) cộng trực tiếp đầu vào của sublayer vào kết quả biến đổi, cho thông tin gốc và gradient một đường đi thẳng xuyên qua các layer. Một kết nối dư thường tính , trong đó là biến đổi của sublayer thứ , nên đầu vào phải được giữ trong lúc tính toán sublayer và chỉ được cộng một khi kết quả biến đổi đã được tạo ra. Nếu một số layer kế tiếp vẫn sẽ tham chiếu cùng một biểu diễn, nó phải được giữ đến khi lần dùng cuối kết thúc. Do đó sơ đồ kết nối trực tiếp quyết định những tensor nào cần được giữ đồng thời.
Một kết nối dư thường tiếp tục cộng thông tin từ các độ sâu khác nhau vào cùng một tuyến. Để cho thông tin giữa các layer có thêm cách kết hợp, đồng thời giữ cho việc truyền tín hiệu ổn định trong mạng sâu, DeepSeek V4-Flash dùng mHC (Manifold-Constrained Hyper-Connections — kết nối siêu ràng buộc đa tạp). mHC mở rộng một tuyến dư đơn lẻ thành nhiều tuyến và ràng buộc các hệ số trộn giữa các tuyến; ở đây, “manifold-constrained” cụ thể có nghĩa là các phần tử của ma trận trộn dư bị ràng buộc phải không âm, với tổng mỗi hàng và tổng mỗi cột được giữ gần 1.
Model này giữ trạng thái dư 4 chiều: mỗi chiều là một biểu diễn trung gian 4096 chiều của token hiện tại. Giữ bốn biểu diễn giúp các layer sau học cách kết hợp thông tin từ các tuyến khác nhau. Mỗi sublayer trước tiên trộn bốn biểu diễn thành một đầu vào sublayer 4096 chiều, thực thi attention hoặc FFN, rồi ghi kết quả trở lại các tuyến dư. Do đó các ma trận chính vẫn giữ đầu vào 4096 chiều, và công việc thêm vào tập trung trong các bước trộn và hợp nhất khi vào và ra khỏi sublayer. Trạng thái 4 chiều cho nhiều tập biểu diễn đi qua các layer hơn, và phép trộn buộc những biểu diễn này gắn với kết nối sublayer thường lệ.
Xử lý một đầu vào 8192 token, các phép chiếu trộn của mHC cần khoảng 555 GFLOPs, và các phép toán phi ma trận cần khoảng 149 GFLOPs. Ma trận trộn dư trước tiên được chuẩn hóa bằng vòng lặp Sinkhorn, lần lượt chia mỗi hàng và mỗi cột cho tổng của chính nó, dần đưa tổng các hàng và cột về gần 1; điều này làm cho thang số ổn định hơn qua nhiều lớp trộn. Các hệ số đã chuẩn hóa sau đó được dùng để kết hợp các tuyến dư; ở cuối, các tuyến này được hợp nhất để tạo thành biểu diễn được đưa vào output head từ vựng. Vì vậy kết nối dư nhiều chiều không chỉ thêm các biểu diễn cần lưu, mà còn thêm tính toán trộn và chuẩn hóa ở mỗi layer.
Kimi K3 muốn layer hiện tại có thể chọn thông tin từ các độ sâu khác nhau khi cần, thay vì chỉ nhận một kết quả trộn duy nhất được cộng từng layer. Vì vậy Kimi K3 dùng Attention Residuals (AttnRes — kết nối dư bằng attention), tính các trọng số trên các biểu diễn từ các layer nông hơn và lấy một tổng có trọng số để tạo thành đầu vào của layer hiện tại. Attention này chọn thông tin dọc theo độ sâu mạng, trong khi attention chuỗi ở trước chọn thông tin giữa các token. Để giảm chi phí lưu và đọc output của mọi layer, bản cài đặt theo khối (block-based) gom vài layer thành một khối và giữ các biểu diễn sẵn có cho các khối sau chọn.
Các layer sau vẫn cần dùng những biểu diễn khối này, nên chúng phải được tiếp tục lưu trong suốt forward pass này và có thể được giải phóng khi forward pass kết thúc. KV ngữ cảnh, trái lại, phải được giữ qua các bước sinh kế tiếp. Hai thứ khác nhau ở khoảng thời gian cần được lưu: AttnRes thêm một kho lưu tạm trong một forward pass duy nhất, còn KV tồn tại qua nhiều lần gọi của một request.
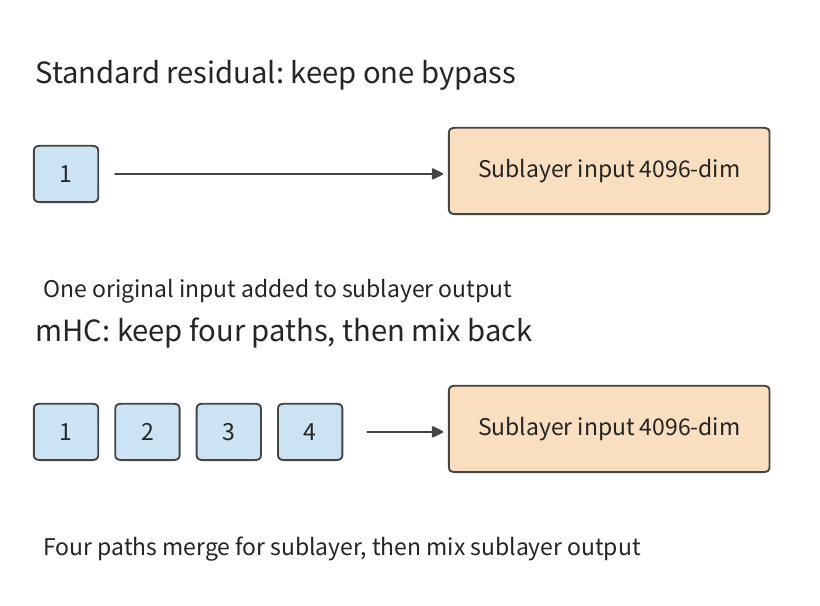
2.5.3 Dự đoán đa token và tính toán phụ trợ
Hai mục trước đã thay đổi hình dạng và kết nối bên trong backbone; một lớp thiết kế khác gắn các module dự đoán ở cuối backbone, thay đổi việc một forward pass có thể tạo ra bao nhiêu token. Một backbone tự quy hồi thường dự đoán token kế tiếp từ ngữ cảnh hiện tại. Multi-Token Prediction (MTP — dự đoán đa token) xây dựng trên đó bằng cách thêm các mục tiêu dự đoán hoặc các module dự đoán phụ trợ cho một số token tiếp theo. Trong huấn luyện, những mục tiêu bổ sung này đẩy biểu diễn hiện tại phải chứa thông tin hữu ích cho nội dung xa hơn; trong suy luận, các module phụ trợ có thể đề xuất trước vài token ứng viên, rồi model chính xác minh, giảm số vòng tuần tự cần thiết để sinh cùng số token đó.
Giải mã suy đoán (speculative decoding) trước tiên sinh các chuỗi ứng viên với chi phí thấp, rồi để model mục tiêu xác minh các ứng viên này. Khi dùng cho giải mã suy đoán, MTP sinh trước các token tiếp theo từ các đặc trưng backbone hiện tại, rồi chuyển chúng cho model mục tiêu xác minh. Nếu nhiều token vượt qua xác minh, một vòng có thể tạo ra nhiều output hợp lệ; ngược lại, quá trình sinh tiếp tục từ vị trí cuối cùng đã vượt qua xác minh. Do đó mức tăng tốc phụ thuộc vào thời gian sinh draft và thời gian xác minh model mục tiêu mỗi cái mất bao lâu, và mỗi vòng có bao nhiêu token vượt qua xác minh. Chương 8 sẽ tính ra quan hệ giữa ba yếu tố này.
Lấy DeepSeek V4-Flash làm ví dụ và tính một vòng dự đoán phụ trợ. Khối MTP phụ trợ của nó nhận đặc trưng backbone và token ID làm đầu vào và dự đoán các vị trí tiếp theo. Với một token đơn lẻ, tức , một lần tính toán phụ trợ cần khoảng 1,80 GFLOPs, trong đó output head từ vựng dùng chung chiếm khoảng 1,06 GFLOPs. Output head từ vựng dùng chung chiếm hơn một nửa số tính toán này: dù nó không thêm weight độc lập, phép chiếu từ vựng vẫn phải chạy trên mỗi lần gọi.
Dự đoán phụ trợ cho phép một forward pass cung cấp nhiều ứng viên, trở thành output hợp lệ sau khi xác minh và lấy mẫu. Chương 3 sẽ tổ chức encode, sinh, lặp và output thời gian thực thành một khối lượng công việc hoàn chỉnh.
Gọi là thời gian của một bước decode thường, và gọi là tổng thời gian draft và xác minh cho một vòng giải mã suy đoán, cho trung bình output hợp lệ. Thời gian khấu hao mỗi output là , và điều kiện có lợi là
Ví dụ, nếu decode thường mất 20 ms, draft cộng xác minh cùng mất 30 ms, và trung bình mỗi vòng thu được hai output hợp lệ, thời gian khấu hao mỗi output là 15 ms; nếu chỉ thu được một, thì mất 30 ms. Dự đoán thêm vài vị trí làm tăng công việc của một vòng, và chỉ khi đủ nhiều output được chấp nhận thì chi phí tính toán thêm này mới được bù lại.
2.6 Yêu cầu tài nguyên toàn model và so sánh
Mục 2.3 đến 2.5 đã giới thiệu ba loại thay đổi cấu trúc: biểu diễn ngữ cảnh quyết định kích thước trạng thái và mẫu truy cập, việc chọn expert quyết định những weight nào được dùng trong mỗi lần gọi, và độ sâu cùng kết nối mạng quyết định thứ tự tính toán. Mục này gom các phần lại với nhau, so sánh FLOPs và nhu cầu lưu trữ của các model hoàn chỉnh dưới cùng điều kiện đầu vào, rồi kiểm tra output model bằng những tác vụ cụ thể.
2.6.1 Yêu cầu tài nguyên của từng thành phần và tổng kết toàn model
Cấu trúc attention và cấu hình expert của năm model. Chương này chọn một baseline dense và bốn model MoE khác biệt về cấu trúc, so sánh nhu cầu tài nguyên của chúng bằng một bộ quy tắc ma trận nhất quán. Trong Bảng 2-A, hậu tố T trên số tham số biểu thị nghìn tỷ (trillions).
Bảng 2-A Kiến trúc tổng thể của năm model (thành phần văn bản)
| Tham số kiến trúc | DeepSeek V4.1 Flash | Qwen3-8B | Qwen3.6-35B-A3B | DeepSeek V4-Flash | Kimi K3 |
|---|---|---|---|---|---|
| Tổng tham số logic, xấp xỉ | 551,57B + 196,93B Engram | 8,19B | 34,66B | 284,33B | 2,78T |
| Layer backbone | 40 (20+20) | 36 | 40 | 43 | 93 |
| Chiều ẩn backbone | 5120 | 4096 | 2048 | 4096 | 7168 |
| Thành phần attention | 2 SWA + 38 CSA2 | 36 GQA | 30 linear + 10 full attention | 2 window + 21 CSA + 20 HCA | 69 KDA + 24 MLA |
| Thành phần feedforward | 40 layer MoE | SwiGLU dense | 40 layer MoE | 43 layer MoE | 1 layer dense + 92 layer MoE |
| Routed expert mỗi layer MoE | 384 | — | 256 | 256 | 896 |
| Số được chọn mỗi token | 6 | — | 8 | 6 | 16 |
| Chiều rộng tính toán routed expert | 5120 | — | 2048 | 4096 | 3584 |
| Chiều trung gian FFN dense / routed expert | 2304 | 12288 | 512 | 2048 | 3072 |
| Chiều trung gian shared expert | 2304 | — | 512 | 2048 | tổng 6144 |
| Kết nối xuyên layer | Single-Pass mHC, 4 chiều | Kết nối dư thường | Kết nối dư thường | mHC, 4 chiều | AttnRes |
Bảng liệt kê thành phần văn bản của năm model. Khoảng 551,57B tham số backbone và 196,93B tham số Engram của V4.1 Flash được liệt kê riêng; cái sau gồm khoảng 196,61B tham số bảng tra cứu cộng tham số projection và gating của chúng, và cả hai được tính chung vào tổng weight toàn văn ở phần sau. Single-Pass mHC của V4.1 là một cải tiến so với mHC: mỗi layer dùng lại các hệ số trộn đầu vào do layer trước tính, nên trạng thái dư chỉ cần được đọc một lần. Kimi K3 dùng cấu trúc feedforward khác nhau cho các layer khác nhau: layer đầu tiên là một FFN dense với chiều trung gian , trong khi các layer sau dùng routed expert với chiều trung gian . Một layer dense gửi mọi token qua cùng một bộ ma trận rộng, còn một layer MoE gửi mỗi token qua vài ma trận expert hẹp hơn.
Các giai đoạn thực thi của V4.1 Flash như sau: 40 layer chia thành 20 layer encoder nhân quả và 20 layer decoder, và chỉ các layer 2, 8, 14 và 20 lưu KV toàn cục độc lập, trong khi các layer 2, 8, 14, 20, 24, 28, 32 và 36 chạy indexer, với đánh số layer bắt đầu từ không. Layer Full sinh cache và chỉ mục, layer Reindex tính lại chỉ mục, và layer Reuse dùng lại một lựa chọn hiện có; mọi layer vẫn tự lưu cửa sổ cục bộ của mình. Vì vậy số layer không còn bằng số cache toàn cục độc lập, và độ dài đầu vào không còn bằng số token query thực sự được xử lý ở mỗi layer.
Bảng làm lộ ra ba mối quan hệ. Qwen3.6 có nhiều tổng tham số hơn Qwen3-8B, vậy mà backbone của nó chỉ rộng một nửa: nó đặt một lượng lớn tham số vào các expert có thể chọn, mỗi token chỉ gọi tám trong số chúng. Qwen3-8B và DeepSeek V4-Flash dùng chung backbone 4096 chiều, và DeepSeek V4-Flash tạo một tập tham số lớn hơn nhiều qua 256 expert mỗi layer. Kimi K3 đưa tính toán expert vào một không gian latent 3584 chiều, để đầu vào expert không cần chia sẻ chiều rộng của backbone. Những khác biệt này cho thấy “model lưu to cỡ nào” và “một token thực hiện bao nhiêu công việc” phải được tính riêng. Các Bảng 2-1, 2-2, 2-4, 2-5 và 2-6 sẽ phát triển lần lượt từng model trong năm model này, với Bảng 2-3 của DeepSeek-V3 làm tài liệu tham chiếu lịch sử cho MLA.
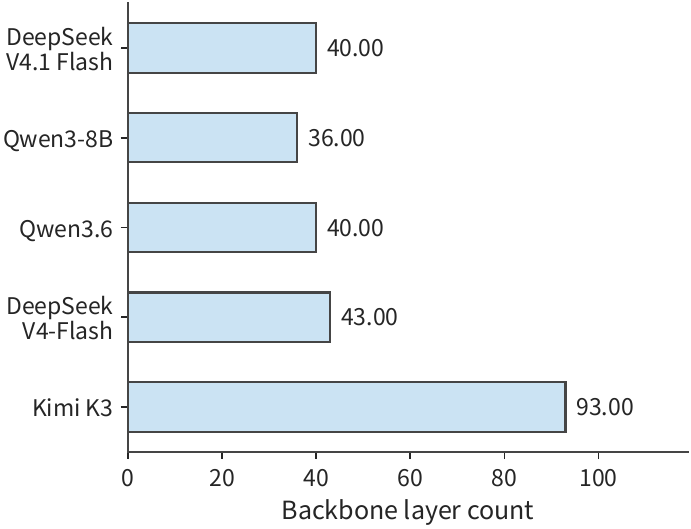
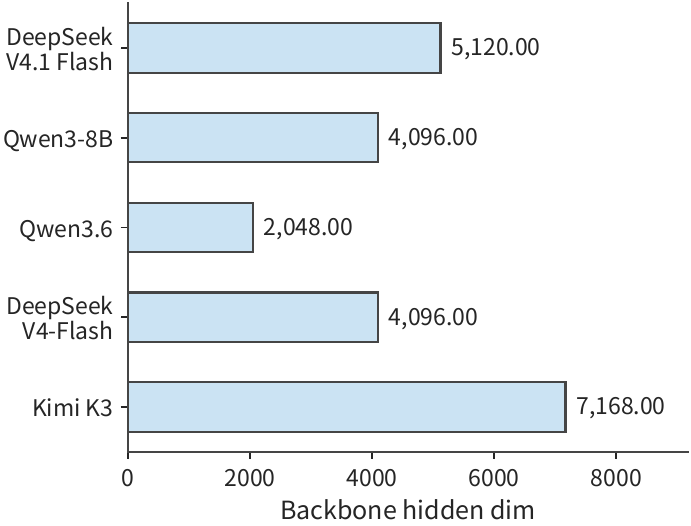
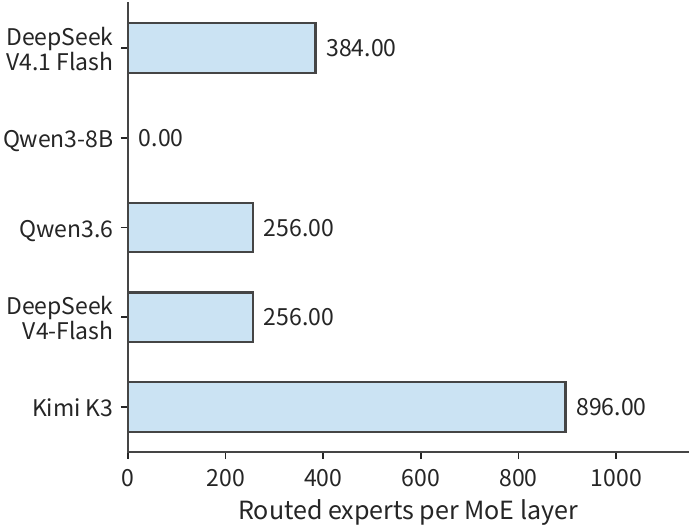
Khi đã có tham số của một loại layer, FLOPs một lần gọi, và trạng thái của một request, toàn model chỉ cần cộng các thuật ngữ này có trọng số theo số layer thực tế của từng loại:
Ở đây chỉ một loại layer của model, trong đó các layer cùng loại dùng chung cấu trúc attention, feedforward và kết nối; là số layer thuộc loại . của MoE bao gồm mọi expert, trong khi dùng số hàng mà mỗi expert thực sự nhận được. Bảng 2-1 đã thiết lập baseline dense cho Qwen3-8B; các bảng tham chiếu ở cuối chương phát triển Qwen3.6, DeepSeek-V3, DeepSeek V4-Flash, Kimi K3 và DeepSeek V4.1 Flash theo cùng cách, để độc giả có thể lần theo chính xác ma trận nào tương ứng với từng thuật ngữ trong tổng.
Khi đọc những bảng này, nên lần theo dòng dữ liệu từng bước: đầu vào đi vào loại layer attention nào, rồi qua loại mạng feedforward nào, và cuối cùng các điểm số từ vựng được lấy ra sao; phép cộng cũng phải gồm tra cứu hàng embedding, chuẩn hóa cuối cùng và output head từ vựng. Mỗi bảng gom các hàng theo attention, feedforward và kết nối, và giao diện đầu ra; “layer/lần gọi” cho hệ số nhân tích lũy trên toàn model, và “FLOPs ma trận” vẫn là số phép toán dấu chấm động cho một lần thực thi duy nhất phép toán của hàng đó.
Áp cùng quy tắc cộng dồn cho các model khác, ta có thể liệt kê từng nhánh tính toán của mỗi model. Bảng dưới liệt kê theo model: trạng thái ngữ cảnh, weight và tính toán bổ sung cần cộng dồn, cùng những phần dễ bị bỏ sót nhất khi tính tổng; MTP, DSpark (module giải mã suy đoán của V4.1) và module vision được cộng riêng theo phạm vi thực thi của chúng trong lần gọi này.
| Nhánh model | Trạng thái ngữ cảnh | Weight và tính toán bổ sung | Những phần dễ bị bỏ sót nhất khi tính tổng |
|---|---|---|---|
| DeepSeek V4.1 Flash | 4 KV/chỉ mục toàn cục dùng chung + SWA theo layer + buffer nén và lịch sử token | CED, CSA2, Engram, expert, Single-Pass mHC | Toàn bộ đầu vào của encoder, replay đuôi của decoder, và số vị trí khác nhau của các projection toàn cục |
| Qwen3-8B | KV GQA | SwiGLU dense, output head | Phép toán phi ma trận, phạm vi vị trí của output head |
| Qwen3.6 | KV toàn cục + trạng thái hồi quy và convolution | Routed/shared expert | Các linear layer lưu trạng thái hồi quy kích thước cố định |
| DeepSeek-V3 | Biến latent MLA hoặc KV unrolled, tùy đường thực thi | Ba layer FFN dense đầu tiên, các MoE sau và shared expert | Vị trí thực thi của phép chiếu lên, sự khác biệt giữa hai đường cache |
| DeepSeek V4-Flash | Cửa sổ + nén + chỉ mục + buffer | Expert, compressor, mHC | Quét chỉ mục, cập nhật biên khối, nhánh dùng chung |
| Kimi K3 | MLA + KDA + convolution | Expert không gian latent, AttnRes | Đường unrolled, trạng thái tạm xuyên layer, khác biệt của layer đầu tiên |
So sánh lần lượt toàn bộ weight, FLOPs một bước và kích thước trạng thái ngữ cảnh mỗi request, rồi dùng các bảng phân rã theo model để giải thích mỗi khác biệt đến từ ma trận và trạng thái nào.
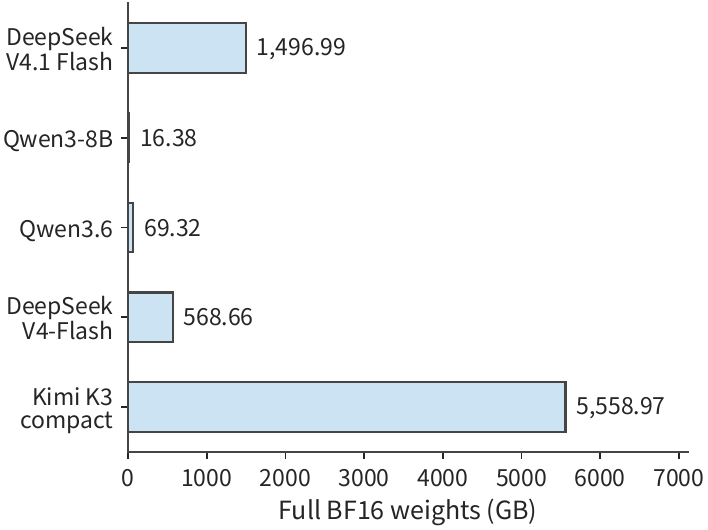
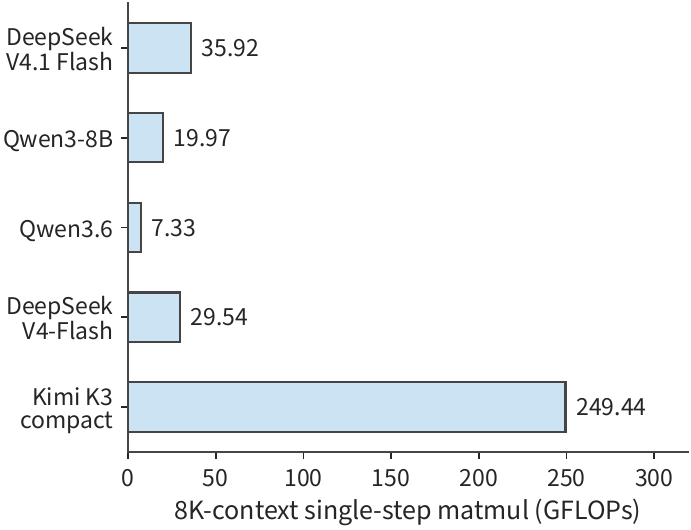
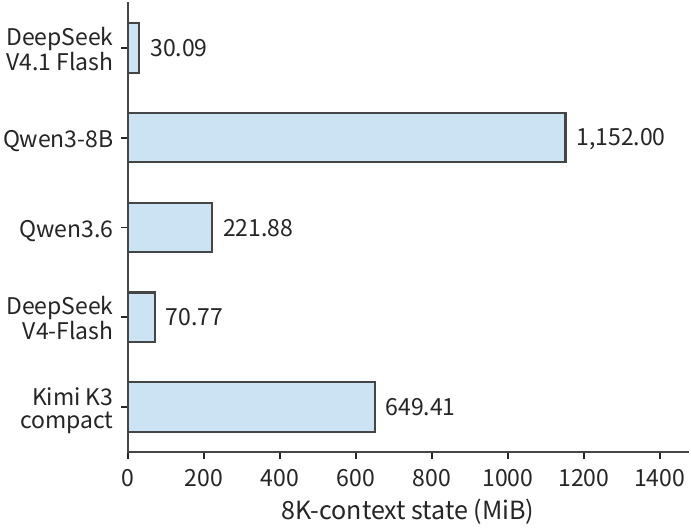
Các phân rã theo từng ma trận của năm model xuất hiện trong Bảng tham chiếu ma trận model ở cuối chương. Các tổng phân rã dưới đây giải thích nguồn của những khác biệt tài nguyên.
Nhân các kích thước ma trận và cộng dồn theo số layer, backbone của DeepSeek V4-Flash có khoảng 284,3 tỷ tham số logic, chiếm khoảng 568,7 GB khi quy đồng BF16.
Backbone văn bản của Kimi K3 có khoảng 2,78 nghìn tỷ tham số, tuyệt đại đa số nằm trong các routed expert của 92 layer MoE của nó. Mỗi token chỉ chọn 16 expert mỗi layer, nên dung lượng lưu trữ của toàn model và FLOPs của một token phụ thuộc vào những yếu tố khác nhau: cái trước do tất cả expert quyết định, còn cái sau do các expert được chọn cùng với attention, shared expert và các projection thực thi song song với chúng quyết định.
Dưới đây, tham số của mỗi model được chia thành sáu loại loại trừ lẫn nhau: embedding và output, projection attention, FFN dense hoặc dùng chung, routed expert, Engram và các thành phần khác. Cộng các loại này lại cho tổng số tham số của model, và quy đổi 2 byte mỗi tham số cho dung lượng weight trong Hình 2-28. Cách phân rã này cho thấy rõ sự phân bố tham số và cũng là nền cho bảng kế tiếp.
Bảng 2-B Tham số gồm những gì (đơn vị: tỷ tham số logic)
| Model | Embedding và output head | Projection attention | FFN dense/dùng chung | Routed expert | Engram | Khác |
|---|---|---|---|---|---|---|
| DeepSeek V4.1 Flash | 1,324 | 5,126 | 1,416 | 543,582 | 196,929 | 0,118 |
| Qwen3-8B | 1,245 | 1,510 | 5,436 | 0,000 | 0,000 | |
| Qwen3.6 | 1,017 | 1,283 | 0,126 | 32,212 | 0,000 | 0,022 |
| DeepSeek V4-Flash | 1,059 | 5,085 | 1,082 | 277,025 | 0,000 | 0,081 |
| Kimi K3 (MLA nén) | 2,349 | 36,180 | 12,882 | 2722,741 | 0,000 | 5,333 |
Các thành phần khác gồm router, projection vào/ra của không gian latent, chuẩn hóa, convolution và các kết nối; projection attention gồm cả các projection nén và chỉ mục của DeepSeek V4-Flash. Qwen3-8B dồn các tham số chính vào FFN dense được thực thi cho mọi token, còn Qwen3.6, V4-Flash và Kimi K3 đặt phần lớn tham số vào routed expert. V4.1 Flash cũng lưu một bảng Engram lớn hơn, với các tham số tra cứu, projection và gating được liệt kê riêng trong bảng; các tham số tra cứu làm tăng dung lượng toàn model nhưng không có nghĩa mỗi token phải đi qua toàn bộ bảng. Routed expert của Qwen3.6 chiếm khoảng 93%, trong khi DeepSeek V4-Flash và Kimi K3 ở mức khoảng 97%–98%. Vì vậy tổng dung lượng của ba model này chủ yếu do tập expert quyết định, còn tính toán expert theo token phụ thuộc vào những expert được chọn tại từng layer.
Bảng 2-C Tính toán prefill và weight expert được chọn dưới điều kiện đầu vào giống nhau
| Model | Prefill 8K (TFLOPs) | Weight BF16 của routed expert được chọn mỗi token (GiB) |
|---|---|---|
| DeepSeek V4.1 Flash | 143,95 | 15,820 |
| Qwen3-8B | 133,59 | — |
| Qwen3.6 | 52,09 | 1,875 |
| DeepSeek V4-Flash | 231,13 | 12,094 |
| Kimi K3 (MLA nén) | 1863,46 | 90,562 |
Cả hai lần gọi đều lấy ; prefill là , decode là , và output head từ vựng trong cả hai trường hợp chỉ xử lý token cuối cùng; phép tính ma trận mỗi bước trong Hình 2-29 được cộng dồn dưới cùng bộ điều kiện này. Trạng thái trong Hình 2-30 là không gian cần để giữ 8192 token ngữ cảnh: biểu diễn ngữ cảnh dùng BF16, còn trạng thái hồi quy và buffer nén dùng FP32 theo từng bản cài đặt. V4.1 Flash cũng gồm cache lịch sử token int64 (số nguyên 64-bit) từ bản tham chiếu, được Engram dùng để dựng các n-gram xuyên lần gọi; dung lượng của cache toàn cục FP4 và cửa sổ FP8 trong bản sản xuất được nêu ở mục 2.3.6. Cột cuối của bảng cộng weight routed expert mà một token chọn được trên tất cả các layer, rồi chuyển sang byte dùng BF16. So sánh bảng này với Hình 2-28 đến 2-30 cho phép so sánh riêng không gian mà toàn model chiếm, tính toán của một lần gọi, và không gian mà ngữ cảnh của request chiếm.
Mỗi model cộng dồn dọc theo đường thực thi của riêng nó: V4.1 Flash dùng CED từ bài báo cộng replay cửa sổ đuôi với việc chỉ mục bị giới hạn trong tập ứng viên; Qwen3-8B dùng attention nhân quả hiệu lực; Qwen3.6 dùng một bản cài đặt attention hình chữ nhật eager theo từng mục cộng một nhánh linear chia khối; DeepSeek V4-Flash dùng attention chính hiệu lực cộng chỉ mục tham chiếu; Kimi K3 dùng MLA nén cộng KDA chia khối. So sánh Hình 2-28 đến 2-30: Qwen3.6 lưu weight gấp khoảng bốn lần Qwen3-8B nhưng lại có ít phép toán ma trận mỗi bước hơn; weight của DeepSeek V4-Flash tăng thêm, vậy mà trạng thái 8K của nó thực tế lại thu nhỏ nhờ nén và chọn lọc; Kimi K3 có nhiều expert hơn, chiều ẩn lớn hơn và nhiều layer hơn, nên phải lưu nhiều weight hơn và thực hiện nhiều phép toán hơn. Những khác biệt này cho thấy tổng số tham số, tính toán mỗi lần gọi và kích thước trạng thái ngữ cảnh mỗi cái phải được tính từ cấu trúc tương ứng của riêng nó.
Suy ra khối lượng đọc mỗi bước từ kích thước trạng thái ngữ cảnh. Qwen3-8B dùng 1152 MiB KV cũ mỗi bước; dưới định dạng tham chiếu BF16 dùng trong Hình 2-30, tổng đọc attention chính cộng quét chỉ mục của DeepSeek V4-Flash là 27,625 MiB, và nó cũng cập nhật compressor; chuyển sang định dạng lai sản xuất từ mục 2.3.6 giảm con số này còn 12,556 MiB. MLA nén của Kimi K3 dùng 216 MiB trạng thái ngữ cảnh, và ma trận hồi quy 414 MiB của nó phải được cả đọc lẫn ghi mỗi bước, cho tổng khối lượng đọc–ghi 828 MiB; các con số tương ứng của Qwen3.6 là 160 MiB cho cache KV attention toàn cục và 120 MiB đọc–ghi cho ma trận hồi quy. Trạng thái hồi quy phải được đọc ra và cập nhật mỗi bước, còn biểu diễn ngữ cảnh phải phục vụ query hiện tại. Vì vậy ngay cả khi kích thước trạng thái cố định, vẫn có một chi phí đọc–ghi tương ứng ở mỗi bước.
Mã hóa lượng tử và metadata cùng nhau quyết định dung lượng weight. Khi tính đồng nhất ở BF16, mỗi tham số chiếm 2 byte, nên kích thước weight phản ánh trực tiếp khác biệt về số tham số. Các checkpoint model thực tế được phát hành (các tệp giữ tham số đã lưu) dùng định dạng lưu trữ riêng của chúng: backbone của DeepSeek V4-Flash khoảng 156,02 GB, và model văn bản của Kimi K3 khoảng 1559,97 GB. Kích thước tệp do các ma trận bit thấp, các tham số giữ độ chính xác cao hơn và metadata định dạng cùng nhau quyết định; độ chính xác đồng nhất phản ánh quy mô tham số, còn kích thước tệp phản ánh số byte thực tế mà các tham số này chiếm. Sau khi model được nạp, phải cấp thêm không gian cho việc chuyển đổi định dạng và tính toán. Chương 5 sẽ phân tích việc định dạng lưu trữ và cách cài đặt runtime ảnh hưởng đến dấu chân GPU memory như thế nào.
Khi so hai bảng, cũng chú ý sự phân công việc giữa các giai đoạn của V4.1 Flash. Toàn bộ weight văn bản của V4.1 gồm Engram; toàn bộ tính toán ma trận của prefill gồm encoder, projection KV toàn cục của decoder, replay cửa sổ đuôi và output head. Khi sinh một token mới, cả hai phần của mạng đều phải thực thi, nên tỷ lệ tiết kiệm của prefill không thể áp thẳng cho decode.
Thành phần tham số trong Bảng 2-B giải thích dung lượng weight, còn Bảng 2-C cho thấy các tham số này tham gia một lần gọi như thế nào. Kết hợp lại, chúng cho phép phân biệt “cần bao nhiêu không gian để lưu toàn model” khỏi “xử lý một token dùng bao nhiêu tài nguyên”.
Trong Bảng 2-C, prefill 8K của V4.1 Flash chỉ cần 143,95 TFLOPs. Bảng 2-D phân rã phép tính này theo giai đoạn thực thi và so với một forward đủ layer tham chiếu.
Bảng 2-D Cách đầu vào 8K của V4.1 Flash phân bổ qua các giai đoạn thực thi (TFLOPs)
| Giai đoạn | Forward đủ layer tham chiếu | CED + replay cửa sổ đuôi |
|---|---|---|
| Encoder 20 layer | 142,139 | 141,727 |
| Projection KV toàn cục dùng chung và index-key của decoder | 0,044 | 0,044 |
| Tính toán query, feedforward, v.v. của decoder 20 layer | 140,202 | 2,175 |
| Output head từ vựng cho token đuôi | 0,001 | 0,001 |
| Tổng | 282,386 | 143,947 |
| Tổng | 282,386 | 143,947 |
Đường tham chiếu thực thi cả 40 layer trên toàn bộ 8192 token, và theo bản cài đặt công khai, trước tiên tính các điểm số chỉ mục hình chữ nhật đầy đủ rồi mới mask chúng; trong đường CED, encoder xử lý toàn bộ đầu vào, KV toàn cục và key chỉ mục của decoder vẫn được tạo cho toàn bộ đầu vào, nhưng thân decoder chỉ xử lý 128 token cuối cùng, và việc chỉ mục sau đó bị giới hạn trong tập ứng viên. Bảng gồm toàn bộ công việc ma trận văn bản của mỗi đường; sự khác biệt đến từ cả số vị trí thực thi lẫn thuật toán chỉ mục.
Cả hai đường đều gồm attention, điểm định tuyến, routed và shared expert, các phép chiếu Engram, các phép chiếu Single-Pass mHC và output head từ vựng. Tách projection toàn cục của decoder khỏi tính toán query của nó cho thấy CED rút ngắn chuỗi tính toán mà một prompt dài phải đi qua như thế nào.
Tính toán và tăng trưởng trạng thái khi ngữ cảnh tăng từ 8K lên 1M. Các tác vụ hỏi đáp tài liệu dài và nhiều lượt làm tăng chi phí truy cập ngữ cảnh. Dưới đây ta cố định một request đơn lẻ, mỗi lần thêm một token mới, và output head từ vựng cho token đuôi. Kịch bản 8K có 8192 token lịch sử; kịch bản 1M có 1.048.575 token lịch sử, cộng query hiện tại, tròn 1.048.576 vị trí hiển thị.
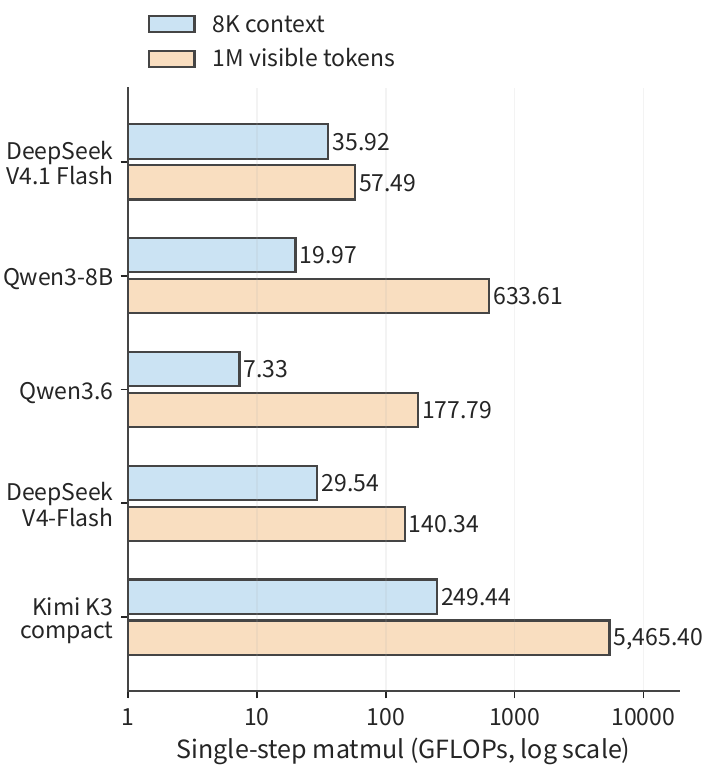
Bảng 2-E thống kê riêng việc chấm điểm attention và tổng hợp value cho riêng query hiện tại; V4-Flash và V4.1 Flash còn cộng thêm các tích vô hướng chỉ mục. Cột trạng thái liệt kê ngữ cảnh và trạng thái cố định có mặt trước lần gọi, với độ chính xác nhất quán với Hình 2-30. Các cấu hình công bố của Qwen3-8B và Qwen3.6 hỗ trợ lần lượt 40.960 và 262.144 vị trí; các hàng 1M của cả hai được ngoại suy dưới cùng cấu trúc, để so sánh mẫu tăng trưởng.
Bảng 2-E Tính toán tương tác và dung lượng trạng thái dưới ngữ cảnh dài
| Model | Tương tác ngữ cảnh 8K (GFLOPs) | Tương tác ngữ cảnh 1M (GFLOPs) | Trạng thái 8K (GiB) | Trạng thái 1M (GiB) |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | 3.66 | 25.23 | 0.029 | 3.138 |
| Qwen3-8B | 4.83 | 618.48 | 1.125 | 144.000 |
| Qwen3.6 | 1.34 | 171.80 | 0.217 | 20.060 |
| DeepSeek V4-Flash | 3.00 | 113.80 | 0.069 | 6.735 |
| Kimi K3 (MLA nén) | 41.08 | 5257.04 | 0.634 | 27.423 |
KV toàn cục của V4.1 Flash chỉ có bốn nguồn độc lập, nên ngữ cảnh lớn dần không thêm một bản sao theo từng layer trên cả 40 layer. Attention chính dùng tối đa 128 token cục bộ và 512 mục toàn cục mỗi layer; layer Full đầu tiên của decoder tạo tập ứng viên, và bốn layer Reindex kế tiếp mỗi cái quét tối đa 16384 mục ứng viên. Ba indexer của encoder và indexer đầu tiên của decoder vẫn phải quét lịch sử toàn cục đang lớn dần, nên tính toán của chúng tiếp tục tăng; việc dùng chung giữa các layer và chỉ mục phân tầng làm thay đổi tốc độ tăng trưởng. Ở 1M, tương tác ngữ cảnh của nó là 25,23 GFLOPs, và toàn bộ công việc ma trận mỗi bước là 57,49 GFLOPs.
V4-Flash áp dụng CSA và HCA ở hai độ mịn nén của chúng: mức trần chọn mục của attention chính CSA giữ cố định, nhưng quét chỉ mục của nó tăng theo lịch sử; HCA đọc tất cả các mục thô ráp đã hoàn chỉnh. Ở 1M, tương tác ngữ cảnh của nó là 113,80 GFLOPs, và toàn bộ công việc ma trận mỗi bước là 140,34 GFLOPs. Ở ngữ cảnh ngắn hơn, backbone lớn hơn của V4.1 Flash thêm nhiều projection và tính toán expert hơn; chỉ khi lịch sử đủ dài, số indexer ít hơn và chọn mục ứng viên phân tầng của nó mới bù được công việc thêm này.
69 layer KDA của Kimi K3 giữ trạng thái hồi quy cố định, trong khi 24 layer MLA của nó tiếp tục truy cập lịch sử tăng theo ngữ cảnh. MLA nén giảm dung lượng cache nhưng không loại bỏ tính toán giữa query và các token lịch sử; ở 1M, tương tác này đạt 5257,04 GFLOPs, và toàn model đạt 5465,40 GFLOPs. Đánh giá các thiết kế ngữ cảnh dài đòi hỏi kiểm tra riêng lẻ bao nhiêu trạng thái được giữ, những vị trí nào được truy cập, và bao nhiêu công việc thêm được thêm vào cho việc chỉ mục hóa và cập nhật trạng thái.
Tính toán thống nhất cũng giữ một kịch bản 200K: toàn bộ công việc ma trận mỗi bước của V4.1 Flash là 40,21 GFLOPs, và của V4-Flash là 50,48 GFLOPs. Đến 1M, khoảng cách giữa hai model càng nới rộng, đó là lý do văn bản chính dùng 1M để cho thấy giá trị thiết kế của việc xử lý ngữ cảnh dài.
2.6.2 Quy mô tham số, độ chính xác số học và các ràng buộc dung lượng
Đưa weight model và trạng thái mỗi request thu được từ việc tính liệt kê vào cùng một bảng dung lượng GPU memory cho phép ta xác định một card chứa được bao nhiêu request đồng thời, và lượng tử hóa weight giải phóng được bao nhiêu không gian.
Với một card cho trước, trước tiên trừ weight, workspace và các không gian cố định dành riêng khác khỏi tổng dung lượng; chỉ phần không gian còn lại mới có thể chứa trạng thái request. Trong trường hợp đơn giản hóa khi các request bằng độ dài và mỗi cái độc lập lưu KV của riêng mình, điều này có thể viết thành:
Tử số là không gian khả dụng cho các request sau khi trừ dữ liệu cố định thường trú; mẫu số là kích thước trạng thái mỗi request. Mỗi request thêm yêu cầu cấp một lượng không gian trạng thái tương ứng; khi phần không gian còn lại không đủ chứa một trạng thái hoàn chỉnh, không thể thêm request nào nữa, nên kết quả phải được làm tròn xuống. Trạng thái hồi quy và convolution cũng được tính là dữ liệu theo request và nằm trong mẫu số cùng với KV.
Lấy ví dụ chạy Qwen3-8B BF16 trên RTX 4090 24 GB: weight chiếm byte, workspace dành 2 GiB, và ngữ cảnh 8K của mỗi request chiếm 1,125 GiB. Số request vừa được là
Ở ngữ cảnh 16K, mỗi request chiếm 2,25 GiB, và cùng không gian chỉ vừa được hai; ở 4K, vừa được chín. Số request nhảy theo bước số nguyên vì không gian còn lại phải chứa trạng thái hoàn chỉnh của một request — giữ một trạng thái một phần là vô nghĩa.
Việc giữ lại bao nhiêu lịch sử do đó trở thành một quyết định ảnh hưởng đến cả ứng dụng lẫn hệ thống. Nếu ứng dụng giữ nhiều tài liệu hơn, model có thể tiếp tục tham chiếu chúng; nhưng dịch vụ khi đó phải cấp nhiều không gian trạng thái hơn mỗi request. Các biểu diễn GQA, MLA và hồi quy từ mục 2.3 còn thay đổi cách thông tin này được lưu. Cấu trúc model, tổ chức ngữ cảnh và năng lực đồng thời có thể được so sánh trong cùng một ngân sách, rồi được kiểm chứng với các tác vụ thực tế để xác định sơ đồ nào đạt được chất lượng trả lời cần thiết.
Về việc lượng tử hóa giải phóng được bao nhiêu không gian, lấy model lớn hơn DeepSeek-R1-Distill-Llama-70B làm ví dụ. Mục 1.2.3 đã cho weight BF16 của model này là 141,107 GB, weight lượng tử hóa nhóm 8-bit là 73,726 GB, và KV BF16 8192 token của một request là 2,5 GiB. Dưới cùng sơ đồ gom nhóm, giữ embedding, output head và chuẩn hóa ở độ chính xác cao hơn, và tính cả không gian cho các hệ số scale và phần đệm cuối từ việc đóng gói, một sơ đồ 4-bit đạt khoảng 39,500 GB.
39,500 GB của sơ đồ 4-bit gồm các ma trận bit thấp, các tham số vẫn giữ độ chính xác cao, và chi phí của scale cùng đóng gói, và lớn hơn kết quả của việc đơn giản quy đổi mọi tham số thành nửa byte. Trên H100 SXM với 80 GB (thập phân) bộ nhớ và một phần dành riêng cố định 2 GiB, sơ đồ 8-bit vừa được 1 request 8K, và sơ đồ 4-bit vừa được 14. Khi ngữ cảnh tăng từ 8K lên 32K, KV mỗi request gấp bốn, và số request mà sơ đồ 4-bit giữ đồng thời được giảm còn 3. Nén weight giải phóng không gian để chứa ngữ cảnh của nhiều request hơn, nhưng mỗi ngữ cảnh càng dài thì càng ít request được chứa cùng lúc.
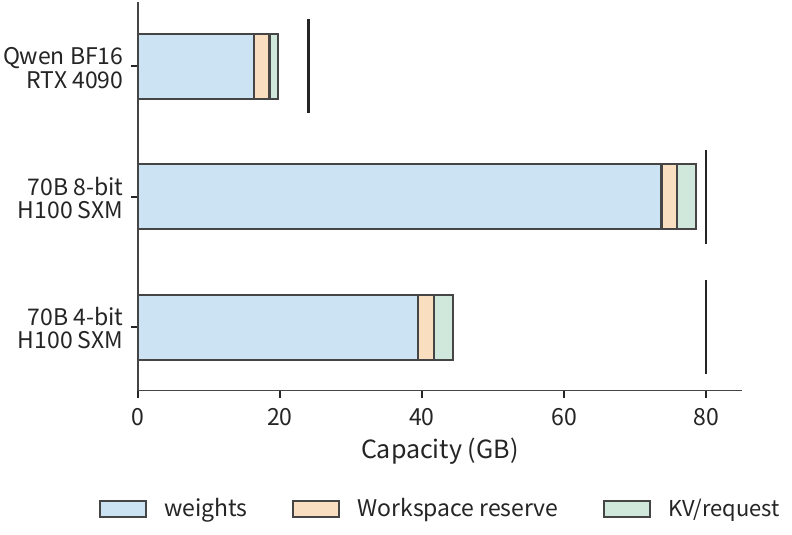
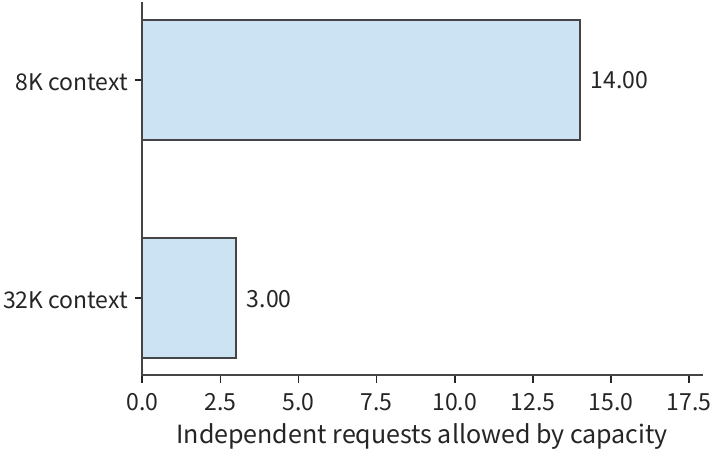
Cùng phương pháp cũng có thể phân tích các triển khai lớn hơn. Weight BF16 của một model 235B khoảng 470 GB, vượt tổng 192 GB của tám RTX 4090, trong khi một máy chủ HGX đơn với tám H100 SXM cùng cung cấp 640 GB. Sau khi trừ weight, khoảng 170 GB còn lại, phải chứa trạng thái mỗi request, workspace, và dữ liệu phải được nhân bản trên nhiều card sau khi sharding — ví dụ, các tham số chuẩn hóa và router, mỗi cái được lưu một lần trên mỗi card, và KV từ 4 KV head chia trên tám card, trong đó mỗi head được lưu một lần trên mỗi hai card. Chương 6 sẽ tính các ngân sách mỗi card này dựa trên cách công việc của model được chia giữa các card.
Dung lượng quyết định số card tối thiểu mà một instance cần; độ dài request và độ đồng thời sau đó quyết định khối lượng công việc instance phải xử lý. Độ rộng bit thấp hơn giải phóng không gian, ngữ cảnh ngắn hơn cho phép nhiều request cùng trú hơn, và việc tái sử dụng trong batch thay đổi chi phí thực thi của các request này. Do đó, chọn sơ đồ triển khai đòi hỏi xem xét lần lượt dung lượng, khối lượng truy cập và khối lượng tính toán; Chương 3 sẽ thêm nữa thời điểm request đến và các hạn chót.
Bài tập 2-7 [Cốt lõi]: Xác định GPU memory có thể chứa được bao nhiêu request
Dùng RTX 4090 với 24 GB bộ nhớ và 2 GiB workspace, lấy weight BF16 của Qwen3-8B theo đúng giá trị cho trong bảng. Tìm số request tối đa có thể chứa đồng thời ở ngữ cảnh 4K, 8K và 16K lần lượt; với trường hợp 8K, tăng workspace lên 3 GiB và tính lại. Sau đó, dùng weight 4-bit 39.500 GB của model 70B trong bảng, chuyển sang RTX 6000 Ada với 48 GB bộ nhớ, giữ workspace ở 2 GiB, và tìm số request cho ngữ cảnh 8K và 32K lần lượt. Trước tiên so sánh các yêu cầu dung lượng của weight, workspace và KV, rồi tính số request mà bộ nhớ còn lại có thể chứa.
Ngược lại, với accelerator và mục tiêu dịch vụ cho trước, ta cũng có thể giải cho không gian còn lại dành cho model. Gọi dung lượng khả dụng mỗi card là , workspace cố định dành riêng là , KV mỗi request là , độ đồng thời là , và số byte mỗi tham số là . Bỏ qua các đối tượng thường trú khác, cận trên của số tham số mà dung lượng một card cho phép là
Trước tiên xác định kích thước trạng thái mà dịch vụ cần, rồi tính không gian còn lại cho weight. Lấy dung lượng 24 GB của RTX 4090, workspace 2 GiB, 4 request mỗi cái 8192 token, và KV mỗi request theo 1,125 GiB của Qwen3-8B — với BF16 ở 2 byte mỗi tham số, không gian còn lại giữ được tối đa khoảng 8,51 tỷ tham số. Hình 2-34 trước tiên trừ trạng thái dịch vụ, rồi khoét ra ngân sách weight.
Khi cấu trúc model thay đổi, ngân sách weight và ngân sách trạng thái thay đổi cùng nhau. Tăng số layer hoặc số KV head làm tăng mỗi request, giảm không gian còn lại cho weight; phân tán trên các card thay vào đó mở rộng tổng dung lượng trong khi cũng tăng truyền thông. Trong báo cáo Llama 3, việc triển khai inference BF16 của model 405B dùng hai máy chủ với tổng cộng 16 H100, vì dung lượng yêu cầu vượt quá những gì bộ nhớ của một máy chủ đơn cung cấp. Do đó quy mô model, cấu trúc trạng thái và số card phải được chọn cùng nhau.
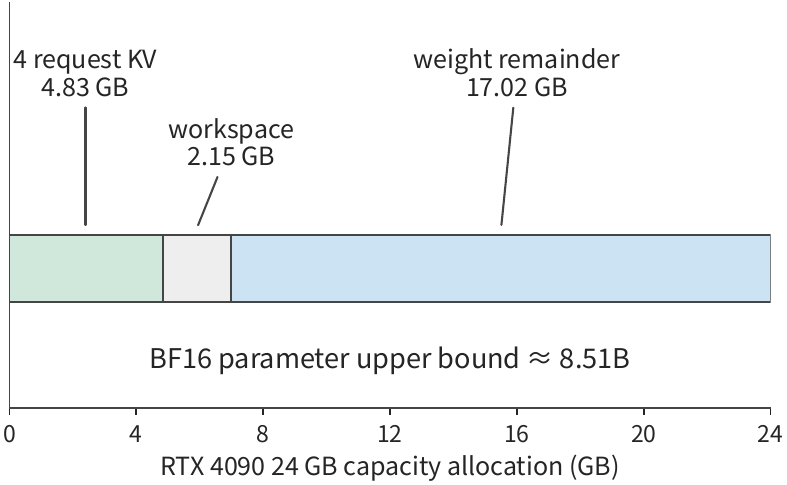
2.6.3 So sánh các model dưới các kịch bản request khác nhau
Cuối cùng, ta gom lại dung lượng, chuỗi lần gọi và chất lượng tác vụ. Trước tiên loại các cấu hình có dung lượng không đủ cho từng card, rồi cộng dồn công việc request dọc theo đường tính toán thực tế của từng model, và cuối cùng kiểm tra model có hoàn thành được tác vụ mục tiêu không.
Khi so sánh các model hoàn chỉnh, ta có thể xuất phát từ hai loại đầu vào. Cố định cho các yêu cầu tài nguyên của cùng các độ dài lần gọi, làm cho các khác biệt cấu trúc dễ quan sát; cố định văn bản và tác vụ thay vào đó đòi hỏi trước tiên phải đưa văn bản qua tokenizer của từng model để có độ dài đầu vào, rồi kiểm tra output. Hai phép so sánh này lần lượt trả lời “cùng số vị trí được tính như thế nào” và “cùng tác vụ này phải được thực thi ra sao”.
Trước tiên so sánh các yêu cầu tài nguyên dưới cùng độ dài đầu vào và đầu ra. Lấy ; model thực thi một prefill và ba decode, cuối cùng giữ lại 131 vị trí được xử lý. Cộng tính toán ma trận của các lần gọi này cho bảng dưới đây.
| Model | Tính toán toàn bộ ma trận của request (TFLOPs) | Cách cài đặt dùng trong phép tính này |
|---|---|---|
| DeepSeek V4.1 Flash | 4.14 | CED + replay cửa sổ đuôi, chỉ mục trong tập ứng viên |
| Qwen3-8B | 1.83 | Attention nhân quả hiệu lực |
| Qwen3.6 | 0.66 | Full attention hình chữ nhật cộng nhánh linear chia khối |
| DeepSeek V4-Flash | 3.40 | Attention chính hiệu lực cộng chỉ mục tham chiếu |
| Kimi K3 (MLA nén) | 27.16 | MLA nén cộng KDA chia khối; decode dùng KDA hồi quy |
Bảng này theo cùng các đường thực thi như Bảng 2-C, với Kimi K3 dùng MLA nén suốt, chuyển phép chiếu lên sang phía query và tổng hợp. Đầu vào của V4.1 Flash đúng 128 token, tất cả nằm trong cửa sổ replay của decoder, nên request ngắn này không nhận được lợi ích — như với prompt dài — của việc bỏ qua một số lượng lớn vị trí decoder. Toàn bộ request cộng dồn prefill và ba decode dọc theo cùng đường đã chọn, với ngữ cảnh tăng từ 128 đến 131; các hình dạng ma trận và biểu diễn trạng thái của đường này cùng nhau quyết định từng mục tính toán.
Mở rộng từ một lần gọi sang một request hoàn chỉnh làm rõ vai trò của đầu vào và đầu ra. Tăng chủ yếu tăng công việc xử lý đầu vào một lần, cũng như độ dài ngữ cảnh ở đầu các decode sau; tăng thay vào đó thực thi lặp lại các projection, expert và output head, và đọc ngữ cảnh nhiều lần. Đầu vào dài với output ngắn và đầu vào ngắn với output dài do đó đặt những nhu cầu khác nhau lên từng loại tài nguyên; Chương 3 sẽ phân tích tải hệ thống khi hai loại request này đến liên tục.
Bài tập 2-8 [Mở rộng]: Tái sử dụng tiền tố và việc sửa đổi đầu vào thay đổi tính toán model ra sao
Một lượt đầu vào tổng cộng 1443 token, trong đó 1392 token đầu tiên trúng cache, trả về 128 token. Tìm các giá trị của , độ dài ngữ cảnh ở cuối request, và kích thước KV mới được thêm vào của lượt này. So với việc tính lại toàn bộ, tái sử dụng cache giảm bao nhiêu số hàng projection và số cặp query-key nhân quả hiệu lực, lần lượt? Nếu nội dung được sửa đổi tại đầu vào token thứ 501, tính lại tiền tố dài nhất có thể tái sử dụng và độ dài đầu vào mới.
Giờ xét phép so sánh thứ hai, tức cố định văn bản. Ở đây các tokenizer khác nhau tạo ra các độ dài đầu vào khác nhau. Ví dụ, qua tám câu hỏi truy vấn cụm từ ngắn, cả Qwen3-8B lẫn DeepSeek V4-Flash đều tìm đúng cụm từ mục tiêu, nhưng văn bản ngắn tương ứng 523 hoặc 524 token trong Qwen so với 501 token trong DeepSeek V4-Flash; văn bản dài hơn tương ứng 2121 hoặc 2122 token so với 2036 token. Dùng cùng văn bản giữ cho nội dung tác vụ nhất quán, trong khi số token riêng của từng model quyết định hình dạng đầu vào thực tế.
Do đó, so sánh các model đòi hỏi trả lời đồng thời hai câu hỏi: cùng một tác vụ có hoàn thành không, và cần bao nhiêu tài nguyên để hoàn thành. Chỉ khi trước tiên đánh giá tính đúng đắn theo một chuẩn nhất quán, rồi thay độ dài đầu vào riêng của từng model vào bảng tài nguyên của model đó, ta mới nối được các khác biệt cấu trúc với việc sử dụng thực tế.
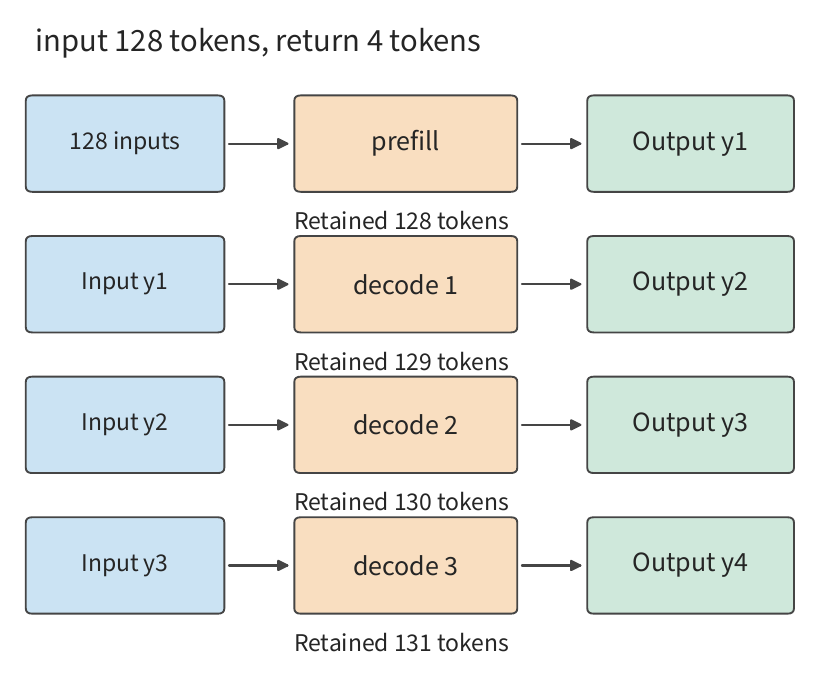
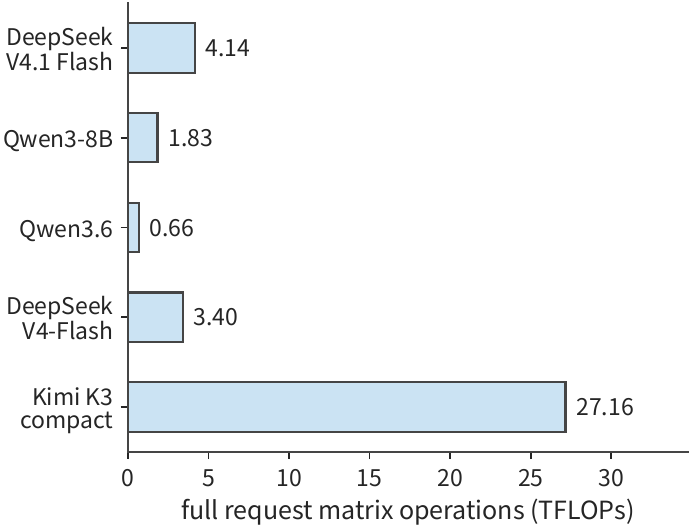
Bài tập 2-9 [Mở rộng]: Chọn model dựa trên dung lượng, yêu cầu tính toán và chất lượng tác vụ
Dùng Hình 2-28 đến 2-30 và Bảng 2-C, liệt kê với mỗi model các yêu cầu về toàn bộ weight, trạng thái 8K, decode một bước và prefill 8K. Triển khai trên một H100 SXM với 80 GB bộ nhớ, dành 2 GiB workspace, dùng weight BF16. Trước tiên xác định model nào vừa hoàn toàn trên một card; rồi đặt lại câu hỏi cho triển khai nhiều card, nêu những tham số định thời và truyền thông bổ sung nào sẽ cần lấy từ các chương sau. Đổi số token đầu ra thành 1 và tính lại số lần gọi prefill và decode. Cuối cùng, viết ra một chuẩn chất lượng cho tác vụ truy vấn cụm từ ngắn, giải thích phép so sánh cùng số token và phép so sánh cùng văn bản mỗi cái trả lời câu hỏi gì.
Chương này xuất phát từ đồ thị tính toán và dần dần tính ra các yêu cầu tài nguyên của một request hoàn chỉnh. Attention quyết định ngữ cảnh được lưu và truy cập ra sao, MoE quyết định những weight nào được chọn trong mỗi lần gọi, và độ sâu cùng kết nối mạng quyết định thứ tự tính toán và lưu trữ tạm. Chương tiếp theo sẽ thêm các phân bố độ dài request, thời điểm đến, lệnh gọi công cụ, huấn luyện và học tăng cường (RL — Reinforcement Learning), phân tích cách tính toán này tích lũy thành tải hệ thống theo thời gian.
Ngộ nhận và cạm bẫy
Ngộ nhận: nhiều tham số hơn luôn có nghĩa nhiều tính toán mỗi token hơn. Tổng tham số quyết định dung lượng của toàn model; các expert do MoE chọn, loại cơ chế attention và hình dạng lần gọi quyết định công việc hiện tại. So sánh Bảng 2-A, Bảng 2-B và Hình 2-29 để giải thích yếu tố nào quyết định số tham số và yếu tố nào quyết định độ phức tạp tính toán.
Ngộ nhận: nếu dung lượng KV giảm còn một phần tư, tính toán attention cũng giảm theo cùng tỷ lệ. GQA dùng chung biểu diễn ngữ cảnh, nhưng các query head vẫn chấm điểm riêng; MLA thay đổi chiều rộng ngữ cảnh và cũng thay đổi vị trí phép chiếu lên thực thi. Trước tiên xác định ma trận và trạng thái nào bị thay đổi, rồi tính công việc còn lại.
Ngộ nhận: nếu kích thước trạng thái cố định, có thể bỏ qua chi phí truy cập. Ma trận hồi quy cố định vẫn cần cập nhật; prefill cũng có thể sinh ra trạng thái khối tạm. Dung lượng, truy cập tích lũy và tập làm việc đỉnh trả lời những câu hỏi khác nhau.
Ngộ nhận: số token đầu vào bằng nhau làm cho việc so sánh năng lực model công bằng. Số token đầu vào và đầu ra phù hợp để so sánh cấu trúc tài nguyên; các tác vụ cùng văn bản thêm nữa cần điều kiện chấm điểm, chất lượng và thực thi cố định, và phải cho phép các tokenizer khác nhau tạo ra các độ dài khác nhau.
Bài tập chương và tái lập kết quả
Các bài tập 2-2, 2-5 và 2-7 tạo thành phần cốt lõi; các bài tập còn lại phân tích các trường hợp đặc biệt và áp dụng phương pháp cho các model khác. Trước tiên hoàn thành các dự đoán và suy dẫn của riêng bạn một cách độc lập, rồi đối chiếu với các phép tính kèm theo. Các lệnh tính chạy từ gốc repository; để xem đầy đủ các biến thể, hãy xem tài liệu mở rộng Chương 2.
| Nội dung tương ứng | Điểm vào tái lập cục bộ |
|---|---|
| Phụ thuộc tuần tự và tương đương cache | python3 calculations/calc.py sequence-dependencies --format md |
| Forward pass và expert của Qwen3.6 | python3 calculations/calc.py qwen36-forward --format md |
| Tính toán ma trận đầy đủ của DeepSeek V4.1 Flash | python3 calculations/calc.py v41-forward --tokens 8192 --execution ced --format md |
| Đường đủ layer tham chiếu của DeepSeek V4.1 Flash | python3 calculations/calc.py v41-forward --tokens 8192 --execution reference --format md |
| So sánh năm model và request hoàn chỉnh | python3 calculations/reproduce_ch02.py |
| Phân rã trạng thái DeepSeek V4-Flash | python3 calculations/calc.py state --model deepseek-v4-flash --length 8192 |
| Trạng thái Kimi K3 và thực thi chia khối | python3 calculations/calc.py k3-kda-chunk --tokens 8192 |
| Độ mịn expert | python3 calculations/calc.py qwen235-expert-granularity --format md |
| Một lần gọi MTP đơn lẻ | python3 calculations/calc.py v4-mtp-forward --format md |
| Thay các trường trace đã biết | python3 calculations/calc.py trace-resource-bridge --format md |
| So sánh request năm model | python3 calculations/calc.py request-model-comparison --format md |
Về các hình vẽ, dữ liệu tính toán và phương pháp tái dựng trong chương này, xem thư mục hình. Tài liệu cuối chương mô tả cấu trúc và thiết kế của từng model.
Bảng tham chiếu ma trận model
Bộ bảng này lần ngược từ tổng toàn model về các ma trận cụ thể. Khi tra cứu, trước tiên xác định model và nhánh thực thi, rồi nhân FLOPs ma trận của một lần gọi với số layer; với routed expert, cũng cộng dồn theo số hàng đầu vào thực tế mà mỗi expert nhận. Baseline Qwen3-8B trong Bảng 2-1 xuất hiện ở mục 2.1.4.
Bảng 2-2 Qwen3.6-35B-A3B: tính toán tiêu thụ tài nguyên cho các module attention lai và MoE
Backbone có tổng cộng 40 layer: 10 layer dùng nhánh full-attention, còn 30 layer dùng nhánh linear-attention; cả hai loại layer sau đó đều thực thi MoE. Mỗi token chọn 8 trong 256 routed expert, cộng một shared expert. Đầu ra QKV của nhánh linear chia thành các chiều 2048, 2048 và 4096; và của nó được dùng lại theo quan hệ gom nhóm của các value head.
Đầu vào model
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Tra cứu token embedding | ID → | Bảng tra cứu | 0; truy cập tra cứu hàng tính riêng | 1 |
Nhánh Full-Attention
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Full attention: và gating đầu ra | 10 | |||
| Full attention: , | , tổng 2 | 10 | ||
| Full attention: tương tác ngữ cảnh | head, KV head, chiều head | Không có weight bổ sung | 10 | |
| Full attention: output projection | 10 |
Nhánh Linear-Attention
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Linear attention: projection QKV chung | 30 | |||
| Linear attention: cổng output | 30 | |||
| Linear attention: giá trị điều khiển , | , tổng 2 | 30 | ||
| Linear attention: convolution và hồi quy delta | mỗi cái ; là | Convolution: 8192 kênh, chiều rộng kernel 4 | Hồi quy là ; thuật toán chia khối tính riêng | 30 |
| Linear attention: output projection | 30 |
Nhánh chuyên gia dùng chung giữa các layer
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Mỗi layer: điểm định tuyến | 40 | |||
| Routed expert : biến đổi trên nhánh được chọn | Hai ma trận ; một ma trận | 40 | ||
| Shared expert: biến đổi chung cho mọi token | Hai ma trận ; một ma trận | 40 | ||
| Cổng shared expert | 40 |
Giao diện đầu ra
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Output head từ vựng (một lần ở cuối) | 1 |
Khi cộng dồn, nhân công thức mỗi hàng với số layer ở cột cuối; với phần routed-expert, cũng cộng dồn theo số hàng thực tế mà mỗi expert nhận được. Chuẩn hóa cuối thực thi một lần; chuẩn hóa trong layer, activation, xử lý vị trí và cập nhật trạng thái thực thi dọc theo nhánh tương ứng.
Khi đọc bảng này, trước tiên chọn tập các hàng tương ứng với việc layer dùng linear attention hay full attention, rồi cộng phần MoE dùng chung. Attention tuyến tính quyết định ngữ cảnh được lưu thế nào, MoE quyết định weight nào token hiện tại dùng; hai cơ chế có thể cùng tồn tại. A3B mô tả quy mô kích hoạt danh nghĩa — toàn bộ các expert vẫn cùng nhau tạo thành model thường trú.
Bảng 2-3 DeepSeek-V3: MLA và mạng feedforward dense/expert
DeepSeek-V3 có tổng cộng 61 layer: ba layer đầu dùng FFN dense, còn 58 layer còn lại mỗi layer chọn 8 routed expert mỗi token cộng một shared expert. Ở dưới, MLA được tính qua đường giãn nở: với mỗi token, biến latent được chiếu lên để tạo và của mỗi head, và một biểu diễn vị trí 64 chiều được nối với . Query và key cùng tham gia chấm điểm phụ thuộc vị trí, còn được dùng để tổng hợp nội dung.
Đầu vào model
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Tra cứu token embedding | ID → | Bảng tra cứu | 0; truy cập tra cứu hàng tính riêng | 1 |
Attention MLA
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Query down-projection: tạo query hạng thấp | 61 | |||
| Query up-projection: mở rộng 128 head | 61 | |||
| KV down-projection: biến latent 512 chiều và nhánh vị trí 64 chiều | 61 | |||
| KV up-projection: mở rộng , theo từng head | 61 | |||
| MLA giãn nở: chấm điểm và tổng hợp value | head; chiều rộng Q/K , chiều rộng | Không có weight bổ sung | 61 | |
| Attention output projection | 61 |
Nhánh Feedforward
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Ba layer đầu: mạng feedforward dense | Hai ma trận ; một ma trận | 3 | ||
| 58 layer còn lại: điểm định tuyến | 58 | |||
| Routed expert | Hai ma trận ; một ma trận | 58 | ||
| Shared expert | Hai ma trận ; một ma trận | 58 |
Giao diện đầu ra
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Output head từ vựng (một lần ở cuối) | 1 |
Khi cộng dồn, nhân công thức mỗi hàng với số layer ở cột cuối; với phần routed-expert, cũng cộng dồn theo số hàng thực tế mà mỗi expert nhận được. Chuẩn hóa cuối thực thi một lần; chuẩn hóa trong layer, activation, xử lý vị trí và cập nhật trạng thái thực thi dọc theo nhánh tương ứng.
V3 kết hợp hai phương pháp tiết kiệm tài nguyên: MLA dùng một biến latent hạng thấp để biểu diễn ngữ cảnh, còn MoE cho một token chỉ thực thi một số expert. DeepSeek V4-Flash còn thay đổi cách ngữ cảnh được tổ chức, dùng một cửa sổ để giữ các vị trí gần đây và các tỷ lệ nén khác nhau để lưu ngữ cảnh dài hạn. Các bảng module dưới đây mở rộng riêng từng loại ngữ cảnh này.
Bảng 2-4 DeepSeek V4-Flash: truy cập ngữ cảnh có chọn lọc và tính toán expert
43 layer gồm 2 layer cửa sổ thuần túy, 21 layer CSA và 20 layer HCA; mỗi token chọn 6 routed expert, cộng một shared expert. là số cặp query–key hiệu lực cho attention chính trên tất cả các request tại layer đó, còn là số cặp query–key thực sự được chỉ mục quét — cả hai đều không gồm số head. Tám nhóm của grouped output projection mỗi nhóm xử lý một lát dữ liệu khác nhau. Projection nén của CSA trước tiên tạo biểu diễn 1024/256 chiều với các nhánh chồng lấn, rồi tạo riêng biểu diễn ngữ cảnh attention chính 512 chiều và các mục chỉ mục 128 chiều.
Đầu vào model
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Tra cứu token embedding | ID → | Bảng tra cứu | 0; truy cập tra cứu hàng tính riêng | 1 |
Các projection attention chung cho mọi layer
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Mọi layer: query down-projection | 43 | |||
| Mọi layer: query up-projection | 43 | |||
| Mọi layer: KV dùng chung | 43 | |||
| Attention chính: cửa sổ và ngữ cảnh nén được chọn | head, mỗi head chiều | Không có weight bổ sung | 43 | |
| Mọi layer: output projection hạng thấp theo nhóm | , tổng 8 | 43 | ||
| Mọi layer: output projection sau khi nối | 43 |
Công việc riêng của CSA
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| CSA: nén ngữ cảnh và gating cho attention chính | , tổng 2 | 21 | ||
| CSA: query chỉ mục | 21 | |||
| CSA: weight head chỉ mục | 21 | |||
| CSA: nội dung nén chỉ mục và gating | , tổng 2 | 21 | ||
| CSA: quét và chọn lọc chỉ mục | head chỉ mục, mỗi head chiều | Không có weight bổ sung | Tích vô hướng ; tính trọng số và top-k riêng | 21 |
Công việc riêng của HCA
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| HCA: nén ngữ cảnh và gating cho attention chính | , tổng 2 | 20 |
Expert và kết nối theo từng layer
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Điểm định tuyến | 43 | |||
| Routed expert | Hai ma trận ; một ma trận | 43 | ||
| Shared expert | Hai ma trận ; một ma trận | 43 | ||
| mHC: hợp nhất và trộn dư | Tham số trộn và chuẩn hóa | Ma trận trộn, vô hướng và hàm đặc biệt cộng dồn riêng | 43 |
Giao diện đầu ra
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Output head từ vựng (một lần ở cuối) | 1 |
Khi cộng dồn, nhân công thức mỗi hàng với số layer ở cột cuối; với phần routed-expert, cũng cộng dồn theo số hàng thực tế mà mỗi expert nhận được. Chuẩn hóa cuối thực thi một lần; chuẩn hóa trong layer, activation, xử lý vị trí và cập nhật trạng thái thực thi dọc theo nhánh tương ứng.
Bảng này cho thấy “chỉ chọn một lượng nhỏ ngữ cảnh mỗi bước” không có nghĩa tổng khối lượng công việc là cố định: attention chính dùng , quét chỉ mục dùng , còn projection nén vẫn tiếp tục thực thi trên đầu vào mới bất kể điều gì. Ba loại công việc này tăng trưởng theo những mẫu khác nhau.
Bảng 2-5 Kimi K3: KDA, MLA gọn và expert không gian latent
93 layer gồm 69 layer KDA và 24 layer MLA; layer đầu dùng FFN dense, còn các layer còn lại mỗi layer chọn 16 trong 896 routed expert và thực thi một nhánh dùng chung có chiều rộng kết hợp . MLA trong bảng này dùng đường gọn tính attention trực tiếp trên biến latent, với 96 phép chiếu nhỏ theo từng head, mỗi cái dùng tham số riêng của head. Shared expert xử lý trực tiếp vector backbone 7168 chiều, còn các routed expert hoạt động trong không gian latent 3584 chiều.
Đầu vào model
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Tra cứu token embedding | ID → | Bảng tra cứu | 0; truy cập tra cứu hàng tính riêng | 1 |
Nhánh KDA
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| KDA: , , | , tổng 3 | 69 | ||
| KDA: projection suy giảm hạng thấp | 69 | |||
| KDA: projection suy giảm hạng thấp | 69 | |||
| KDA: cổng cập nhật | 69 | |||
| KDA: cổng đầu ra | 69 | |||
| KDA: cập nhật trạng thái hữu hạn | ma trận trạng thái | Convolution ngắn và tham số suy giảm | Hồi quy ; cài đặt chia khối tính riêng | 69 |
| KDA: output projection | 69 |
Nhánh MLA
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| MLA: query down-projection | 24 | |||
| MLA: query up-projection | 24 | |||
| MLA: biến latent và nhánh bổ sung | 24 | |||
| MLA: gộp key up-projection vào biến đổi query | , tổng 96 | 24 | ||
| MLA gọn: chấm điểm và tổng hợp trong không gian latent | head; chiều chấm điểm , chiều tổng hợp | Dùng biểu diễn ngữ cảnh gọn | 24 | |
| MLA: khôi phục biểu diễn value sau khi tổng hợp | , tổng 96 | 24 | ||
| MLA: cổng đầu ra | 24 | |||
| MLA: output projection | 24 |
Nhánh Feedforward và Expert
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Layer đầu: mạng feedforward dense | Hai ma trận ; một ma trận | 1 | ||
| Các layer còn lại: điểm định tuyến | 92 | |||
| Vào không gian latent expert | 92 | |||
| Routed expert : biến đổi trong không gian latent | Hai ma trận ; một ma trận | 92 | ||
| Rời không gian latent sau khi hợp nhất | 92 | |||
| Shared expert: hai chiều rộng expert được hợp nhất | Hai ma trận ; một ma trận | 92 |
Kết nối độ sâu
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| AttnRes: trộn theo hướng độ sâu | Các biểu diễn khối sẵn có → biểu diễn backbone hiện tại | Tham số trộn theo độ sâu | Tính theo số khối tham gia trộn mỗi layer; không xem là KV ngữ cảnh | Cộng dồn theo số khối tham gia |
Giao diện đầu ra
| Module và vai trò | Đầu vào → Đầu ra (hàng × chiều rộng) | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | FLOPs ma trận | Layer/lần gọi |
|---|---|---|---|---|
| Output head từ vựng (cuối, một lần) | 1 |
Khi cộng dồn, nhân công thức mỗi hàng với số layer ở cột cuối; phần routed-expert cũng đòi hỏi cộng dồn theo số hàng thực tế mà mỗi expert nhận được. Chuẩn hóa cuối thực thi một lần; chuẩn hóa trong layer, activation, xử lý vị trí và cập nhật trạng thái thực thi dọc theo các nhánh tương ứng của chúng.
Khi đọc bảng Kimi K3, hãy xem xét số layer của mạng attention và mạng feedforward riêng biệt: 69 layer dùng KDA, 24 layer dùng MLA; layer đầu dùng FFN dense, còn 92 layer sau dùng MoE không gian latent. Shared expert giữ nguyên đầu vào backbone 7168 chiều, còn routed expert trước tiên đi qua một projection giảm chiều, xử lý đầu vào 3584 chiều. Số layer, chiều rộng và trong bảng do đó lần lượt kiểm soát số lần lặp, kích thước mỗi lần gọi và khối lượng gọi thực tế.
Bảng 2-6 DeepSeek V4.1 Flash: CED, ngữ cảnh dùng chung và Engram
Bảng này bao phủ tất cả các phép chiếu ma trận cho việc sinh văn bản thường lệ. Số hàng đầu vào chỉ số token query mà layer xử lý trong lần đưa này; chỉ số vị trí cần sinh KV toàn cục; chỉ số mục nén mới hoàn thành trong lần đưa này. Để tham chiếu: trong prefill đủ layer, ; trong CED, encoder có và decoder có , nhưng layer nguồn KV toàn cục của decoder vẫn có . Mọi số hàng thêm vào phải được nhân với số request .
| Module và chức năng | Ma trận trọng số (chiều rộng đầu vào × chiều rộng đầu ra) | Số hàng thực thi | Layer/lần gọi |
|---|---|---|---|
| Projection mHC Single-Pass của attention | 40 | ||
| Projection mHC Single-Pass của FFN | 40 | ||
| Projection xuống của query | 40 | ||
| Projection lên của query | 40 | ||
| Projection KV SWA cục bộ | 40 | ||
| Projection output theo nhóm | , 8 nhóm tổng cộng | 40 | |
| Projection nối output | 40 | ||
| Điểm định tuyến | 40 | ||
| Cổng shared expert | 40 | ||
| Up shared expert | 40 | ||
| Down shared expert | 40 | ||
| Cổng routed expert | 40 | ||
| Up routed expert | 40 | ||
| Down routed expert | 40 | ||
| Projection KV của kết quả query Engram | 2 | ||
| Projection KV toàn cục | 4 | ||
| Cổng nén 2:1 | 3 | ||
| Projection key chỉ mục toàn cục | 4 | ||
| Projection query chỉ mục | 8 | ||
| Projection weight head chỉ mục | 8 | ||
| Output head từ vựng token cuối | Token cuối, một lần | 1 |
Số phép toán ma trận của mỗi phép chiếu 2D là số hàng đầu vào nhân với chiều rộng đầu vào và chiều rộng đầu ra, rồi nhân với 2; projection output theo nhóm chỉ tính trong từng nhóm, và các kết nối giữa các nhóm mà trên thực tế không tồn tại không được đếm. Ba hàng routed expert được cộng dồn theo số hàng mà mỗi expert nhận; shared expert xử lý mọi vị trí token query.
Tương tác attention không thêm weight mới: mỗi query có 64 head, mỗi head rộng 512 chiều, và cả QK lẫn PV đều được cộng dồn trên các vị trí thực sự được truy cập. Indexer có 32 head, mỗi head rộng 128 chiều, và Full, Reindex và Reuse khác nhau ở phạm vi quét và việc chỉ mục có thực thi hay không. Compressor chỉ tạo key chỉ mục sau khi khối tương ứng hoàn thành; số hàng của phép chiếu key không được viết thành số vị trí mỗi đầu vào.
Engram trước tiên lấy một vector 256 chiều từ mỗi trong 24 bucket tương ứng với n-gram, nối chúng thành một đầu vào 6144 chiều, rồi tạo ra các key bốn chiều và một value dùng chung qua phép chiếu trong bảng; các tích vô hướng chuẩn hóa và gating ghi chúng vào các tuyến dư bốn chiều. Việc tra cứu bảng không được tính là phép nhân ma trận; khối lượng đọc, gating và rút gọn có trọng số được liệt kê riêng trong bản ghi tính toán. Địa chỉ tra cứu chỉ do chuỗi token quyết định và độc lập với các activation, nên nó có thể được nạp trước trước khi layer này thực thi; mục 6.7.4 so sánh chi phí đặt bảng trong bộ nhớ chủ, HBM hoặc ROM. Tổ hợp có trọng số mHC cuối cùng và RMSNorm (chuẩn hóa căn bình phương trung bình) không thêm weight từ vựng nào.
Chú thích nguồn
- Dữ liệu so sánh năm model: Dữ liệu so sánh năm model; chương trình sinh bảng; tính toán thống nhất cho năm model; tính toán output head token cuối của Qwen3.6.
- Cấu hình và tính toán tham số Qwen3-8B: Tính toán cấu hình và tham số Qwen3-8B, tổng số tham số .
- Tính toán MLA mở rộng của Kimi K3: Tính toán MLA mở rộng của Kimi K3.
- Tính toán expert của Kimi K3: Tính toán expert của Kimi K3.
- Số phép toán của mHC: Số phép toán mHC.
- Tính toán MTP của DeepSeek V4-Flash: Tính toán MTP của DeepSeek V4-Flash.
- Tính toán forward của V3: Tính toán forward V3.
- Mô tả cấu hình model của Kimi K3: Mô tả cấu hình model của Kimi K3; tính toán forward của Kimi K3.
- Tính toán request hoàn chỉnh và theo lần gọi cho năm model: Tính toán request hoàn chỉnh và theo lần gọi cho năm model; chạy
python3 calculations/reproduce_ch02.py. Cả năm model đồng nhất dùng đường thực thi từ Bảng 2-C của chương này; Kimi K3 dùng đường MLA nén, còn đường mở rộng cũ giữ lại bên cạnh so sánh V4-Pro nằm trong bản ghi request lịch sử. - Thí nghiệm truy vấn ghép cặp: Thí nghiệm truy vấn ghép cặp. Qwen dùng BF16/vLLM; DeepSeek V4-Flash dùng expert MXFP4, KV FP8/SGLang, và đặt một số weight trong bộ nhớ CPU.
- Bản ghi tính toán phụ thuộc tuần tự: Bản ghi tính toán phụ thuộc tuần tự.
- Bản ghi theo từng layer: Bản ghi từng layer.
- Kiểm tra xuyên chương: Kiểm tra xuyên chương.
- Tính toán tích lũy cache: Tính toán tích lũy cache.
- Bản ghi tiếp nối hậu tố đã cache: Bản ghi tiếp nối hậu tố đã cache.
- Bản ghi trạng thái chia khối và buffer: Bản ghi trạng thái chia khối và buffer.
- Tính toán trạng thái lai: Tính toán trạng thái lai.
- Thí nghiệm toàn model: Thí nghiệm toàn model.
- Định tuyến đều và tập trung: Định tuyến đều; định tuyến tập trung.
- Bản ghi lập lịch theo từng layer: Bản ghi lập lịch theo layer.
- Bản ghi forward của Qwen3.6: Bản ghi forward Qwen3.6.
- Bản ghi forward đầy đủ của DeepSeek V4-Flash: Bản ghi forward đầy đủ DeepSeek V4-Flash.
- Bản ghi forward đầy đủ: Bản ghi forward đầy đủ.
- Bảng dung lượng và so sánh: Bảng dung lượng 8K; so sánh 32K.
- Dữ liệu so sánh 8K/200K/1M: Dữ liệu so sánh 8K/200K/1M; cài đặt tính toán thống nhất. Phép tính kiểm tra các con số 8K nhất quán với Hình 2-29 và 2-30, và xác minh ranh giới khối nén, cận trên ứng viên và các phép toán theo từng layer.
- Động cơ kiến trúc: Báo cáo kỹ thuật DeepSeek V4 mô tả biểu diễn đa tuyến và truyền ổn định của mHC ở mục 2.2, và CSA/HCA ở mục 2.3; báo cáo kỹ thuật Kimi K3 mô tả động cơ và cài đặt theo khối của Attention Residuals — chọn thông tin theo chiều sâu.
- Đồng thiết kế (codesign): Tóm tắt bài báo gốc MQA; tóm tắt bài báo gốc GQA; báo cáo Llama 3, mục 6.1. Ví dụ dung lượng được suy ra từ trạng thái dịch vụ đã cho.
- Tính toán cốt lõi: Tính toán lại theo từng mục cho các so sánh có điều kiện của chương này và chương trình tính toán.
- Báo cáo kỹ thuật V4.1: Báo cáo kỹ thuật chính thức DeepSeek V4.1, các mục 1, 2, 3 và 6; điều kiện cố định và tính toán lại cho phiên xuyên chương.
- Candidate pool của V4.1: Báo cáo kỹ thuật DeepSeek V4.1, mục 2.3.2 — Hierarchical Sparse Indexer dùng candidate pool và các vị trí ứng viên; Hình 5 cho thấy sự khác biệt giữa candidate pool dùng chung và top-k kế tiếp.
- Tính toán forward của V4.1 Flash: Cài đặt tính toán ma trận văn bản hoàn chỉnh cho V4.1 Flash; đầu vào CED 8K, đầu vào đủ layer tham chiếu, decode 8K, decode 1M. Bản ghi tính toán và đánh giá.
Tóm tắt chương
Khi thiết kế một model, người ta cũng có thể bắt đầu bằng cách trừ trạng thái và không gian làm việc cần cho việc phục vụ khỏi dung lượng của accelerator, rồi so sánh xem quy mô và cấu trúc model nào mà không gian còn lại chứa được. MQA, GQA và kích hoạt thưa (sparse activation) cho thấy việc cải thiện hiệu quả hệ thống cũng là một cơ sở quan trọng để chọn cấu trúc model; trong phạm vi dung lượng cho phép, ta cũng phải so sánh chất lượng, độ trễ và chi phí để chốt một sơ đồ thiết kế.
Chương này mở rộng ba đại lượng tài nguyên từ Chương 1 thành các đối tượng có thể tính được. Kích thước ma trận quyết định dung lượng weight và số phép toán tuyến tính, số cặp query-key quyết định số phép toán của tương tác attention, thời gian trú của cache và số lần gọi model quyết định dung lượng lưu trữ và khối lượng đọc của trạng thái, và việc phân phối expert quyết định mỗi batch dùng bao nhiêu bản sao weight. Khi đối mặt với một điều kiện mới, trước tiên xác định điều kiện đó thay đổi đối tượng nào, rồi thế ngược vào công thức tương ứng: tăng batch size, kéo dài ngữ cảnh, mở rộng tập expert và tăng số expert được chọn mỗi cái tác động lên những thuật ngữ khác nhau.
Sau khi đọc chương này, bạn có thể liệt kê các yêu cầu tài nguyên cho một forward pass, một decode và một quá trình sinh hoàn chỉnh với một cấu hình model mới, và giải thích những thuật ngữ nào tăng khi độ dài hoặc batch size thay đổi. Chương 3 sẽ xét thêm quá trình các request đến và các quan hệ phụ thuộc của lệnh gọi công cụ, biến những yêu cầu này thành một khối lượng công việc biến thiên theo thời gian.