Chương 12 · Phối hợp End–Edge–Cloud
Đặt tác vụ ở local, edge hay cloud: cân bằng chất lượng phản hồi, độ trễ và chi phí trong các tình huống thực tế.
~93 phút đọc · Thuật ngữ
Phối hợp End–Edge–Cloud
Một bức ảnh được gửi lên đám mây để nâng cao chất lượng chạy trên model 0,3 giây, nhưng người dùng phải chờ 12,8 giây. Tăng tốc model lên gấp mười lần chỉ tiết kiệm được 0,27 giây; nén tệp đầu vào còn một nửa kích thước lại tiết kiệm được gần 6 giây. Quyết định đặt model ở đâu đòi hỏi phải so sánh thời gian hoàn thành của toàn bộ tác vụ. Một thiết bị từ xa có thể tăng tốc tính toán của model, nhưng việc gọi một dịch vụ từ xa cũng làm tăng thêm thời gian truyền tải và thời gian chờ.
Các chương 8–11 đã đề cập đến model serving, lập lịch tài nguyên và môi trường thực thi tác vụ. Chương này thảo luận cách triển khai các dịch vụ và môi trường này trên những thiết bị khác nhau. Thiết bị biên (edge device) thu nhận đầu vào và tương tác với người dùng; biên (edge) là một trạm làm việc hoặc nút dịch vụ cung cấp tính toán gần đó; đám mây (cloud) cung cấp một cụm tài nguyên từ xa. Một đầu cuối có thể thực thi cục bộ (local), gọi một trạm làm việc hoặc dịch vụ đám mây gần đó, hoặc phân chia các giai đoạn khác nhau của một model lên những thiết bị khác nhau.
Chương này trước tiên xây dựng một mô hình thời gian dựa trên ví dụ nâng cao chất lượng ảnh, sau đó dùng lời nói (speech) để giải thích các phụ thuộc tuần tự trong một pipeline, và cuối cùng chọn một phương án triển khai cho một agent chụp màn hình — agent phán đoán bước tiếp theo từ ảnh chụp màn hình rồi gọi một công cụ để thực hiện hành động. Nâng cao chất lượng ảnh đòi hỏi phải tính khi nào ảnh hoàn chỉnh đã xử lý trở về; lời nói đòi hỏi phân tích xem âm thanh có thể phát liên tục hay không; agent phải tích lũy chi phí truyền thông và thực thi qua từng vòng. Cả ba loại tác vụ đều chia sẻ một phương pháp phân tích: trước tiên tính toán mỗi bước xử lý và truyền tải mất bao lâu, sau đó xác định những bước nào phải chờ, và cuối cùng cộng thêm các chi phí thực tế như thiết lập kết nối, xếp hàng và khôi phục sau lỗi.
12.1 Từ thời gian chạy của model đến thời gian tương tác hoàn chỉnh
12.1.1 Nâng cao chất lượng ảnh
Nâng cao chất lượng ảnh cần bảo toàn các thông tin như vùng tối, vùng sáng và cân bằng trắng. Giữ lại nhiều thông tin gốc hơn để chỉnh sửa sau thường đồng nghĩa với việc truyền một tệp lớn hơn. Trong ví dụ này, một ảnh RAW 30 MB được tải lên và một ảnh đã xử lý 5 MB được trả về; tác vụ được coi là hoàn thành khi người dùng nhận được toàn bộ ảnh đã xử lý.
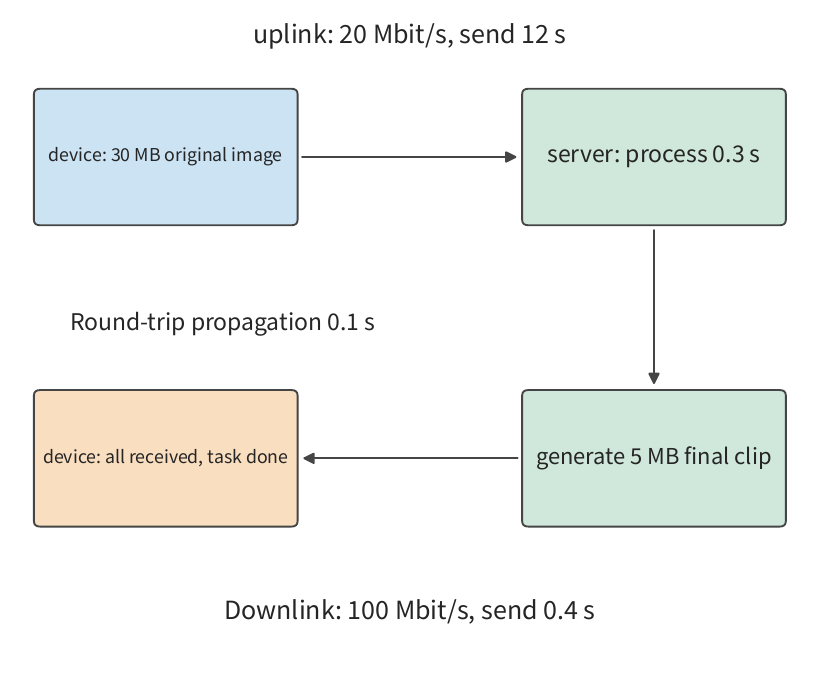
Đầu tiên hãy theo dõi dữ liệu của một bức ảnh nằm ở đâu dọc theo đường truyền của nó. Các tốc độ và thời gian xử lý cụ thể trong ví dụ này được đánh dấu trong Hình 12-1; về sau, các đại lượng này được biểu diễn bằng một công thức tổng quát.
Khi xây dựng mô hình, trước tiên cần phân biệt thời gian mỗi bước cần và thời gian hoàn thành tác vụ. Kích thước tệp chia cho tốc độ gửi cho ra thời gian cần để gửi tệp; thời gian tính toán của model được xác định bởi độ phức tạp tính toán và tốc độ thực thi của bộ xử lý. Khi các bước thực thi tuần tự, tổng thời gian bằng tổng thời lượng của từng bước; khi một số bước thực thi đồng thời, thời điểm bước cuối cùng hoàn thành phải được tính dựa trên các phụ thuộc của chúng.
Trước khi viết các mối quan hệ này thành công thức, hãy cố định các điều kiện đơn giản hóa cho ví dụ này: thời gian khứ hồi (RTT) được đơn giản hóa thành thời gian cần cho truyền lan khứ hồi; chi phí xếp hàng và xử lý giao thức được thảo luận riêng trong Mục 12.3. Kết nối đã được thiết lập, máy chủ bắt đầu xử lý sau khi nhận đủ ảnh RAW, gửi ảnh đã xử lý cho người dùng sau khi sinh ra nó, và đường lên/đường xuống truyền payload với tốc độ không đổi. Gọi đầu vào là byte, đầu ra là byte, tốc độ đường lên/đường xuống là byte/s, RTT là , và thời gian xử lý là . Thời gian hoàn thành nối tiếp là
Sau khi byte cuối cùng của bản tải lên rời khỏi bên gửi, nó vẫn cần truyền lan tới máy chủ; việc trả về ảnh đã xử lý cũng truyền lan một lần. Hai lần truyền lan một chiều cộng lại bằng . Thời gian truyền lan được quyết định bởi đường truyền; thời gian gửi được quyết định bởi kích thước tệp và tốc độ, nên thu nhỏ tệp chỉ rút ngắn thời gian gửi. Ở đây ký hiệu tốc độ truyền của payload; thời gian khởi tạo kết nối và chờ phản hồi được cộng thêm riêng trong Mục 12.3.
Ví dụ: Tại sao thời gian tải lên lại giới hạn lợi ích của việc tăng tốc model trong nâng cao chất lượng ảnh? Đường lên 20 Mbit/s, đường xuống 100 Mbit/s, s, s. Trong suốt chương này, MB và Mbit dùng đơn vị thập phân; MiB là byte. Thay vào ta được
Phần tải lên chiếm 12 giây, khoảng 94% tổng thời gian. Tăng tốc giai đoạn xử lý lên gấp mười lần rút ngắn thời gian hoàn thành xuống còn 12,53 giây, chỉ tiết kiệm được 0,27 giây. Ngay cả khi xử lý hoàn tất tức thì, tải lên, truyền lan và tải xuống vẫn cần 12,5 giây. Đây chính xác là giới hạn được mô tả bởi định luật Amdahl: giai đoạn xử lý chỉ chiếm khoảng 2,3% tổng thời gian, nên ngay cả khi loại bỏ hoàn toàn thì tổng thời gian cũng chỉ rút ngắn được khoảng 2,3%.
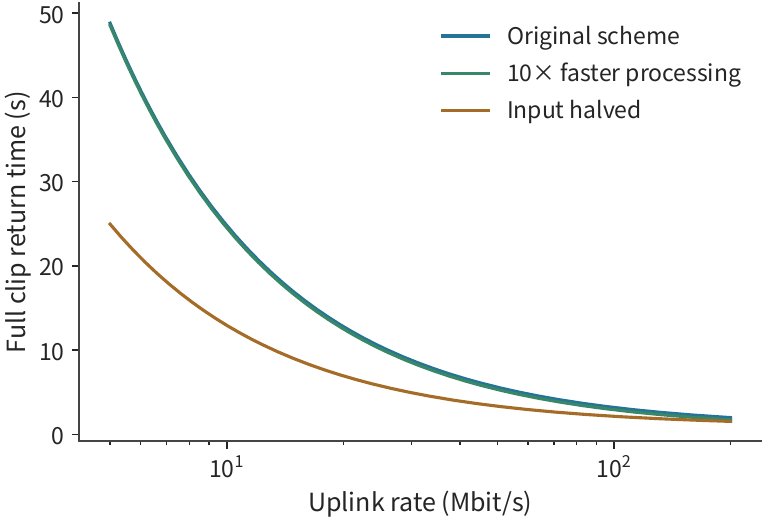
Thời gian tiết kiệm được từ việc tăng tốc model bị giới hạn; một hướng khác là rút ngắn truyền tải. Nâng tốc độ đường lên lên 100 Mbit/s làm thời gian tải lên giảm xuống còn 2,4 giây, và toàn bộ tác vụ chỉ cần 3,2 giây — nhanh gấp bốn lần. Một cách khác là giữ nguyên tốc độ đường lên và nén đầu vào. Giả sử nén không mất dữ liệu (lossless) làm đầu vào giảm một nửa; mã hóa/giải mã tăng thêm tổng cộng 0,15 giây, nên việc gửi chỉ mất 6 giây, và toàn bộ tác vụ mất khoảng 7,0 giây. Nén đáng giá ở đây vì thêm 0,15 giây mã hóa/giải mã tiết kiệm được 6 giây truyền tải.
Gọi kích thước đầu vào đã nén là , và thời gian mã hóa/giải mã thêm là . Tổng thời gian tiết kiệm được nhờ nén là
Cho lợi ích của biểu thức này bằng 0 sẽ ra tốc độ đường lên mà tại đó việc nén đúng bằng không còn tiết kiệm thời gian. Ở tốc độ đường lên 20 Mbit/s, gửi ít đi 15 MB tiết kiệm được 6 giây; ở 100 Mbit/s tiết kiệm được 1,2 giây; ở 800 Mbit/s chỉ tiết kiệm được 0,15 giây, và lợi ích giảm về 0. Chi phí tính toán của cùng một phương pháp nén không đổi; thứ thay đổi là mất bao lâu để gửi những byte đó. Hình 12-2 thể hiện mối quan hệ này.
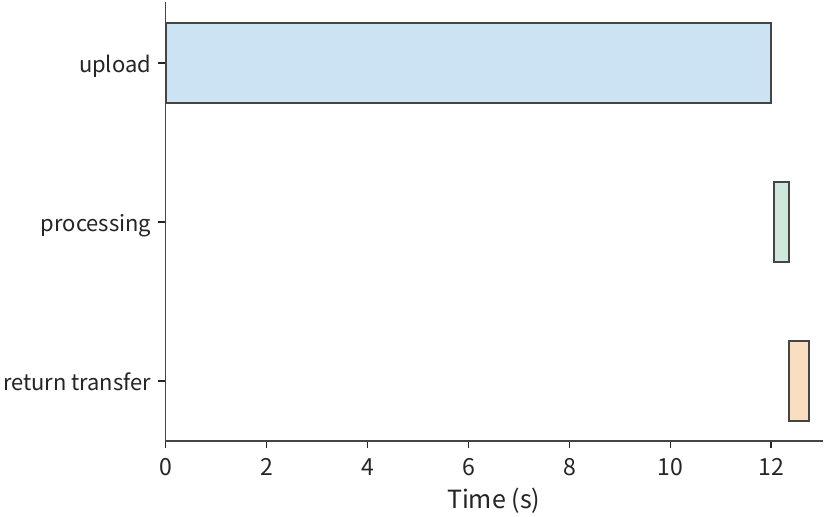
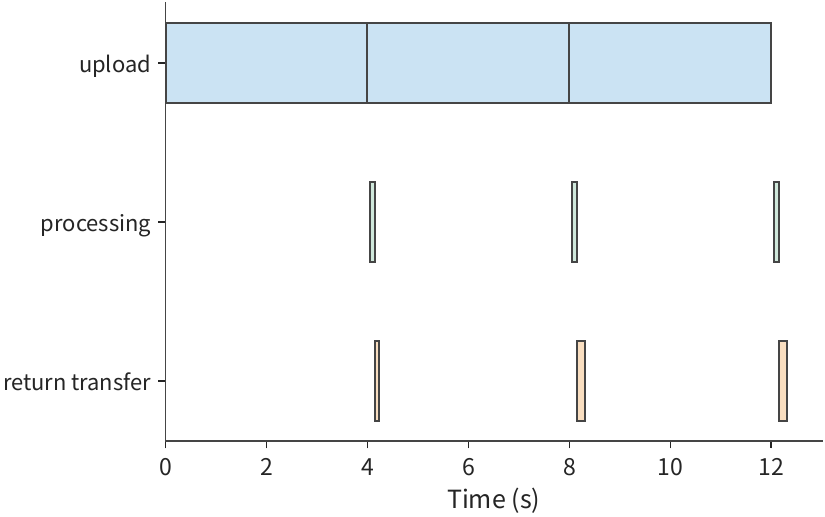
Tiếp theo, xét xem các bước có thể chồng lấn hay không. Giả sử ảnh RAW được chia thành ba khối (chunk), mỗi khối có thể được xử lý độc lập ngay khi nhận được: mỗi khối mất 4 giây để tải lên và 0,1 giây để xử lý; ba khối đầu ra có kích thước lần lượt là 1, 2 và 2 MB, cần 0,08, 0,16 và 0,16 giây để trả về tương ứng. Sau khi khối đầu tiên tới máy chủ, việc xử lý và trả về của nó có thể chồng lấn với việc tải lên khối thứ hai; tương tự với khối thứ hai. Khối cuối cùng vẫn chỉ tải lên xong ở giây thứ 12; sau đó mới đến xử lý, trả về và truyền lan, và ảnh đã xử lý hoàn chỉnh trở về với người dùng vào khoảng 12,4 giây. So với 12,8 giây ban đầu, phần xử lý và trả về của hai khối đầu tiên hoàn tất trong khi các lần tải lên tiếp theo vẫn đang diễn ra và không thêm thời gian chờ; nhưng tổng thời gian tải lên 12 giây không thể rút ngắn.
Hình 12-3 và 12-4 so sánh hai cách bố trí trên cùng một trục thời gian.
Nếu xử lý đòi hỏi độ phơi sáng toàn cục hoặc thông tin chéo khối, nó phải chờ toàn bộ ảnh tới nơi mới có thể bắt đầu, và toàn bộ tác vụ vẫn mất 12,8 giây ngay cả khi gửi theo khối. Độ phức tạp tính toán và khối lượng dữ liệu quyết định mỗi bước mất bao lâu; các phụ thuộc quyết định liệu các bước có thể thực thi đồng thời hay không. Các dịch vụ lời nói thời gian thực liên tục thu nhận, xử lý và phát âm thanh, được mô tả tốt hơn bằng một pipeline nắm bắt được các phụ thuộc này.
12.1.2 Lời nói thời gian thực
Nhận dạng giọng nói tự động (automatic speech recognition, ASR) chuyển âm thanh thành văn bản; chuyển văn bản thành tiếng nói (text-to-speech, TTS) chuyển văn bản thành âm thanh phát được. Một dịch vụ streaming có thể sinh kết quả trong khi vẫn nhận đầu vào. Lấy TTS làm ví dụ: người dùng có thể bắt đầu nghe trước khi toàn bộ đoạn âm thanh được tổng hợp xong. Vì vậy, ngoài thời điểm toàn bộ quá trình tổng hợp kết thúc, ta cũng cần biết thời điểm phân đoạn đầu tiên bắt đầu phát, và liệu việc phát về sau có giữ liên tục hay không.
Để tính các thời điểm này, trước tiên hãy viết pipeline thành một quan hệ truy hồi theo từng khối. Xét một pipeline xử lý âm thanh trong đó các khối đầu vào tương ứng một-một với các khối đầu ra. Đầu thu tạo một khối âm thanh mỗi 20 ms; model xử lý nó và gửi ra kết quả; trình phát phát các khối theo thứ tự. Khối của đầu vào sẵn sàng tại thời điểm ; xử lý của model mất ; gửi mất ; truyền lan một chiều là . Bộ xử lý xử lý từng khối một, và giao diện mạng gửi kết quả từng khối một, nên
Ở đây , , lần lượt ký hiệu thời điểm xử lý hoàn thành, gửi hoàn thành và khối tới nơi. Max đầu tiên thể hiện rằng việc xử lý khối này phải chờ cả đầu vào của nó sẵn sàng lẫn bộ xử lý hoàn thành khối trước; max thứ hai thể hiện rằng việc gửi khối này phải chờ cả tính toán hoàn thành lẫn liên kết đi ra trống. Hai sự chờ này lần lượt đến từ phụ thuộc dữ liệu và tranh chấp tài nguyên.
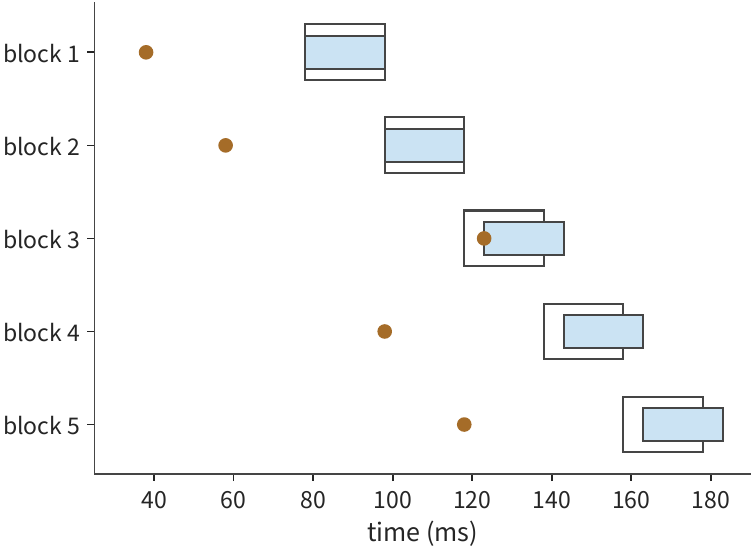
Ví dụ: Tại sao jitter (biến động) độ trễ mạng lại có thể làm cạn bộ đệm phát âm thanh? Điều chế xung mã (pulse-code modulation, PCM) ghi lại các mẫu biên độ liên tiếp của âm thanh; 24 kHz nghĩa là 24.000 mẫu mỗi giây, mono nghĩa là một kênh mẫu duy nhất, và 16-bit nghĩa là mỗi mẫu chiếm 2 byte. Dùng PCM 24 kHz, mono, 16-bit, mỗi khối là 20 ms, 960 byte. Xử lý một khối mất 12 ms, gửi mất 1 ms, và truyền lan điển hình mất 5 ms. Khối đầu tiên thu xong ở 20 ms và tới nơi ở 38 ms; sau bộ đệm 40 ms nó phát ở 78 ms (Hình 12-5). Khối thứ hai tới nơi ở 58 ms và phát ngay sau đó ở 98 ms. Thời gian xử lý mỗi khối ngắn hơn chu kỳ thu 8 ms, và gửi chỉ mất 1 ms, nên cả xử lý lẫn gửi đều theo kịp tốc độ thu.
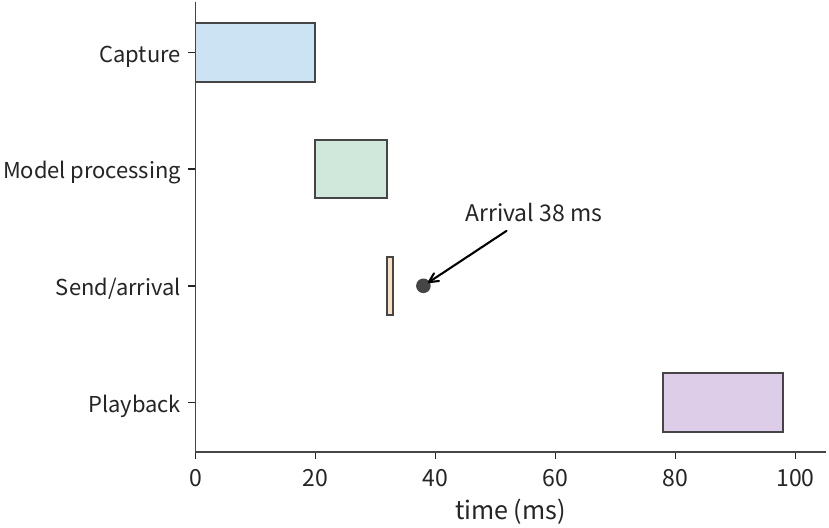
Đổi thời gian truyền lan của khối thứ ba thành 50 ms; khối này tới nơi ở 123 ms, muộn hơn 5 ms so với thời điểm phát dự kiến ban đầu là 118 ms. Mặc dù khối thứ tư đã tới nơi ở 98 ms, trình phát vẫn phải phát khối thứ ba trước, nên việc phát các khối sau bị trì hoãn theo (Hình 12-6).
Tổng quát hóa quy tắc phát này: gọi thời lượng mỗi khối âm thanh là , và bộ đệm ban đầu là . Khối đầu tiên bắt đầu phát ở , và các khối tiếp theo bắt đầu ở
Max ở đây phản ánh rằng trình phát phải chờ cả “khối này tới nơi” lẫn “khối trước phát xong”. Khi số hạng thứ nhất lớn hơn, chênh lệch chính là khoảng gián đoạn mới được thêm vào. Nâng bộ đệm ban đầu từ 40 ms lên 45 ms cũng dời thời điểm phát dự kiến của khối thứ ba tới 123 ms, vừa đủ để tránh sự gián đoạn phát do đến muộn 5 ms gây ra; cái giá phải trả là phân đoạn đầu tiên cũng bắt đầu phát muộn hơn 5 ms. Tăng bộ đệm ban đầu kéo dài thời gian chờ trước lần phát đầu tiên nhưng cũng dung thứ các biến động thời gian tới nơi lớn hơn, giúp việc phát về sau liên tục hơn.
Tốc độ truyền không đủ trong dài hạn tạo ra một loại gián đoạn khác. Để dễ tính, lấy PCM 16 kHz, mono, 16-bit, trong đó tốc độ dữ liệu cần cho việc phát là 256 kbit/s, với 20 ms tương ứng 640 byte. Nếu mạng chỉ duy trì được 130 kbit/s tốc độ truyền âm thanh trong dài hạn, bộ đệm giảm ròng 126 kbit mỗi giây. Một bộ đệm ban đầu chứa 60 ms âm thanh có 15.360 bit, sẽ cạn kiệt trong khoảng giây.
Vẽ lượng dữ liệu chưa phát thành một đường cong suy giảm theo thời gian giúp phân biệt jitter ngắn hạn với thiếu tốc độ truyền dài hạn. Trong Hình 12-7, tăng bộ đệm chỉ nâng điểm khởi đầu; độ dốc không đổi.
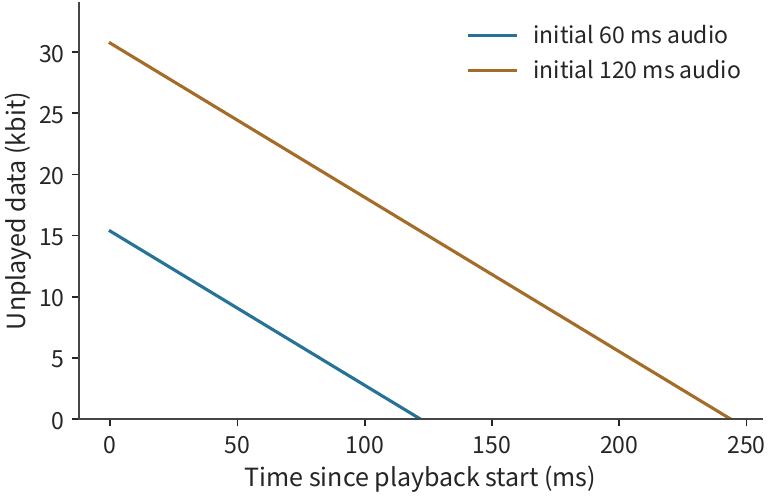
Tăng bộ đệm chỉ trì hoãn thời điểm cạn kiệt một cách tỷ lệ; chỉ có nâng tốc độ truyền hoặc hạ bitrate âm thanh mới có thể làm lượng dữ liệu nhận được đủ cho việc phát. Bộ đệm có thể giảm thiểu ảnh hưởng của các biến động độ trễ ngắn hạn lên việc phát, trong khi thiếu tốc độ truyền dài hạn đòi hỏi nhiều băng thông hơn hoặc ít dữ liệu hơn.
12.1.3 Computer Use: hoàn thành tác vụ thông qua thao tác giao diện
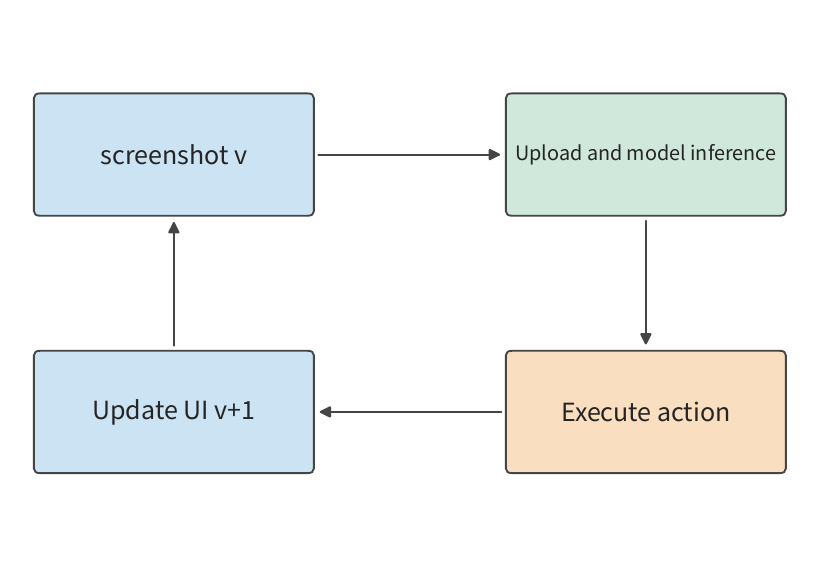
Computer use cho phép một chương trình hành động như một người dùng, hoàn thành tác vụ thông qua ảnh chụp màn hình, nhấp chuột và nhập liệu. Chương trình lặp lại vòng quan sát giao diện, phán đoán của model, thực thi hành động, và quan sát lại. Điểm khác biệt chính so với pipeline âm thanh là ảnh chụp màn hình hợp lệ tiếp theo chỉ có được sau khi hành động của vòng trước hoàn tất và giao diện cập nhật. Trước khi model quyết định nhấp vào đâu, nó không thể lấy được giao diện sau cú nhấp đó. Do đó, thời gian chờ trong một vòng tích lũy lặp đi lặp lại trên toàn bộ tác vụ.
Mũi tên quay lại trong Hình 12-8 cho thấy tác vụ này, không giống âm thanh, khó mà chồng lấn theo từng khối: công việc tiếp theo phải chờ hành động tạo ra một giao diện mới.
Lấy một tác vụ cần 30 vòng hành động làm ví dụ. Với dịch vụ ban đầu, mỗi vòng tải lên một ảnh chụp màn hình 0,8 MB; với đường lên 6,4 Mbit/s, việc tải lên mất 1 giây; quan sát, hành động và cập nhật giao diện ở phía biên cùng mất 0,3 giây; model từ xa mất 2,0 giây; truyền lan khứ hồi là 0,2 giây. Kết nối đã được thiết lập, và thời gian gửi của phản hồi điều khiển được coi là 0. Một vòng là giây; 30 vòng tổng cộng 105 giây.
Ví dụ: Thời gian truyền tiết kiệm được nhờ nén ảnh chụp màn hình có bù đắp được các vòng hành động tăng thêm không? Nén ảnh chụp màn hình xuống còn 0,2 MB; việc mã hóa tăng thêm mất 30 ms, làm thời gian tải lên giảm xuống còn 0,25 giây; phần việc còn lại vẫn mất 2,5 giây. Nên
Mỗi vòng tiết kiệm được 0,72 giây; trong 30 vòng điều này tiết kiệm được 21,6 giây, đưa tác vụ từ 105 giây xuống còn khoảng 83 giây.
Nén cũng có thể làm thay đổi số vòng hành động. Nếu văn bản mờ khiến agent phải thực hiện nhiều hành động sửa chữa hơn, tổng thời gian đã nén phải được viết là , trong đó là số vòng thực tế cần thiết. Từ ta có , nên số vòng tối đa mà tác vụ vẫn được rút ngắn thời gian là 37; 38 vòng sẽ mất khoảng 106 giây. Chất lượng ảnh nén ảnh hưởng đến số lần sửa chữa. Tác vụ này cho phép tối đa bảy vòng hành động tăng thêm; vượt quá con số đó, thời gian sửa chữa sẽ bù đắp hết thời gian tiết kiệm được nhờ nén.
Phiên bản ảnh chụp màn hình cũng ảnh hưởng trực tiếp đến số vòng. Giả sử model đọc phiên bản , và giao diện sau đó thay đổi; một hành động dựa trên ảnh chụp cũ khi đó có thể sai, đòi hỏi phải khôi phục giao diện và chụp lại ảnh mới. Gắn phiên bản ảnh chụp màn hình với số hiệu hành động, và để đầu cuối chụp lại ảnh mỗi khi giao diện thay đổi, tránh được loại công việc phí phạm này.
Mục 12.5 sẽ tiếp tục phân tích tác vụ chụp màn hình này: với mười vòng đầu đã hoàn thành, hai mươi vòng còn lại đòi hỏi chọn nơi thực thi, giữ nguyên kích thước ảnh chụp, công việc phía biên và các tham số đường truyền ban đầu, đồng thời so sánh một dịch vụ model nhanh hơn có thể tiết kiệm được bao nhiêu thời gian.
12.1.4 So sánh sơ bộ giữa Local, gần đó và Đám mây
Phân tích trong các Mục 12.1.1 đến 12.1.3 có thể được tóm tắt thành ba mức, mỗi mức tương ứng với một đối tượng tính toán khác nhau:
| Mức phân tích | Đối tượng tính toán | Kết luận đạt được |
|---|---|---|
| Thời gian mỗi bước | Mỗi thao tác tính toán, gửi và truyền lan mất bao lâu | Tải ảnh RAW lên mất 12 giây, model mất 0,3 giây |
| Phụ thuộc thực thi | Công việc nào có thể chồng lấn, công việc nào phải chờ | Các khối ảnh độc lập có thể chồng lấn; ảnh chụp màn hình của vòng sau phải chờ hành động của vòng trước hoàn tất |
| Thực thi thực tế | Khi nào tính toán và gửi bắt đầu khi dữ liệu đã sẵn sàng | Ngay cả khi tốc độ truyền trung bình của âm thanh đủ, một lần đến muộn vẫn có thể gây gián đoạn |
Trước tiên hãy dùng thời gian từng bước và các quan hệ phụ thuộc để phán đoán liệu thực thi từ xa có thể nhanh hơn. Khi giao toàn bộ tác vụ cho một dịch vụ từ xa, thời gian tính toán tiết kiệm được phải vượt quá thời gian tăng thêm cho tải lên, tải xuống, truyền lan, xếp hàng và chuẩn bị. Các tác vụ nhiều vòng chỉ cần chuẩn bị một lần, nhưng truyền thông diễn ra ở mọi vòng; âm thanh phát liên tục cũng phải đảm bảo dữ liệu đến đúng lúc. Nơi đặt model đồng thời thay đổi thời gian tính toán, truyền thông và chuẩn bị.
Riêng thời gian truyền lan tối thiểu đã có thể loại bỏ sớm những máy chủ quá xa. Ánh sáng truyền trong sợi quang với tốc độ khoảng m/s; với một đường một chiều dài 10.000 km, riêng truyền lan khứ hồi đã cần tối thiểu khoảng 100 ms. Nếu một máy chủ từ xa được yêu cầu phản hồi trong 50 ms, riêng thời gian truyền lan đã vượt quá hạn mức đó. Dùng một máy chủ gần hơn có thể trực tiếp rút ngắn thời gian chờ này.
So sánh trên coi thiết bị biên là một vị trí thực thi duy nhất, chỉ tính chênh lệch thời gian giữa biên và từ xa; bản thân thiết bị biên tính toán nhanh đến mức nào, và nó có thể chứa được gì, vẫn chưa được xem xét. Mục 12.1.5 trước tiên phân tích định lượng tài nguyên thực thi của thiết bị biên, và Mục 12.2 sau đó quyết định truyền cái gì: gửi ảnh khi giao toàn bộ tác vụ cho dịch vụ từ xa, gửi các đặc trưng (features) sau khi mã hóa ở phía biên, và gửi trạng thái khi di trú phiên; một khi đối tượng truyền thay đổi, khối lượng dữ liệu và thời gian cần thiết sẽ thay đổi theo.
12.1.5 Tài nguyên thực thi ở biên và triển khai local
So sánh các phương án triển khai trong Mục 12.5 sẽ dùng “2,9 giây tính toán model phía biên cho mỗi vòng”. Để giải thích con số này đến từ đâu và nó đúng trong điều kiện nào, ta cần phân tích định lượng thiết bị biên như một tài nguyên thực thi: băng thông bộ nhớ quyết định thời gian tối thiểu để sinh mỗi token, dung lượng bộ nhớ quyết định model nào có thể chứa được và ngữ cảnh dài bao nhiêu có thể giữ lại, còn mức tiêu thụ điện và pin quyết định việc thực thi có thể tiếp tục trong bao lâu.
Một chiếc điện thoại như một tài nguyên thực thi: băng thông trước hết cho cận trên của số token mỗi giây. SoC của một chiếc điện thoại cao cấp dùng bộ nhớ LPDDR5X, một chuẩn DRAM công suất thấp nhắm vào các thiết bị di động như điện thoại. Bảng thông số của Snapdragon 8 Elite liệt kê mức tối đa 5.300 MHz và dung lượng tối đa 24 GB, nhưng không đưa ra độ rộng bus; LPDDR5X truyền dữ liệu hai lần mỗi chu kỳ xung nhịp, nên 5.300 MHz tương đương 10,6 Gbit/s mỗi chân, hơi thấp hơn mức tốc độ cao nhất 10,7 Gbit/s của các thiết bị LPDDR5X; thiết bị chuẩn JEDEC là một kênh x16 đơn. Theo tốc độ SoC hỗ trợ, băng thông của một kênh x16 là GB/s; với bốn kênh x16 gộp lại, tổng là 84,8 GB/s.
Một khi băng thông đã được xác định, mỗi bước mất bao lâu phụ thuộc vào lượng dữ liệu bước đó đọc. Khối lượng công việc cố định tuân theo phép tính trong Mục 4.8.2: Qwen3-8B, BF16, một request, ngữ cảnh 8K, trong đó một bước decode đọc 15,14 GB trọng số và 1,21 GB KV, tổng cộng khoảng 16,345 GB. Chỉ riêng việc đọc qua trọng số một lần mất
cho cận trên decode khoảng 5,6 token/s; tính cả KV, mỗi bước mất khoảng 0,193 s, cận trên khoảng 5,2 token/s. Lượng tử hóa trực tiếp giảm số byte đọc mỗi bước: dùng định dạng nhóm q4_0 trong Mục 8.4, cứ 32 giá trị BF16 từ 64 byte xuống còn 18 byte, làm lượng đọc trọng số mỗi bước giảm xuống còn khoảng GB, với tổng mỗi bước khoảng 5,47 GB và 64,4 ms, cận trên khoảng 15,5 token/s. MELTing Point đo trên iPhone 14 Pro được 14,8 token/s cho Zephyr-3B q4_k và 6,0 token/s cho Llama-2 7B q3_k (q4_k, q3_k là các định dạng lượng tử hóa nhóm 4-bit và 3-bit trong cùng họ GGML với Q2_K của Mục 8.4.1), nhất quán về bậc độ lớn với kết quả suy ra ở đây.
Dung lượng quyết định model nào có thể chứa được và ngữ cảnh dài bao nhiêu có thể giữ lại. Theo công thức dung lượng trong Mục 2.6.2: bộ nhớ khả dụng trừ trọng số và phần dành riêng cố định, chia cho kích thước trạng thái mỗi request, cho ra dung lượng. Lấy bộ nhớ điện thoại từ ba tùy chọn dung lượng LPDDR5X của Micron — 6, 12 và 24 GB — cộng thêm mức 16 GB thường dùng trên điện thoại cao cấp, với 4 GB dành riêng cho hệ thống và không gian làm việc. Trọng số BF16 của Qwen3-8B tổng cộng 16,38 GB, nhiều hơn khoảng 1,24 GB so với 15,14 GB đọc mỗi bước, do bảng embedding: decode chỉ tra một hàng mỗi token mỗi bước, nhưng toàn bộ bảng phải nằm thường trú trong bộ nhớ. Trên cơ sở bộ nhớ thường trú này, chỉ mức 24 GB mới chứa được model; sau khi dành riêng bộ nhớ, còn lại khoảng 3,62 GB, chỉ đủ cho hai request 8K; lượng tử hóa thành q4_0, nó giảm xuống còn khoảng 4,61 GB:
| Bộ nhớ điện thoại | Sau khi dành riêng bộ nhớ và 4,61 GB trọng số | Số request và ngữ cảnh có thể chứa |
|---|---|---|
| 6 GB | Khoảng −2,61 GB | Không chứa được 8B; một model q4 lớp 3B khoảng 1,7 GB có thể chứa được |
| 12 GB | Khoảng 3,39 GB | Hai request 8K, hoặc một request đơn khoảng 23K token |
| 16 GB | Khoảng 7,39 GB | Sáu request 8K, hoặc một request đơn khoảng 50K token |
| 24 GB | Khoảng 15,39 GB | Mười hai request 8K, hoặc một request đơn khoảng 104K token |
KV BF16 của một request 8K là 1,21 GB, ở 147.456 byte mỗi token, tăng tuyến tính theo độ dài ngữ cảnh; một khi model đã chứa vừa, bộ nhớ còn lại quyết định trực tiếp độ dài ngữ cảnh. Mức 16 GB cũng là đường phân chia cho lượng tử hóa 8-bit: trọng số q8_0 khoảng 8,70 GB; sau khi dành riêng bộ nhớ, còn lại khoảng 3,30 GB, đủ chỗ cho hai request 8K; điện thoại có ít bộ nhớ hơn không chứa được một model 8B 8-bit.
Tiêu thụ điện và tuổi thọ pin là chi phí riêng của triển khai ở biên. Bảng phân bổ năng lượng trong Mục 4.1.3 đã cho ước tính bậc độ lớn khoảng 0,534 J mỗi token cho decode 8K một request trên H100, chỉ bao gồm di chuyển dữ liệu và tính toán ma trận. Tuy nhiên, các phép đo trên điện thoại bao gồm cả công suất tiêu thụ của toàn bộ thiết bị: MELTing Point đo được 0,16–0,21 mWh mỗi token, tức 0,576–0,756 J, với công suất duy trì đỉnh 13,8 W và công suất tức thời vượt quá 18 W. Thông lượng và năng lượng đo được kiểm chứng chéo lẫn nhau: 14,8 token/s nhân 0,576 J mỗi token là khoảng 8,5 W, nằm trong giới hạn công suất duy trì 13,8 W. Ngoại suy từ tập phép đo này, một lần sạc có thể hoàn thành khoảng 490–590 prompt suy luận. Vậy chi phí triển khai ở biên không chỉ là thời gian và tiền bạc: tốc độ sinh duy trì bị chặn trên bởi trần công suất, và tổng khối lượng công việc bị chặn bởi dung lượng pin.
Ba tầng thiết bị triển khai local. Hai tầng trên điện thoại có thể lấy trực tiếp từ Mục 4.8.2, vốn đã liệt kê cận dưới thời gian decode/prefill cho 11 thiết bị ứng viên dùng cùng model: bộ nhớ thống nhất M3 Ultra cung cấp 819 GB/s, 256/512 GB, với cận dưới đọc mỗi bước 19,96 ms, khoảng 50,1 token/s, và đủ dung lượng cho một MoE 235B 4-bit (Mục 4.6.3); RTX PRO 6000 cung cấp 1.792 GB/s, 96 GB, với 9,12 ms mỗi bước, khoảng 109,6 token/s. Hình 12-9 đặt ba tầng trên cùng một trục thời gian.
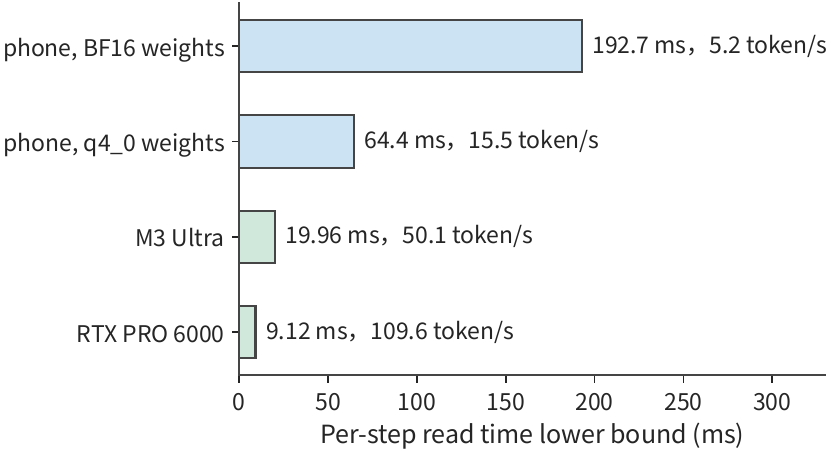
Mỗi runtime giải quyết một lớp vấn đề khác nhau. Thiết bị cho cận dưới về băng thông và dung lượng; việc thực thi thực tế còn phụ thuộc vào runtime. llama.cpp giải quyết cách trọng số được lưu trữ và thực thi theo từng khối: bố cục lượng tử hóa theo nhóm GGUF (định dạng tệp model của llama.cpp) quyết định dung lượng sau khi tải và lượng đọc mỗi bước; Mục 8.4.1 đã tính ra 84 byte mỗi nhóm của Q2_K, trung bình 2,625 bit mỗi giá trị. Ollama giải quyết phân phối model và đóng gói dịch vụ local: điều này tương ứng với sự đánh đổi được thảo luận trong Mục 12.2.3, “chuẩn bị một lần, tái sử dụng nhiều lần” — thứ Ollama tiết kiệm là thời gian chuẩn bị triển khai, không phải thời gian thực thi mỗi bước. MLX nhắm vào bộ nhớ thống nhất của Apple (Mục 4.6.3): CPU và GPU chia sẻ cùng một cụm bộ nhớ, loại bỏ việc sao chép dữ liệu giữa chúng, và trần dung lượng model là bộ nhớ toàn máy. Unsloth nhắm vào tinh chỉnh ở biên và trên một thẻ duy nhất: nó nhồi ngân sách dung lượng trạng thái huấn luyện vào một thẻ hoặc một máy, với các định dạng lượng tử hóa vẫn lấy từ Mục 8.4. Không runtime nào trong bốn runtime này thay đổi cận dưới băng thông và dung lượng đã suy ra ở trên; chúng chỉ quyết định việc thực thi thực tế có thể tiến gần các cận này đến mức nào. Thước đo thống nhất của khoảng cách này là tỷ số giữa thời gian đo được và cận dưới. Mục 12.5.2 sẽ dùng các bản ghi của Thí nghiệm 8-1 để chỉ ra rằng, trên RTX PRO 6000, thời gian đo được cho một bước decode bằng 2,83 lần cận dưới đọc, với phần vượt trội chủ yếu đến từ chi phí cố định mỗi bước; theo tiêu chí trong Mục 1.3.4, đây là chi phí hệ thống có thể giảm được, không phải hạn chế năng lực của thiết bị.
Trong số đó, dung lượng mà Unsloth tiết kiệm có thể tính trực tiếp bằng số byte mỗi tham số từ Mục 10.1.2. Adam hỗn hợp độ chính xác toàn tham số dùng 16 byte mỗi tham số: trọng số BF16 và gradient mỗi loại 2 byte, còn trọng số master FP32 và hai moment mỗi loại 4 byte. LoRA đóng băng trọng số gốc và chỉ giữ gradient cùng trạng thái optimizer cho adapter hạng thấp mới thêm: adapter BF16 hạng 16 của Qwen3-8B trên các projection Q và V là 14,6 MiB (ví dụ multi-LoRA ở cuối Chương 8), khoảng 7,65 triệu tham số. Trọng số, gradient, trọng số master và hai moment của adapter cùng chiếm 16 byte mỗi tham số, khoảng 0,12 GB; cộng 16,38 GB trọng số gốc BF16 ra tổng khoảng 16,5 GB. So sánh chỉ phần trạng thái thường trú, không kể activation và bộ đệm tạm:
| Bộ nhớ GPU | Adam hỗn hợp độ chính xác toàn tham số, 16 byte/tham số | Trọng số gốc BF16 + LoRA Q/V hạng 16 |
|---|---|---|
| 24 GB (RTX 4090) | Khoảng 1,5B tham số | Khoảng 12B tham số; Qwen3-8B cần khoảng 16,5 GB |
| 96 GB (RTX PRO 6000) | Khoảng 6B tham số | Khoảng 48B tham số |
RTX 4090 không chứa được 131,1 GB trạng thái cần cho huấn luyện toàn tham số của Qwen3-8B, nhưng nó chứa được việc huấn luyện LoRA; thứ Unsloth tiết kiệm là trạng thái này, không phải cận dưới băng thông cho việc đọc trọng số mỗi bước.
Điểm bùng phát (tipping point): khi nào biên là đủ, và khi nào phải lên đám mây? Ba cận dưới mỗi cái cho một điều kiện bùng phát. Băng thông: khi token được sinh mỗi vòng, cận dưới thời gian của model ở biên là nhân thời gian mỗi bước. Đây chính xác là cách “2,9 giây tính toán model phía biên mỗi vòng” của Mục 12.5 được suy ra: ở 15,5 token/s của q4_0, 2,9 giây tương ứng với việc sinh khoảng 45 token mỗi vòng; ở 5,2 token/s của BF16, nó tương ứng chỉ khoảng 15. Suy ngược từ hạn chót về ngân sách: một hạn chót 45 giây rải trên 20 vòng cho 2,25 giây mỗi vòng; sau khi trừ 0,3 giây công việc phía biên, còn lại khoảng 1,95 giây, nên dưới q4_0 của điện thoại mỗi vòng có thể sinh tối đa khoảng 30 token; một nhu cầu vượt con số này đòi hỏi chuyển sang thiết bị băng thông cao hơn hoặc lên đám mây. Nhu cầu 45 token mỗi vòng đã vượt ngân sách này, đó là lý do phương án phía biên của Mục 12.5.2 cần 64,0 giây, vượt hạn chót. Dung lượng: khi trọng số cộng ngữ cảnh cần thiết vượt quá bộ nhớ khả dụng của một tầng nhất định, tầng đó bất khả thi — một điện thoại 12 GB không chứa được model 8B BF16, và tầng điện thoại không chứa được model 235B. Điện năng: sinh liên tục biến pin thành một ràng buộc, với một lần sạc tương ứng khoảng 490–590 prompt; việc sinh theo lô (batch) hoặc sinh dài hạn nên chuyển sang thiết bị cắm điện. Ba điều kiện này hoàn thiện so sánh sơ bộ trong Mục 12.1.4: mục đó so sánh thời gian hoàn thành của từng phương án, còn ở đây trước hết ta loại các kịch bản mà biên về cơ bản bất khả thi. Bài tập 12-9 dùng cùng bộ công thức để tính lại trần băng thông, dung lượng và điện năng cho tầng điện thoại.
12.2 Phân công lao động xuyên thiết bị
12.2.1 Gọi toàn bộ model và thực thi theo giai đoạn
Cùng một ảnh chụp màn hình có thể được gửi trước tới máy chủ, nơi nó được chuyển thành các đặc trưng mà model dùng; hoặc ngược lại, đầu cuối có thể sinh các đặc trưng trước và chỉ gửi các đặc trưng lên máy chủ. Trong hai đường này, đối tượng đi qua mạng đã khác nhau. Ví dụ ảnh trong Mục 12.1.1 cho thấy truyền tệp chậm làm tính toán phải chờ; một khi một phần tính toán chuyển xuống biên, đối tượng thực sự cần gửi sẽ thay đổi theo.
Mạng con chuyển một tín hiệu hình ảnh hoặc âm thanh thành các đặc trưng số mà model dùng được gọi là encoder (bộ mã hóa). Đặt toàn bộ model ở phía từ xa đòi hỏi tải lên đầu vào và tải xuống kết quả; giữ encoder trên thiết bị biên đòi hỏi tải lên đầu ra của encoder. Khối lượng dữ liệu của một tệp hình ảnh so với một tensor đặc trưng được quyết định bởi biểu diễn tương ứng của chúng, nên việc tính toán trước ở biên không đảm bảo tải lên ít hơn.
Lấy agent chụp màn hình làm ví dụ: nén ảnh dùng ít byte hơn để biểu diễn texture và các vùng lặp lại, trong khi encoder thị giác (vision encoder) phải mở rộng ảnh thành các giá trị kênh cho mỗi vision token, để model ngôn ngữ đọc được. Cái trước nhắm đến lưu trữ gọn nhẹ, cái sau nhắm đến tính toán xuôi dòng.
So sánh hai phương án: một phương án tải ảnh lên trước rồi mã hóa từ xa; phương án kia mã hóa cục bộ trước rồi tải các đặc trưng lên. Tính toán của model ngôn ngữ sau đó giống hệt nhau ở cả hai, nên khi tính chênh lệch tổng thời gian giữa hai phương án, phần này triệt tiêu đúng bằng nhau. Vì vậy, ta chỉ cần so sánh thời gian mã hóa cục bộ với mã hóa từ xa, và thời gian truyền của ảnh với của các đặc trưng.
12.2.2 Khối lượng truyền và chi phí tính toán của mã hóa ở biên
Theo các mũi tên trong Hình 12-10 và 12-11, trước tiên xác nhận mỗi phương án truyền cái gì, rồi so sánh khối lượng truyền với thời gian tính toán từ xa tiết kiệm được.
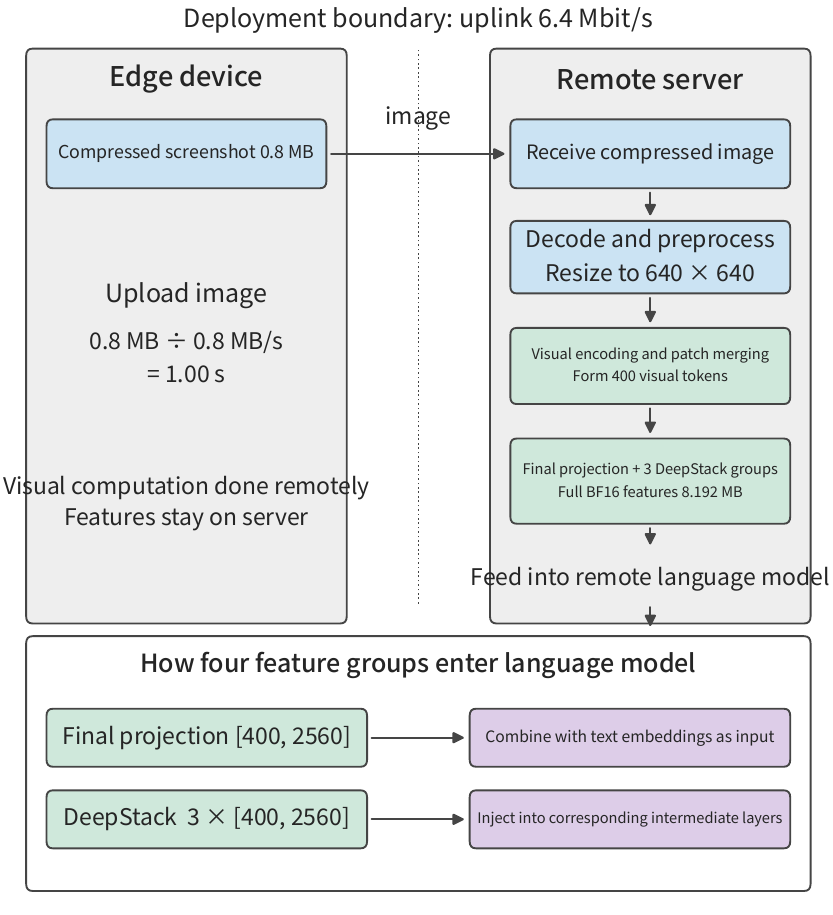
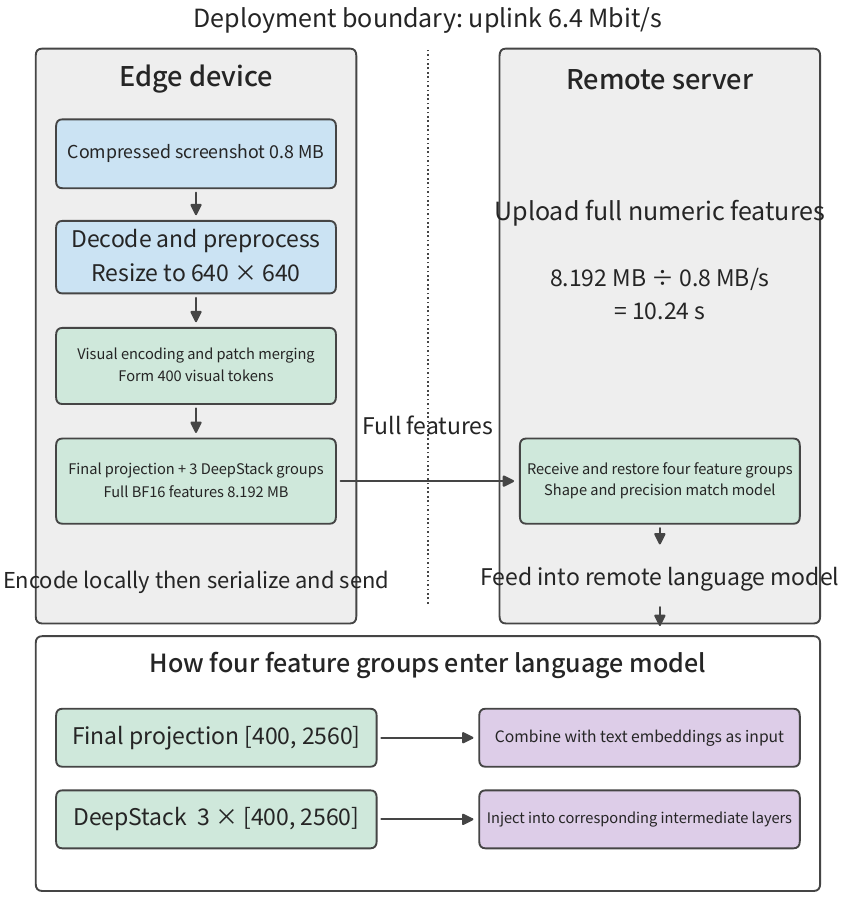
Ví dụ: Tại sao tải lên các đặc trưng thị giác lại có thể chậm hơn tải lên ảnh gốc? Tiếp tục với ảnh chụp màn hình 0,8 MB và đường lên 6,4 Mbit/s. Mã hóa thị giác dùng cấu hình cố định của Qwen3-VL-4B: kích thước ảnh sau tiền xử lý là , và sau khi gộp patch (patch merging) cho 400 vision token; ở đây một vision token là một vector đặc trưng biểu diễn nội dung ảnh, không phải một token văn bản, và không phải một pixel đơn lẻ của ảnh gốc. Mỗi vector đặc trưng của projection cuối cùng có 2560 thành phần, cộng ba bộ đặc trưng DeepStack cùng độ rộng (Mục 3.3.1); các đầu ra nhánh này phải được truyền cùng nhau. Mỗi vision token đòi hỏi lưu trữ tổng cộng giá trị BF16, nên đầu ra hoàn chỉnh là
Bốn bộ đặc trưng đi vào các tầng khác nhau của model ngôn ngữ. Chỉ truyền projection cuối cùng sẽ bỏ sót ba bộ kia. Bộ đặc trưng hoàn chỉnh khoảng 8,2 MB, gấp khoảng mười lần ảnh nén; trên đường lên ban đầu, thời gian gửi tăng từ 1 giây lên khoảng 10,2 giây (Hình 12-12).
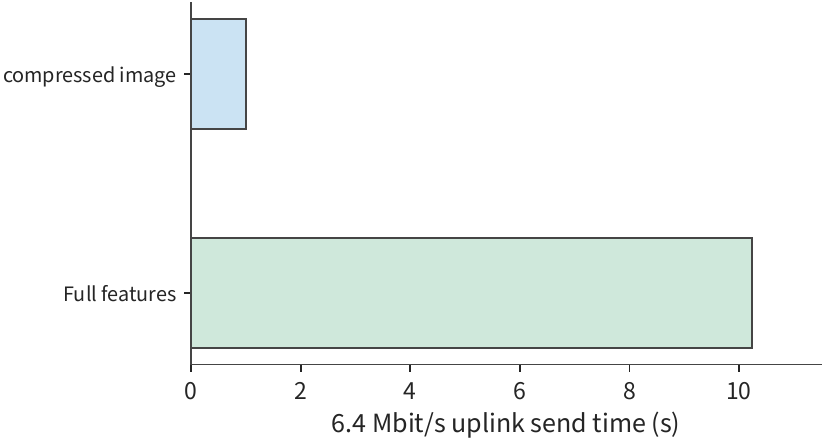
Viết so sánh này dưới dạng tổng quát: gọi là thời gian mã hóa cục bộ, là thời gian mã hóa từ xa, và là thời gian tuần tự hóa và chuyển đổi tăng thêm trong phương án mã hóa cục bộ. Chênh lệch thời gian giữa hai phương án là
Mã hóa ở biên nhanh hơn khi . Giả sử đầu cuối là một máy để bàn với RTX 4090, và phía từ xa là một H100 SXM. Mã hóa một ảnh cần 1,31 TFLOPs phép toán ma trận; dùng các đỉnh BF16 dense lần lượt là 165,2 và 989,4 TFLOP/s, cận dưới thời gian mã hóa khoảng 7,9 ms và 1,3 ms. Lấy , phương án mã hóa cục bộ cần khoảng 10,25 giây, và phương án mã hóa từ xa cần khoảng 1,00 giây. Phương án cục bộ chậm hơn ở cả tính toán lẫn truyền tải: tính toán cục bộ nhiều hơn khoảng 6,6 ms, và truyền đặc trưng nhiều hơn khoảng 9,2 giây.
Khi liên kết nhanh dần, thời gian tăng thêm do gửi đặc trưng thay vì ảnh sẽ co lại. Nếu encoder và model ngôn ngữ nằm trên hai máy chủ trong cùng một trung tâm dữ liệu, nối qua một cổng ConnectX-7 400 Gbit/s (50 GB/s mỗi chiều), chênh lệch thời gian gửi giữa ảnh và đặc trưng chỉ còn khoảng 0,15 ms, đã nhỏ hơn chênh lệch thời gian mã hóa giữa hai thẻ ở trên. Trong trường hợp đó, chỉ khi tiết kiệm được hơn 0,15 ms ở mã hóa cùng xếp hàng thì phương án mã hóa trên máy khác mới nhanh hơn; trên đường lên chậm ban đầu, phải tiết kiệm hơn 9 giây. Quyết định đặt encoder ở đâu vì thế có nghĩa là so sánh khối lượng truyền trên liên kết chậm, và so sánh thời gian mã hóa cùng xếp hàng trên liên kết nhanh.
Trong các tác vụ nhiều lượt, các ảnh lặp lại có thể tái sử dụng EC (encoding cache — bộ nhớ đệm mã hóa), tiếp tục giảm số phép mã hóa. Khi cùng một ảnh xuất hiện lại, một cache hit tiết kiệm một lượt mã hóa; khi nội dung giao diện thay đổi, cần mã hóa lại. Một loạt thí nghiệm CPU dùng các ảnh cùng kích thước quan sát được hành vi tương tự. Khi tính tổng thời gian mã hóa qua nhiều lượt, có thể nhân thời gian mã hóa đơn với số cache miss. Cache còn lại từ các lượt trước do đó đã được tính vào so sánh.
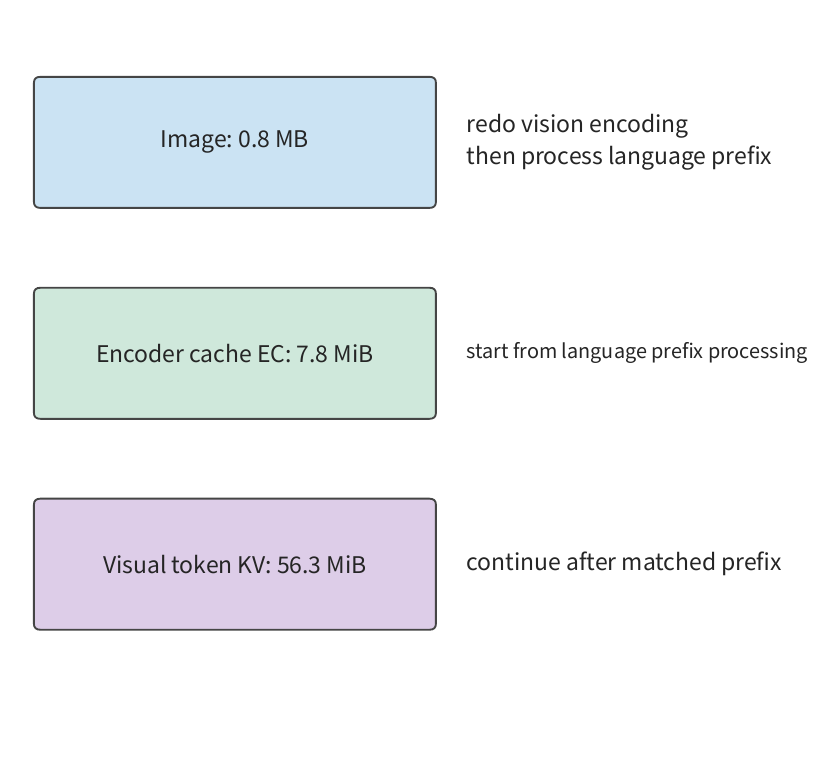
Các đặc trưng thị giác chỉ tiết kiệm bước mã hóa thị giác; nếu muốn tái sử dụng các kết quả mà model ngôn ngữ đã tính, ta phải lưu KV mà model ngôn ngữ sinh theo từng tầng khi xử lý prefix. Trong cấu hình này, mỗi token đầu vào của model ngôn ngữ cần 144 KiB lưu trữ KV logic, nên 400 vision token cần khoảng 56,3 MiB. Ảnh, các đặc trưng thị giác khoảng 7,8 MiB, và KV của vision token khoảng 56,3 MiB tương ứng với ba điểm khởi động tái tính toán khác nhau (Hình 12-13). Bộ đệm càng gần đầu ra cuối cùng của model, càng tiết kiệm được nhiều tính toán khi tái sử dụng, nhưng dữ liệu có thể cần truyền càng lớn. Mục 12.2.3 so sánh mất bao lâu để truyền một phần trạng thái một lần với bao nhiêu thời gian tiết kiệm được nhờ tái sử dụng phần trạng thái đó sau này.
12.2.3 Chuẩn bị, tái sử dụng và khôi phục trong di trú phiên
Di trú phiên (session migration) chuyển cache và tiến độ tác vụ sang một thiết bị khác, để thiết bị nhận tiếp tục thực thi. Khi thiết bị đích đã có các trọng số tương thích, thứ cần chuyển là cache mã hóa, KV của model ngôn ngữ, bản ghi tác vụ và thông tin khôi phục. Sau khi xác nhận định dạng trạng thái ở hai đầu tương thích, ta có thể so sánh thời gian chuẩn bị trước khi di trú với thời gian tiết kiệm được mỗi vòng sau khi di trú.
Gọi thời gian chuẩn bị cần cho di trú là , thời gian tiết kiệm được mỗi vòng trên thiết bị mới là , và số vòng còn lại là . Chênh lệch thời gian giữa việc tiếp tục trên thiết bị gốc và di trú sang thiết bị mới là
nghĩa là di trú có lợi. Mỗi vòng tăng thêm làm tăng lợi ích thêm ; thời gian chuẩn bị dịch toàn bộ đường lợi ích xuống dưới. Vậy cùng một lần di trú không đáng làm đối với tác vụ ngắn nhưng đáng làm đối với phiên dài.
Ví dụ: Cần thêm bao nhiêu vòng tương tác trước khi di trú trạng thái tiết kiệm thời gian? Di trú đòi hỏi truyền 64 MiB trạng thái qua một liên kết 80 Mbit/s, sau đó dành 1 giây để khôi phục. Tổng thời gian chuẩn bị di trú là
Với 0,4 giây tiết kiệm được mỗi vòng, 10 vòng cho lỗ ròng khoảng 3,7 giây, 20 vòng cho lãi ròng khoảng 0,3 giây, và 40 vòng cho lãi ròng khoảng 8,3 giây. Giải với chưa làm tròn cho tối thiểu 20 vòng. Số vòng này cho biết chi phí di trú bắt đầu được bù đắp từ khi nào; độ lớn của lãi ròng cho biết khoản chi phí tăng thêm nào đáng chấp nhận cho sự chuyển đổi này.
Trong Hình 12-14, lãi ròng bắt đầu âm ngay sau khi di trú, rồi tăng 0,4 giây sau mỗi vòng hoàn thành. Số vòng hòa vốn tương ứng với điểm đường cong cắt đường zero.
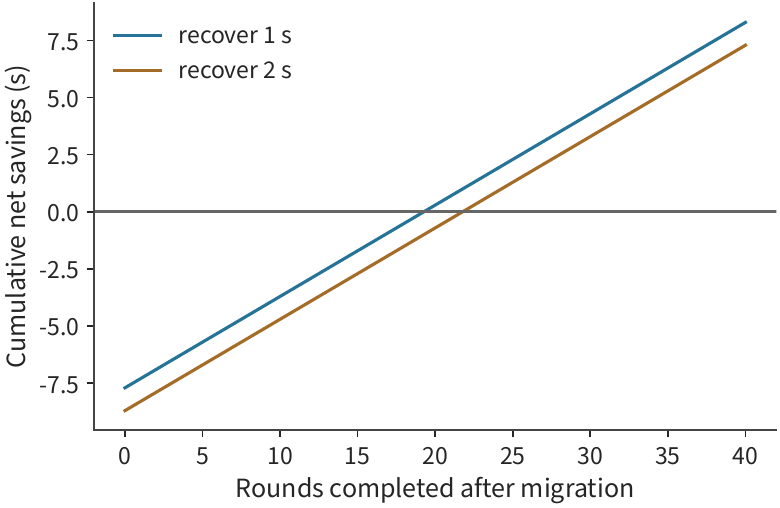
Chẳng hạn, nếu thời gian khôi phục tăng thêm 1 giây nữa, lãi ròng ở vòng 20 lập tức trở thành khoảng −0,7 giây, và số vòng hòa vốn tăng lên 22. Nếu sau đó còn thêm 40 vòng nữa, 1 giây tăng thêm này vẫn chừa lại khoản tiết kiệm khoảng 7,3 giây. Các hệ thống đã triển khai vì thế cần dự đoán độ dài phiên còn lại và chừa dư cho chi phí truyền và khôi phục tăng thêm.
“Thời gian khôi phục” trong đường cong bao gồm công việc chuẩn bị mà thiết bị mới cần trước khi có thể tiếp tục thực thi. Ngoài việc nạp dữ liệu cache vào bộ nhớ, thiết bị mới còn phải xác định tác vụ đã tiến triển đến đâu. KV của model ngôn ngữ gắn với model, prefix và chỉ số vị trí token; tiến độ của agent chụp màn hình được quyết định bởi các thao tác đã thực thi. Một cú nhấp đã làm thay đổi giao diện, nên ngay cả khi phản hồi bị mất, trạng thái vẫn phải được khôi phục về trạng thái sau cú nhấp. Số hiệu thao tác và bản ghi gửi giúp thiết bị đích tra cứu các kết quả hiện có và tiếp tục từ vòng kế tiếp. Lưu các bản ghi này tránh phải thực thi lại thao tác, giống như tái sử dụng cache tránh phải tính toán lại.
Làm nóng kết nối, biên dịch đồ thị và nạp model cũng có thể được phân tích bằng : đưa chi phí chuẩn bị vào , và đưa thời gian chờ giảm đi trên mỗi lần gọi sau vào . Việc chuẩn bị này có đáng hay không phụ thuộc vào việc thời gian tiết kiệm được ở các lần gọi sau có bù đắp chi phí chuẩn bị một lần hay không.
12.2.4 Ranh giới truyền thông trong phân chia nội bộ model
Di trú phiên chỉ chuyển trạng thái một lần, khi đổi thiết bị. Một sự phân công lao động khác cho phép nhiều thiết bị cùng thực thi model liên tục, trong trường hợp đó truyền thông diễn ra lặp lại trong khi thực thi. Khi model được phân chia theo giai đoạn, mỗi đầu vào thường chỉ cần truyền một lần giữa các giai đoạn kề nhau; với tensor parallelism, tính toán của mọi tầng đều cần truyền thông. Một khi liên kết đổi từ liên kết liên thẻ sang mạng cục bộ, việc đồng bộ hóa thường xuyên cộng dồn những độ trễ nhỏ mỗi lần gọi thành một chi phí lớn.
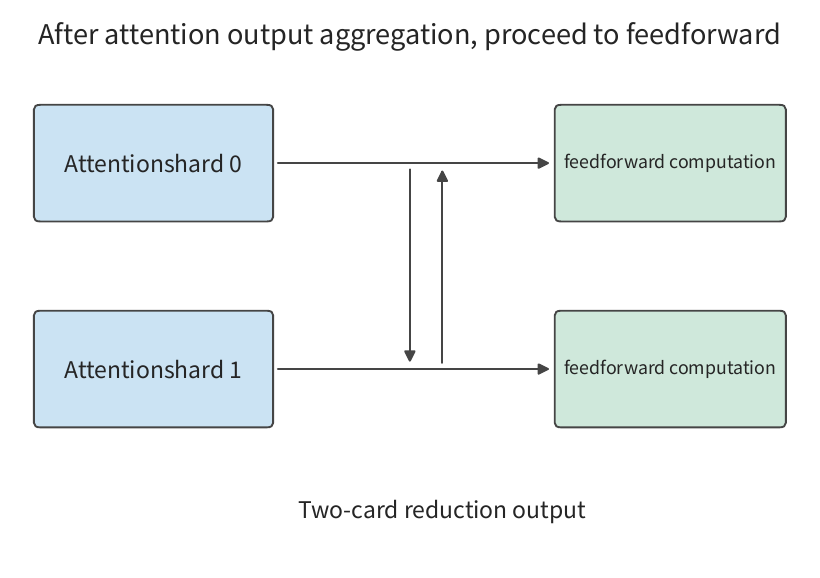
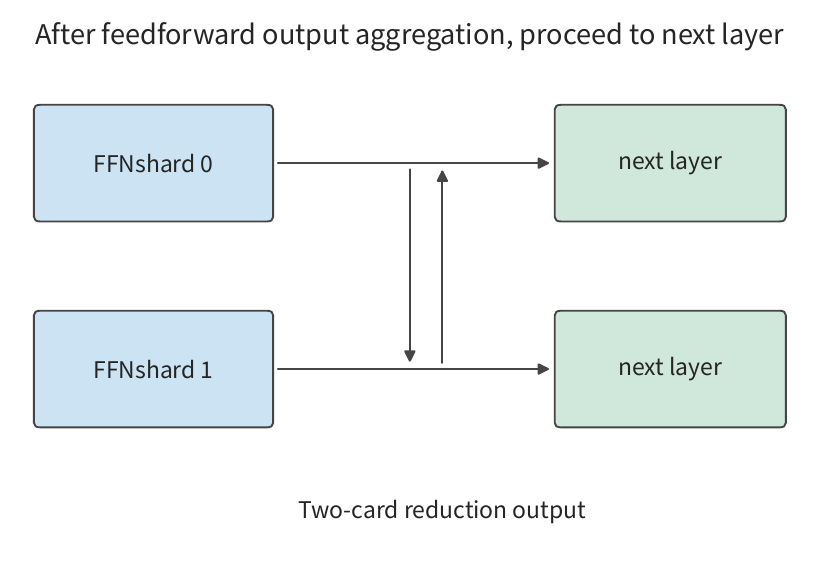
Lấy Qwen3-8B 36 tầng chạy tensor parallelism (TP=2) trên hai thiết bị làm ví dụ, và xét hai phép reduction mỗi tầng cho đầu ra attention và đầu ra FFN; một phép reduction cộng các kết quả bộ phận của hai thiết bị để tính toán tiếp theo nhận được đầu ra hoàn chỉnh. Dùng thuật toán vòng hai pha (bản cài đặt dựa trên vòng trong Chương 7, trước tiên làm ReduceScatter rồi AllGather), mỗi phép reduction có hai sự kiện khởi động, và thời gian khởi động của mỗi pha là ; nên khi sinh một token, tổng thời gian khởi động cho các phép reduction này là
Với μs, con số này là khoảng 0,29 ms. Nếu hai thiết bị thay vào đó kết nối qua loại Wi-Fi 54 Mbit/s không tổng hợp được mô tả trong Mục 12.4.1, mỗi pha đòi hỏi ít nhất một trao đổi khung ngắn; ở mức trao đổi khung ngắn kèm ACK 134 μs của mục đó, 144 lần khởi động sẽ mất khoảng 19,3 ms — hơn gấp đôi cận dưới đọc một bước decode 9,12 ms của RTX PRO 6000. Ngay cả với payload cực nhỏ, khởi động truyền thông vẫn tốn thời gian; và tầng kế tiếp cần kết quả reduction của tầng hiện tại, giống như việc sinh tự hồi quy token kế tiếp cần đầu ra của token hiện tại. Vì các bước này phải thực thi nối tiếp, mọi thời gian khởi động truyền thông đều cộng dồn vào thời gian hoàn thành của một token.
Các Hình 12-15 và 12-16 lần lượt mở rộng đầu ra attention của một tầng và đầu ra feedforward; cả hai đều phải đi qua một phép reduction dọc theo hướng thực thi trước khi tầng kế tiếp có thể bắt đầu. Một lần chờ đơn lẻ là ngắn, nhưng số lần lặp lại được quyết định bởi cấu trúc của model.
Không giống đồng bộ hóa từng tầng của tensor parallelism, pipeline parallelism chia các tầng thành các giai đoạn liên tiếp, tập trung truyền thông vào việc chuyển activation giữa các giai đoạn kề nhau. Với một request đơn, một token vẫn cần đi qua từng giai đoạn theo thứ tự; với nhiều request độc lập, các giai đoạn khác nhau có thể xử lý các request khác nhau đồng thời. Điều này sinh ra hai loại lợi ích: ít sự kiện truyền thông hơn rút ngắn thời gian chờ của một request đơn, và để các giai đoạn khác nhau xử lý request đồng thời sẽ nâng thông lượng tổng thể. Khi chọn giữa tensor parallelism và pipeline parallelism, trước tiên hãy vẽ đồ thị phụ thuộc cho một token, rồi sắp xếp cách nhiều request chiếm tài nguyên của mỗi giai đoạn, và hai hiệu ứng có thể được tính riêng.
Một khi phân công lao động của model được xác định, gửi gì, gửi bao nhiêu lần, và phép tính nào phải chờ truyền tải đều đã rõ. Mục 12.3 xem xét quá trình gửi thực tế: sau khi dữ liệu sẵn sàng, liệu kết nối đã được thiết lập chưa, cửa sổ có cho phép gửi không, và các gói xác nhận có về kịp thời gian không.
12.3 Chi phí bổ sung và thời gian chờ trong truyền tải mạng diện rộng
12.3.1 Thiết lập kết nối và tái sử dụng
Mục 12.1 giả định kết nối đã được thiết lập và liên kết truyền dữ liệu với tốc độ không đổi. Trên thực tế, một request trước tiên phải thiết lập một kết nối và một ngữ cảnh bảo mật — các khóa, danh tính và trạng thái phiên mà hai bên truyền thông duy trì cho việc xác thực và mã hóa; sau đó nó phải có được hạn mức gửi, và cuối cùng chờ bên nhận chuyển dữ liệu cho ứng dụng. Cộng các thời gian chờ này vào mô hình thời gian của Mục 12.1 cho phép ta phân tích quá trình thực thi thực tế: dữ liệu có thể đã sẵn sàng, nhưng vẫn chưa thể tính toán hoặc gửi nó ngay.
Các thời gian chờ này liên quan đến các giao thức sau. HTTP là giao thức tầng ứng dụng tổ chức các request và response. HTTP/1.1 và HTTP/2 thường dùng TCP (giao thức vận chuyển cung cấp dòng byte đáng tin cậy, có thứ tự) cùng với TLS (giao thức bảo mật thiết lập ngữ cảnh xác thực và mã hóa); HTTP/3 dùng QUIC (giao thức cung cấp truyền tin đa luồng đáng tin cậy và quản lý kết nối trên datagram UDP). UDP cung cấp các datagram độc lập cho ứng dụng và tự nó không xử lý việc truyền lại hay thứ tự. QUIC kết hợp bắt tay vận chuyển với TLS 1.3, giảm số vòng khứ hồi cần để thiết lập riêng một kết nối vận chuyển và một ngữ cảnh bảo mật. Trong quá trình tiếp tục phiên (session resumption), client cũng có thể gửi dữ liệu sớm — dữ liệu 0-RTT — dựa trên trạng thái bảo mật đã lưu. Nếu máy chủ chấp nhận, việc xử lý tiếp tục; nếu bị từ chối, client gửi lại; máy chủ xác định các lần thử bằng số hiệu thao tác và trả về kết quả đã lưu trước đó, nên cùng một thao tác không bị thực thi hai lần.
Thay chi phí thiết lập kết nối vào tác vụ chụp màn hình của Mục 12.1: tiếp tục với RTT 200 ms của tác vụ chụp màn hình 30 vòng, giả sử việc thiết lập một kết nối cần thêm hai vòng khứ hồi. Dựng lại kết nối mỗi vòng tốn 12 giây cộng dồn; chỉ thiết lập ở vòng đầu tiên tốn 0,4 giây, tiết kiệm được 11,6 giây. Tái sử dụng kết nối có hiệu quả vì 29 vòng còn lại dùng chung trạng thái được thiết lập ở vòng đầu. Con số 105 giây của Mục 12.1 được tính với giả định kết nối đã được thiết lập; cộng thêm thiết lập kết nối ban đầu cho 105,4 giây, còn dựng lại mỗi vòng cho 117 giây.
Thiết lập kết nối là chi phí một lần, trong khi truyền diễn ra mỗi vòng. Khi request thường xuyên, giữ kết nối sống tiết kiệm thời gian thiết lập kết nối của vòng kế tiếp; khi khoảng cách giữa các request dài, một kết nối rảnh vẫn chiếm bộ nhớ và các tài nguyên khác. Đóng kết nối giải phóng các tài nguyên này, nhưng lần gọi sau phải thiết lập lại kết nối. Như với di trú phiên, đây lại là việc so sánh chi phí chuẩn bị một lần với lợi ích của nhiều lần sử dụng sau đó.
12.3.2 Cửa sổ, phản hồi và thông lượng hiệu dụng
Tái sử dụng kết nối tránh được thời gian chờ thiết lập kết nối, nhưng gửi dữ liệu liên tục vẫn đòi hỏi một cửa sổ gửi đủ lớn. Một khi kết nối được thiết lập, bên gửi cũng phải giới hạn lượng dữ liệu đang bay (in flight). Cửa sổ tắc nghẽn (congestion window) giới hạn lượng dữ liệu đã gửi nhưng chưa được xác nhận; điều khiển luồng của bên nhận giới hạn bên gửi còn có thể gửi thêm bao nhiêu, dựa trên dung lượng bộ đệm của chính bên nhận. Khi một ACK tới, bên gửi có thể tiếp tục gửi; khi bên nhận đọc dữ liệu ra khỏi bộ đệm, nó cũng thông báo cho bên gửi về khoảng trống mới. Khi đạt giới hạn gửi, bên gửi phải chờ các thông báo này ngay cả khi liên kết đang rảnh.
Dữ liệu đang bay là số byte đã gửi nhưng chưa được xác nhận. Nếu lượng cho phép đang bay là và thời gian khứ hồi là , thì mỗi chu kỳ khứ hồi tối đa truyền được khoảng một cửa sổ dữ liệu, nên
Ở đây là tốc độ payload mà đường truyền có thể cung cấp, và là thông lượng hiệu dụng thực tế. Với đường truyền ảnh trong Mục 12.1.1 có băng thông 20 Mbit/s và RTT 100 ms, giữ liên kết liên tục đầy đòi hỏi khoảng 250 KB dữ liệu đang bay. Với hạn mức chỉ 64 KB, giới hạn tốc độ là byte/s, khoảng 5,1 Mbit/s, nên chỉ riêng việc gửi 30 MB dữ liệu này đã mất ít nhất khoảng 47 giây. Liên kết có thể mang nhiều dữ liệu hơn mỗi giây, nhưng bên gửi phải chờ lô xác nhận kế tiếp trước khi có thể tiếp tục gửi; chỉ bằng cách mở rộng cửa sổ khả dụng, tốc độ truyền thực tế mới có thể tăng trong tình huống này.
Xét một model có xác nhận theo lô trong điều kiện tách biệt: bên nhận chỉ xác nhận sau khi thu đủ một lô 64 KB, và thời gian từ lúc gửi xong lô đó đến khi nhận được xác nhận là cố định 100 ms. Vậy chu kỳ hoàn chỉnh gồm 25,6 ms gửi và 100 ms phản hồi, tổng cộng 125,6 ms. Hình 12-17 minh họa khoảng chờ này. Các đoạn màu xanh là các khoảng gửi thực tế; các đoạn sáng là các khoảng liên kết rảnh dù về mặt vật lý vẫn tự do, vì cửa sổ của bên gửi đã đầy và không thể tiếp tục. Nâng băng thông vật lý chỉ có thể rút ngắn phần màu xanh.
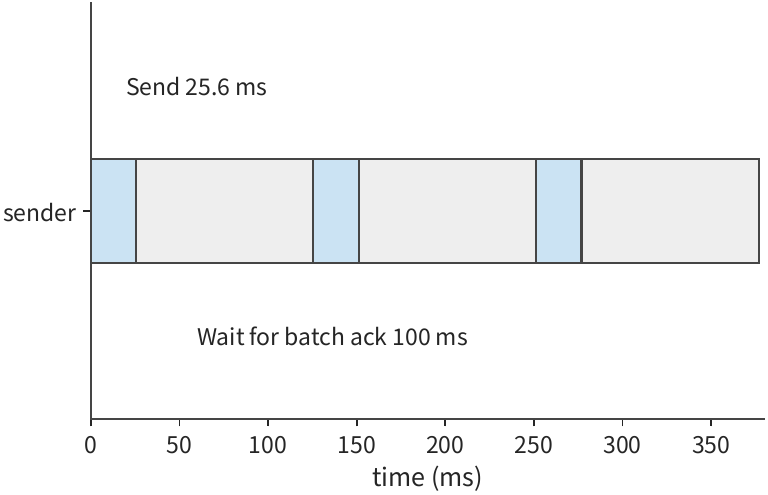
Hình 12-17 cố định cửa sổ ở 64 KB để cô lập quá trình dừng rồi đợi. Các kết nối mới thường bắt đầu với cửa sổ nhỏ hơn và tăng dần khi các xác nhận tới; các request ngắn có thể hoàn thành trước khi cửa sổ tăng hết cỡ. Giả sử cửa sổ ban đầu là mười phân đoạn 1460 byte, tăng gấp đôi sau mỗi vòng phản hồi. Trong bốn vòng đầu, lượng tích lũy có thể gửi là byte, và đến vòng thứ năm tổng tích lũy đạt 452.600 byte. Một request giọng nói khoảng 355 KB do đó không thể gửi xong trước vòng thứ năm. Với RTT 200 ms, vài vòng phản hồi đã cộng thành hàng trăm mili giây; phần lớn thời gian của một request ngắn có thể nằm ở việc chờ xác nhận. Mục 12.3.5 sẽ dùng cơ chế này để giải thích một quan sát về hiệu năng từ một cuộc gọi giọng nói xuyên vùng.
Cửa sổ giải thích vì sao việc gửi phải tạm dừng. Tổng thời gian request cũng phụ thuộc vào chính xác có bao nhiêu byte cần gửi: thứ đi qua mạng không chỉ là ảnh, mà còn cả header và các gói xác nhận.
Ví dụ: Header giao thức và ACK làm tăng thời gian truyền ảnh như thế nào? Tiếp tục với việc tải lên 30 MB và tải xuống 5 MB, lấy payload tối đa mỗi gói là 1168 byte, header giao thức và mạng là 60 byte, và mỗi gói dữ liệu kích hoạt một ACK 92 byte. Có khoảng ba mươi nghìn gói dữ liệu tổng cộng; header và xác nhận thêm vào khoảng MB, nên lượng thực tế truyền tăng từ 35 MB lên khoảng 39,6 MB. Tính thời điểm của từng lần gửi, xác nhận và gói gửi tiếp theo theo từng gói, request hoàn chỉnh mất khoảng 14,4 giây.
So với 12,8 giây, khoảng gần 1,6 giây tăng thêm đến từ công việc và thời gian chờ mới được thêm vào mô hình. Chỉ nhìn số byte thực tế truyền vẫn chưa đủ: một ACK vừa chiếm liên kết vừa giải phóng hạn mức gửi tiếp theo, nên giảm số ACK đồng thời thay đổi cả mức chiếm liên kết lẫn thời điểm giải phóng hạn mức.
Hành vi xác nhận thực tế được quyết định bởi thuật toán điều khiển tắc nghẽn. NewReno là một thuật toán điều chỉnh cửa sổ tắc nghẽn dựa trên mất gói và xác nhận; CUBIC điều chỉnh cửa sổ trong pha tránh tắc nghẽn theo một hàm bậc ba của thời gian; khởi động chậm (slow start) là pha đầu của một kết nối trong đó cửa sổ tăng nhanh theo từng xác nhận. Dưới cùng một phương pháp điền dữ liệu và cấu hình NewReno, đổi từ xác nhận ngay lập tức sang xác nhận mỗi hai gói hoặc chờ tối đa 10 ms làm lượng dữ liệu thực tế truyền giảm từ khoảng 39,6 MB xuống 38,2 MB, nhưng thời gian request hoàn chỉnh tăng từ khoảng 14,52 giây lên 14,56 giây — muộn hơn khoảng 43 ms. So sánh này hé lộ vai trò kép của phản hồi: gửi ít xác nhận hơn rút ngắn thời gian truyền, nhưng xác nhận đến muộn làm kéo dài thời gian chờ cửa sổ. Việc hoàn thành tổng thể có nhanh hơn hay không phụ thuộc vào việc so sánh thời gian truyền tiết kiệm được với thời gian chờ tăng thêm.
ACK quyết định khi nào bên gửi có thể tiếp tục dùng cửa sổ để gửi dữ liệu; điều khiển tắc nghẽn quyết định bản thân cửa sổ thay đổi như thế nào. Trong một so sánh truyền ảnh lớn trên cùng đường truyền, cả NewReno lẫn CUBIC đều cho thời gian phản hồi hoàn chỉnh khoảng 14,5 giây; dấu vết cửa sổ cho thấy CUBIC nằm trong pha khởi động chậm suốt qua. Request cụ thể này kết thúc trước khi CUBIC từng bước vào pha tránh tắc nghẽn, nên thứ quan sát được là hành vi pha khởi động.
12.3.3 Mất gói có giống tắc nghẽn không?
Cửa sổ trong Mục 12.3.2 tăng theo xác nhận và cũng co lại theo mất gói. Điều khiển tắc nghẽn TCP truyền thống không đo trực tiếp băng thông đường truyền; thay vào đó, nó coi mất gói là tín hiệu tắc nghẽn và suy ra tốc độ khả dụng từ tỷ lệ mất gói. Mô hình Mathis là một công thức ước tính thông lượng TCP ở trạng thái ổn định từ tỷ lệ mất gói, và nó cho cận trên của tốc độ có thể đạt được từ phép suy ra này:
trong đó MSS (kích thước phân đoạn tối đa) là payload tối đa mỗi gói, là thời gian khứ hồi, và là tỷ lệ mất gói; với mất gói tuần hoàn và xác nhận từng gói, , còn với xác nhận trễ (bên nhận chỉ xác nhận mỗi hai gói), ; do đó phương trình (4) của bài báo bỏ hằng số và cho cận trên đơn giản hóa . Theo công thức này, thông lượng được quyết định bởi tỷ lệ mất gói: tỷ lệ mất gói tăng gấp bốn làm tốc độ giảm một nửa. Công thức này tiền giả định mất gói kéo theo tắc nghẽn; lỗi bit trên các liên kết không dây và mất gói ngẫu nhiên trên các đường xuyên vùng không thỏa mãn tiền giả định này.
Các phép đo trên đường xuyên vùng đúng là trường hợp thứ hai. Bản ghi đường truyền của Queqiao, một hệ thống truyền mạng diện rộng do tác giả phát triển (giới thiệu trong Mục 12.3.5), cho một đường truyền trong đó mất gói không mang thông tin tắc nghẽn. Với hướng tải xuống từ Irvine đến Quý Dương, khi tốc độ gửi tăng từ 1 lên 300 Mbit/s, tỷ lệ mất gói giữ ở khoảng 14% suốt quá trình, với các lần mất không phụ thuộc lẫn nhau trước và sau; theo hướng ngược lại, từ Quý Dương đến Irvine, không một gói nào trong 41.663 gói bị mất — hai hướng của cùng một đường truyền hành xử như hai đường truyền khác nhau. Chênh lệch giữa thời gian khứ hồi nhỏ nhất và lớn nhất chỉ là vài mili giây, cho thấy không có xếp hàng trên đường truyền. Chỉ khi tốc độ tăng lên 600 Mbit/s tỷ lệ mất gói mới leo lên 44% — vượt qua điểm gối (knee) dung lượng khoảng 333 Mbit/s (điểm mà ngoài đó tỷ lệ mất gói tăng vọt khi tốc độ tiếp tục tăng); chỉ mất gói ngoài điểm này thực sự đến từ tắc nghẽn. Thay MSS = 1.448 byte, s, vào cận trên đơn giản hóa của phương trình (4) (, như được dùng trong bản ghi đường truyền) cho
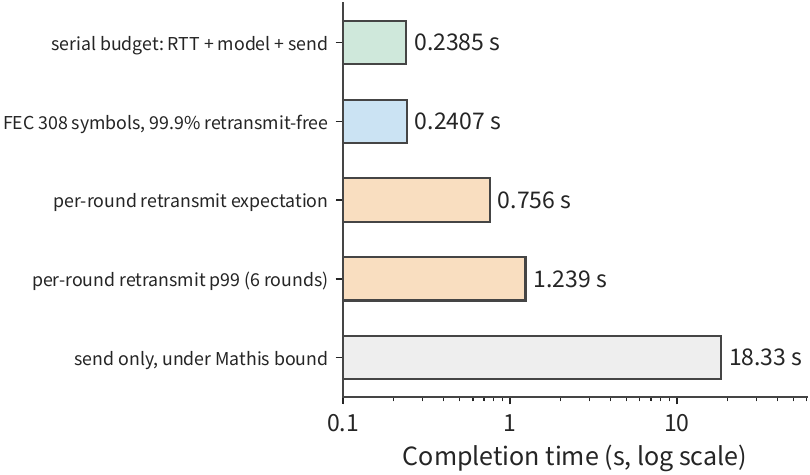
hay 0,189 Mbit/s với ; cả hai đều khớp với mức đo được 0,13–0,47 Mbit/s của cùng đường truyền. Request giọng nói khoảng 355 KB (354.640 byte) ở Mục 12.3.2, ở tốc độ này, sẽ mất khoảng 18,3 giây chỉ để gửi. TCP không trục trặc: nó phản ứng với mất gói đúng như quy định — chỉ là trên đường truyền này, mất gói không mang thông tin tắc nghẽn. Đây là một ví dụ cực đoan của loại khoảng cách thứ nhất được thảo luận trong Mục 1.3.4: tiền giả định của mô hình không đứng vững, và cận trên tính được thấp hơn ba bậc độ lớn so với thứ đường truyền thực sự có thể mang. Thứ cần sửa là giả định của mô hình, không phải bản cài đặt giao thức vận chuyển.
BBR: đo trực tiếp, thay vì suy ra từ mất gói. BBR (bottleneck bandwidth and round-trip propagation time — băng thông nút thắt và thời gian truyền lan khứ hồi, một thuật toán điều khiển tắc nghẽn dựa trên đo lường) không dùng mất gói làm tín hiệu; thay vào đó, nó liên tục đo hai đại lượng: ước tính băng thông nút thắt BBR.max_bw, giá trị tối đa theo cửa sổ của các mẫu tốc độ giao hàng gần đây; và ước tính truyền lan khứ hồi BBR.min_rtt, giá trị tối thiểu theo cửa sổ của các mẫu RTT. Nhịp gửi được đặt theo băng thông đo được; lượng đang bay được đặt theo tích băng thông-độ trễ (bandwidth-delay product, BDP), : cwnd_gain là 2, nghĩa là cửa sổ tắc nghẽn (cwnd) được đặt bằng hai lần BDP, chừa biên cho việc gộp ACK và truyền lại. Pha Startup dò trần băng thông với gain nhịp là mỗi vòng, và pha ProbeBW_UP định kỳ dò cao hơn với gain 1,25. Thay vào cùng đường truyền: MB, cửa sổ tắc nghẽn 16,65 MB; thông lượng hiệu dụng lý tưởng Mbit/s gấp khoảng 1.850 lần cận trên Mathis. Trên một đường truyền mà mất gói không mang thông tin tắc nghẽn, đo băng thông trực tiếp cho tốc độ cao hơn ba bậc độ lớn so với giới hạn suy ra từ mất gói.
Ngay cả khi băng thông đo được chính xác, phần đuôi truyền lại vẫn còn. BBR trả lời câu hỏi “gửi nhanh đến mức nào”, không phải “làm gì khi gói bị mất”. 354.640 byte chia thành 245 gói, mỗi gói mất độc lập với xác suất 14%, cho kỳ vọng mất 34,3 gói. Phần sau dùng một mô hình truyền lại chọn lọc lý tưởng theo từng vòng: mỗi vòng dành một RTT để truyền lại các gói bị mất, và gói truyền lại có thể bị mất lần nữa; việc co cửa sổ và truyền lại do timeout không được tính, nên kết quả là một cận dưới có lợi cho TCP. Không có mất gói, ngân sách nối tiếp là một RTT cộng hạng mục model 30 ms, cộng 8,5 ms gửi ở tốc độ điểm gối, tổng cộng khoảng 238,5 ms; có mất gói, thời gian hoàn thành kỳ vọng là 0,756 s, gấp khoảng 3,2 lần ngân sách nối tiếp; p99 là 1,24 s, tương ứng 6 vòng. Ngay cả khi BBR đo băng thông chính xác, độ trễ đuôi (tail latency) do truyền lại dưới tỷ lệ mất gói ngẫu nhiên cao vẫn tồn tại — đây không phải vấn đề điều khiển tắc nghẽn có thể giải quyết.
Dư thừa mã hóa: để bên nhận khỏi phải chờ truyền lại. Vì chờ truyền lại là điều không thể chấp nhận, người ta có thể thay vào đó gửi thêm dữ liệu dư thừa, để bên nhận tự sửa các gói bị thiếu. Sửa lỗi chủ động (forward error correction, FEC) gửi thêm biểu tượng sửa lỗi ngoài biểu tượng dữ liệu; trong ví dụ này, một biểu tượng là một gói cỡ MSS; miễn là trong một khối không có quá biểu tượng bị mất, bên nhận có thể khôi phục trực tiếp, không cần vòng truyền lại nào. Giải chính xác qua phân phối nhị thức cho độ dư thừa tối thiểu cần để đạt 99,9% thành công: ở tỷ lệ mất 14%, 245 gói dữ liệu cần 63 gói sửa lỗi, độ dư thừa 25,7%; lượng gửi tăng lên 308 biểu tượng, mất khoảng 10,7 ms để gửi, cho thời gian hoàn thành khoảng 241 ms — gần với ngân sách nối tiếp 238,5 ms (Hình 12-18). Trong một khoảng thời gian khác trên cùng đường truyền với tỷ lệ mất 3,6%, p99 của truyền lại theo từng vòng giảm xuống 0,84 s, trong khi FEC chỉ cần 20 gói sửa lỗi, độ dư thừa 8,2%. Vậy tỷ lệ dư thừa nên được điều chỉnh theo tỷ lệ mất gói đo được, không phải cố định. Các con số này cũng là động lực định lượng cho tình huống Queqiao trong Mục 12.3.5: việc sửa lỗi chủ động và lập lịch gửi của hệ thống đặt lượng dư thừa và nhịp gửi một cách chính xác theo các phép đo đường truyền.
12.3.4 Luồng ghép kênh (multiplexed) và ưu tiên
Các mục trước thảo luận về việc truyền một luồng dữ liệu đơn lẻ; mục này xem xét các hiệu ứng tương hỗ khi nhiều luồng chia sẻ cùng một lối ra (egress). Khi ảnh, âm thanh và thông điệp điều khiển chia sẻ một lối ra, hai thứ tự có thể thay đổi: lịch gửi quyết định dữ liệu của ai được liên kết truyền trước, và yêu cầu về thứ tự của bên nhận quyết định khi nào các byte đã tới được chuyển cho ứng dụng.
Bắt đầu với việc phân bổ tài nguyên. Trong một tập hợp các phép tính chia sẻ một liên kết, FIFO gửi theo thứ tự xếp hàng: ảnh hoàn thành ở giây thứ 5, âm thanh ở giây thứ 6. Khi âm thanh được ưu tiên, âm thanh hoàn thành ở giây thứ 3 và ảnh ở giây thứ 6. Âm thanh hoàn thành sớm hơn 3 giây và ảnh muộn hơn 1 giây, vì dữ liệu âm thanh giờ chiếm các khe thời gian lẽ ra thuộc về ảnh.
Giờ xét các phụ thuộc phía nhận. Giữ nguyên thời điểm gửi và thời gian khôi phục mất gói, dữ liệu âm thanh hoàn chỉnh ở giây thứ 3, nhưng ảnh không hoàn chỉnh cho đến giây thứ 7. Ở đây ta gọi việc chuyển dữ liệu nhận được cho ứng dụng là giao hàng (delivery). Khi toàn bộ kết nối chia sẻ một thứ tự giao hàng duy nhất, một lỗ hổng ở phần trước luồng chặn dữ liệu phía sau — đây là chặn đầu hàng (head-of-line blocking). Dưới thứ tự giao hàng trên toàn kết nối, âm thanh vẫn phải chờ đến giây thứ 7 mới được chuyển cho ứng dụng (Hình 12-19); dưới thứ tự giao hàng theo từng luồng, âm thanh có thể được chuyển cho ứng dụng ngay khi hoàn chỉnh ở giây thứ 3, trong khi ảnh vẫn được giao ở giây thứ 7 (Hình 12-20). 4 giây tiết kiệm được ở đây đến từ việc âm thanh không còn phải chờ tiến độ nhận của ảnh — lượng dữ liệu gửi và tốc độ liên kết không đổi.
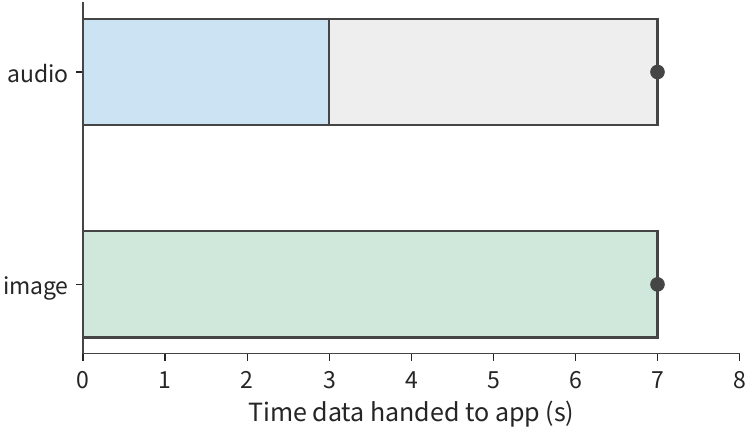
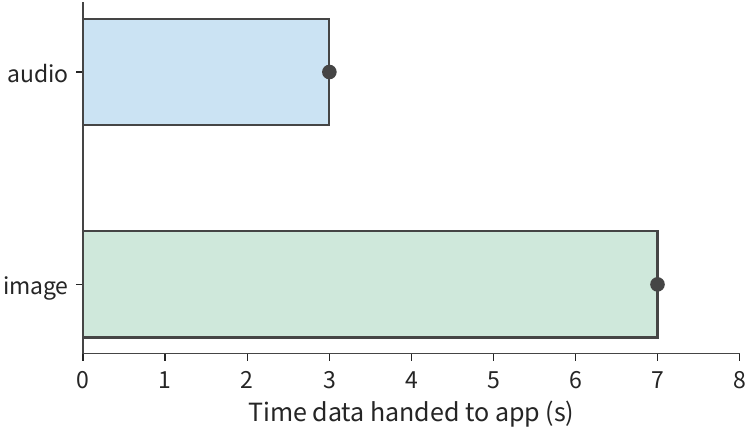
Sự phân biệt giữa thứ tự toàn kết nối và giao hàng theo từng luồng tương ứng chính xác với cách tiếp cận của hai giao thức thực tế. HTTP/2 đặt nhiều luồng vào một dòng byte TCP có thứ tự duy nhất, nên một lỗ hổng ở phần trước luồng chặn các byte phía sau nó. QUIC duy trì thứ tự theo từng luồng, nên các byte đã tới liền mạch trên các luồng khác có thể được giao độc lập. Đây là cùng kiểu phân tích như quan hệ truy hồi cho việc phát âm thanh: một điều kiện chờ duy nhất bao phủ toàn bộ dữ liệu được tách thành các điều kiện chờ riêng theo từng luồng, và bất kỳ luồng nào đã thỏa điều kiện của mình đều có thể giao dữ liệu cho ứng dụng.
Hai cơ chế này lần lượt trả lời câu hỏi “gửi khi nào” và “chuyển cho ứng dụng khi nào”. Mục 12.3.5 dùng một tình huống giọng nói xuyên vùng để chỉ ra các cơ chế này ảnh hưởng đến các request thực như thế nào; Mục 12.4 sau đó kết hợp các khe phát đã lên lịch của âm thanh với việc đánh phiên bản ảnh chụp màn hình để thảo luận liệu dữ liệu được chuyển cho ứng dụng có còn giá trị hay không.
12.3.5 Tình huống: Queqiao tăng tốc dịch vụ giọng nói xuyên vùng như thế nào
Các Chương 8 và 9 đã giới thiệu batching (gom lô) và gộp chung tài nguyên cho model serving. Gộp các request từ các vùng khác nhau vào một số ít trung tâm dữ liệu cho phép nhiều request dùng chung các bản sao model và accelerator hơn, giảm dung lượng sử dụng dư thừa mà các triển khai tách rời mỗi nơi phải dành riêng, và giúp làm đầy lô dễ hơn. Triển khai tập trung vì thế có tiềm năng nâng tỷ lệ tận dụng accelerator và hạ chi phí mỗi request, với cái giá là đường mạng dài hơn cho những người dùng ở xa. Ví dụ, nếu một model giọng nói được triển khai tập trung ở Bờ Đông Hoa Kỳ, người dùng hoặc dịch vụ truy nhập ở Bờ Tây Hoa Kỳ phải gọi xuyên vùng. Ngay cả khi model trong cụm tài nguyên tính toán xong nhanh, người dùng vẫn phải chờ request được tải lên và kết quả trở về.
Queqiao là gì, và nó giải quyết vấn đề gì? Queqiao là phần mềm mã nguồn mở, tự triển khai được, mang lưu lượng TCP và UDP giữa một client được kiểm soát và một gateway đáng tin cậy. Ứng dụng kết nối với client qua một proxy SOCKS5 cục bộ (một giao thức proxy đa dụng để chuyển tiếp các kết nối TCP/UDP tùy ý); client kết nối với gateway qua mạng diện rộng, và gateway chuyển tiếp request tới dịch vụ đích. Trong kiểu triển khai liên trung tâm dữ liệu này, client nằm trên máy chủ của bên gọi và gateway nằm gần dịch vụ suy luận từ xa, nên liên kết đường dài cần tối ưu được cô đặc giữa client và gateway. Ứng dụng vẫn gọi các giao diện ASR và TTS ban đầu; Queqiao chịu trách nhiệm vận chuyển request và kết quả.
README của dự án mô tả nhu cầu thực tế này: model chạy ở Hoa Kỳ, và các client phân bố ở những nơi khác nhau. ASR tải lên vài trăm KB âm thanh và trả về một dòng văn bản đã nhận dạng; TTS gửi một đoạn văn bản và nhận về vài trăm KB âm thanh. Tình huống TTS trong README trả về toàn bộ âm thanh một lần sau khi model hoàn thành — một lần truyền bùng nổ đơn lẻ; tình huống streaming trong Mục 12.1, ngược lại, bắt đầu truyền sau khi khối đầu tiên được sinh, với việc nhận và phát tiến triển liên tục song song với việc sinh. Ngay cả khi những request ngắn như vậy có thể gửi mọi byte trong vài mili giây, thiết lập kết nối, tăng trưởng cửa sổ và khôi phục mất gói mỗi cái đều có thể độc lập gây ra một vòng chờ phản hồi đường dài.
Mục tiêu thiết kế của Queqiao là giảm thời gian chờ tăng thêm này, đưa các request ngắn càng gần càng tốt với thời gian thực sự cần cho truyền lan, gửi dữ liệu và xử lý model, đồng thời cải thiện mức độ các luồng dài dùng tốt băng thông khả dụng. Queqiao cho phép nhiều luồng ứng dụng chia sẻ kết quả đo lường và trạng thái vận chuyển của đường client-gateway, tái sử dụng kết nối, và lập lịch gửi cùng khôi phục theo điều kiện đường truyền; sửa lỗi chủ động gửi một số dữ liệu dư thừa tăng thêm để bên nhận có cơ hội khôi phục các gói bị thiếu mà không phải chờ vòng truyền lại kế tiếp. Khi các luồng tương tác chung sống với các truyền tệp lớn, cũng cần lập lịch gửi để kiểm soát thời gian chờ của luồng tương tác. Các cơ chế kết nối, cửa sổ và ghép kênh được thảo luận trong các Mục 12.3.1 đến 12.3.4 cùng phục vụ các cuộc gọi xuyên vùng ở đây. Bản thân khoảng cách truyền lan vẫn quyết định thời gian bắt buộc phải trả; việc request hoàn chỉnh được tối ưu hóa có đáp ứng được hạn chót nghiệp vụ hay không quyết định liệu triển khai tập trung có phù hợp với tác vụ này.
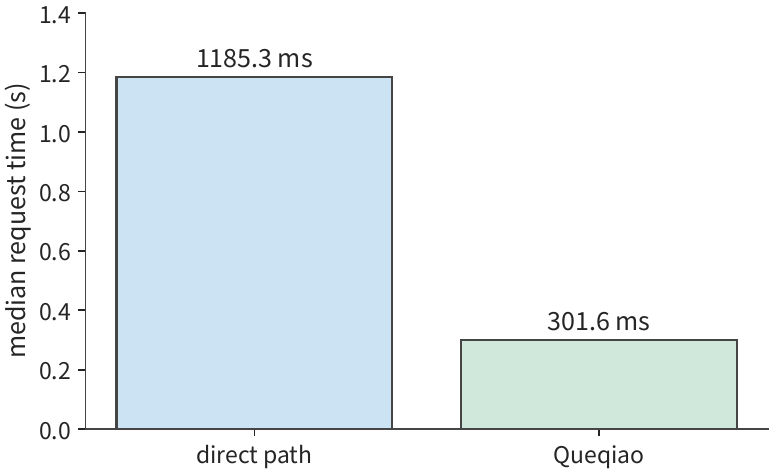
Tại sao một request giọng nói xuyên vùng lại chậm hơn nhiều so với mức lý tưởng khoảng 240 mili giây? Mục này dùng các bài kiểm tra giọng nói do tác giả lưu trữ để xem xét các cơ chế này. Đường truyền đo được thực tế chạy từ Quý Dương đến Irvine ở Hoa Kỳ — không phải ví dụ triển khai Đông-Tây Hoa Kỳ dùng ở trên. Dùng một tệp âm thanh cố định khoảng 355 KB, một liên kết 333 Mbit/s, một vòng khứ hồi khoảng 200 ms, và xử lý model khoảng 30 ms, thời gian tính từ lúc request được khởi tạo đến khi nhận được kết quả. Thời gian gửi lý tưởng khoảng 8,5 ms, và cộng truyền lan cùng xử lý cho khoảng 238,5 ms. Tuy nhiên, cuộc gọi trực tiếp ban đầu mất hơn một giây, còn Queqiao mất khoảng ba trăm mili giây.
Có hai lời giải thích khả dĩ cho khoảng cách này. Một cách quy lợi thế cho chính cơ chế vận chuyển; cách kia cho rằng phần lớn thời gian của cuộc gọi trực tiếp nằm ở thiết lập kết nối, tăng trưởng cửa sổ và chờ gửi. Hai lời giải thích đưa ra các dự đoán khác nhau: nếu thiết lập kết nối và chờ gửi là nguyên nhân chính, thì sau khi tinh chỉnh kỹ đường trực tiếp, thời gian request nên tiến tới mức tối thiểu tính được trước đó từ khối lượng dữ liệu, thời gian tính toán và các vòng khứ hồi cần thiết; nếu bản thân cơ chế giao thức vẫn mang lại lợi thế đáng kể, khoảng cách sẽ tiếp tục tồn tại.
Kiểm tra dự đoán này trước tiên đòi hỏi cố định đầu vào. Các bài kiểm tra ban đầu xoay vòng qua tám tệp 146–405 KB, nhưng báo cáo chỉ ghi nhãn kích thước của request cuối cùng (355 KB); mức trung vị được ghi nhãn kích thước đó thực ra trải toàn bộ dải. Sau khi chuyển sang gửi lặp lại cùng một tệp 354.640 byte và xen kẽ hai đường, mỗi request gửi cùng một số byte. Với khối lượng dữ liệu cố định, việc thay đổi cấu hình kết nối và gửi sau đó giúp có thể so sánh mỗi thứ ảnh hưởng đến thời gian request như thế nào.
Sau khi tái sử dụng kết nối và tinh chỉnh nó, khoảng cách giữa hai đường còn lại bao nhiêu?
Hai bộ kết quả cho tệp cố định như sau.
| Điều kiện kết nối | Thời gian request trung vị, đường trực tiếp | Thời gian request trung vị, Queqiao | Khoảng cách quan sát được |
|---|---|---|---|
| Kết nối mới | ~1,19 s | ~0,30 s | Đường trực tiếp ~3,9x |
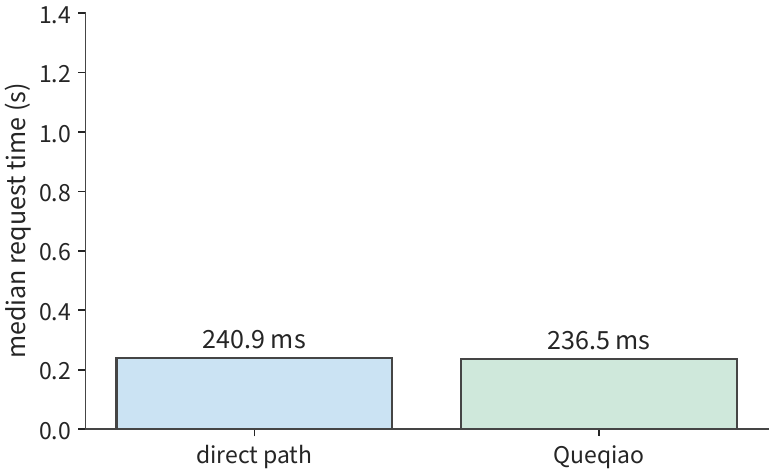
| Kết nối bền, đã tinh chỉnh | ~0,24 s | ~0,24 s | Gần như giống hệt |
Với kết nối mới, hai đường chênh nhau khoảng 0,89 giây; sau khi tái sử dụng kết nối và tinh chỉnh, cả hai đều quanh 0,24 giây (Hình 12-21, 12-22). Phần lớn khoảng cách ban đầu biến mất khi cấu hình cơ sở thay đổi. Điều này ủng hộ lời giải thích thứ hai: thiết lập kết nối và hành vi gửi là những yếu tố đóng góp chính cho khoảng cách ban đầu. Ngay cả với cùng một giao thức, các cấu hình khác nhau có thể tạo ra thời gian hoàn thành request rất khác nhau. Các bước trong tình huống này theo Mục 1.3.4: trước tiên tính một cận dưới khoảng 240 ms từ truyền lan, gửi và xử lý model; sau đó so nó với phép đo; và cuối cùng dùng một thí nghiệm chỉ thay đổi điều kiện kết nối để xác định liệu khoảng cách đến từ chi phí mô hình hay chi phí cài đặt. Ở đây khoảng cách gần như hoàn toàn đến từ chi phí cài đặt — bản thân cận dưới không sai.
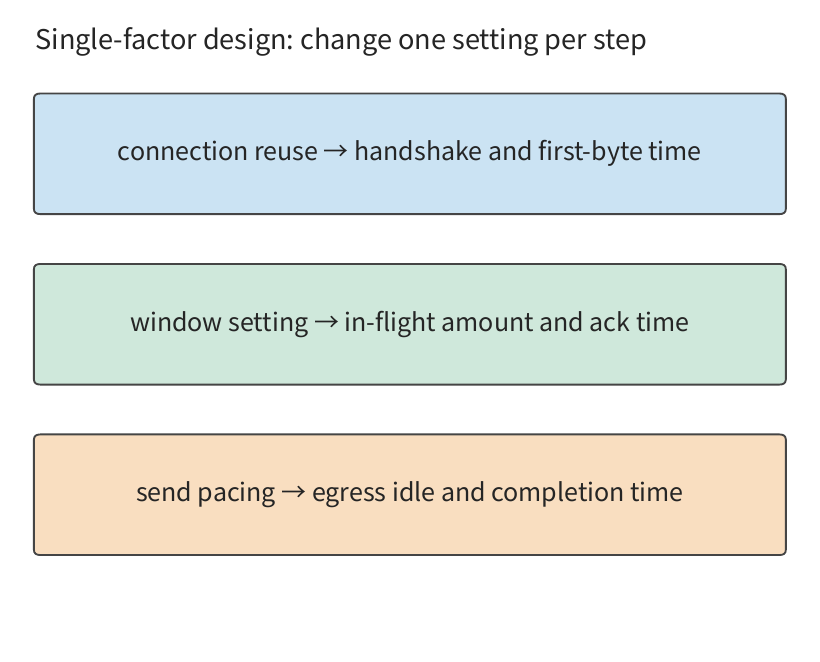
Các thí nghiệm đơn nhân tố phân biệt ảnh hưởng của kết nối, cửa sổ và nhịp gửi như thế nào? Tái sử dụng kết nối thay đổi liệu có cần bắt tay ở lúc bắt đầu request hay không, kích thước cửa sổ thay đổi lượng dữ liệu có thể đang bay trước khi một xác nhận trở về, và nhịp gửi thay đổi các khoảng rảnh trên liên kết. Hình 12-23 ghép đôi ba cài đặt này với các sự kiện tương ứng: giữ tệp, đường truyền và các cài đặt khác cố định, mỗi thí nghiệm thay đổi một nhân tố tại một thời điểm và ghi lại cả thời điểm của sự kiện bị ảnh hưởng lẫn tổng thời gian request. Thí nghiệm kết nối so sánh thời điểm hoàn thành bắt tay và thời điểm gửi byte đầu tiên; thí nghiệm cửa sổ so sánh lượng đang bay với việc gửi sau khi một ACK tới; thí nghiệm nhịp gửi so sánh thời gian rảnh giữa các lần gửi liên tiếp.
Khi cửa sổ cạn, sau khi gửi một lô dữ liệu lượng đang bay chạm trần, lối ra trở nên rảnh, và việc gửi chỉ tiếp tục khi một ACK trở về. Mở rộng cửa sổ có thể rút ngắn loại khoảng rảnh này; nếu request cũng hoàn thành sớm hơn tương ứng, dòng thời gian gửi/xác nhận cho thấy tổng thời gian giảm đến từ thay đổi cửa sổ.
Thứ tự các thí nghiệm chạy cũng ảnh hưởng đến so sánh. Xen kẽ hai đường cho phép hai request trong một so sánh nhất định chạy gần nhau về thời gian, giảm ảnh hưởng của biến động mạng lên so sánh; RTT trong khoảng này khoảng 197–205 ms, trải khoảng 8 ms. Sau khi tinh chỉnh, thời gian request trung vị của hai đường chênh nhau khoảng 4 ms — nhỏ hơn biến động RTT trong cùng khoảng. Trong tập thí nghiệm này, thời gian request của cả hai đường đã gần 240 ms.
Cái nào mang lại lợi ích lớn hơn: giảm độ trễ khứ hồi mạng, hay tăng tốc tính toán model? Một khi cấu hình cơ sở được tinh chỉnh, các ưu tiên cho tối ưu hóa tiếp theo cũng thay đổi. Tăng tốc model từ 30 ms xuống 3 ms tiết kiệm được tối đa 27 ms; giảm RTT từ 200 ms xuống 20 ms có thể tiết kiệm khoảng 180 ms. Miễn là thời gian chuẩn bị và tính toán tăng thêm do chuyển sang thực thi gần đó nhỏ hơn 180 ms này, nó sẽ nhanh hơn đường từ xa ban đầu. Đây là cùng phương pháp so sánh được dùng trong Mục 12.1: trước tiên tính chuyển đổi máy chủ tiết kiệm được bao nhiêu thời gian chờ, rồi trừ đi thời gian tính toán và chuẩn bị tăng thêm.
Ngoài thời gian request, tính liên tục của việc phát cũng cần được kiểm tra: một khi âm thanh tới nơi, trình phát phải phát liên tục. Trong một bộ thí nghiệm riêng dùng một callback thiết bị phát câm (muted output device), toàn bộ PCM cuối cùng đã được nhận đủ, nhưng callback phát không lấy được đủ mẫu âm thanh cho tổng cộng khoảng 0,36–1,44 giây. Thời gian hoàn thành request chỉ phản ánh thời điểm lô dữ liệu cuối cùng tới; trình phát, tuy nhiên, phải tiếp tục đọc âm thanh liên tục trước thời điểm đó. Tổng thời gian request và thời gian gián đoạn phát mô tả hai vấn đề khác nhau.
Việc sinh, tới nơi, đệm và đọc (bởi callback phát) của các khối âm thanh cùng nhau tạo thành dòng thời gian cho việc phát liên tục. Quan hệ truy hồi từ Mục 12.1 cho thời điểm bộ đệm lần đầu cạn: nếu khối kế tiếp chưa được sinh ở thời điểm đó, thời gian chờ nằm ở xử lý model; nếu nó đã được sinh nhưng chưa tới nơi, thời gian chờ nằm ở truyền tải; nếu nó đã tới nơi nhưng chưa được đọc, thời gian chờ nằm ở đệm cục bộ và lập lịch.
Tình huống này dẫn dắt toàn bộ quá trình từ ước tính đến quyết định triển khai: trước tiên tính thời gian hoàn thành lý tưởng, rồi tìm thời gian chờ trong bản ghi thực thi, dùng các thí nghiệm đơn nhân tố để giải thích nguyên nhân, và cuối cùng quyết định tiếp tục tinh chỉnh hay chuyển máy chủ dựa trên còn bao nhiêu thời gian có thể tiết kiệm. Mục 12.4 thêm tranh chấp truy nhập không dây, biến động và khôi phục vào phân tích; Mục 12.5 tập hợp một phương án triển khai hoàn chỉnh.
12.4 Tương tác và khôi phục dưới biến động không dây
12.4.1 Phổ chia sẻ và tranh chấp đường lên-đường xuống
Mục 12.3.4 phân biệt “gửi khi nào” với “chuyển cho ứng dụng khi nào”. Giao diện vô tuyến (air interface) là giao diện qua đó một thiết bị truyền thông bằng tín hiệu radio. Mạng không dây cũng thay đổi chi phí của bản thân việc gửi: dữ liệu đường lên và phản hồi đường xuống phải thay phiên chiếm cùng một khoảng thời gian giao diện vô tuyến. Mỗi lần trao đổi, ngoài việc gửi byte, còn phải chờ kênh rảnh, chờ khoảng trống liên khung (inter-frame gap), và nhận một xác nhận cho chặng (hop) đó. Vì vậy, ngoài số byte của ứng dụng, ta cũng cần đếm số lần trao đổi.
ACK đầu cuối-đầu cuối được gửi tới bên gửi từ xa; tầng điều khiển truy nhập môi trường (Media Access Control, MAC) tổ chức truyền trên một liên kết không dây đơn lẻ, và ACK MAC xác nhận khung không dây cho chặng đó. Khung không dây mang ACK đầu cuối-đầu cuối cũng phải trải qua ACK MAC của chính nó. Vậy ngay cả một ACK đầu cuối-đầu cuối rất ngắn cũng phải chờ kênh rảnh và hoàn thành xác nhận cấp chặng của riêng nó.
Ví dụ: Chi phí truy nhập không dây và xác nhận cho một khung ACK ngắn là bao nhiêu? Ghép kênh phân tần trực giao (orthogonal frequency-division multiplexing, OFDM) trải dữ liệu trên nhiều sóng mang con trực giao lẫn nhau; một PPDU (đơn vị dữ liệu giao thức tầng vật lý) chứa preamble tầng vật lý, header và dữ liệu mang theo, biểu diễn toàn bộ nội dung tầng vật lý của một lần truyền không dây; SIFS là khoảng trống ngắn giữa các khung (short inter-frame spacing) giữa các lần trao đổi liên tiếp. Lấy một lần trao đổi tham chiếu OFDM không tổng hợp với tốc độ dữ liệu 54 Mbit/s và tốc độ ACK MAC 6 Mbit/s. Lần trao đổi gói dữ liệu gồm thời gian chờ truy nhập 34 μs, khung dữ liệu 208 μs, SIFS 16 μs, và ACK MAC 44 μs, tổng cộng 302 μs. Khi mang một ACK đầu cuối-đầu cuối, khung dữ liệu thu nhỏ còn 40 μs trong khi ba thành phần kia giữ nguyên, tổng cộng 134 μs.
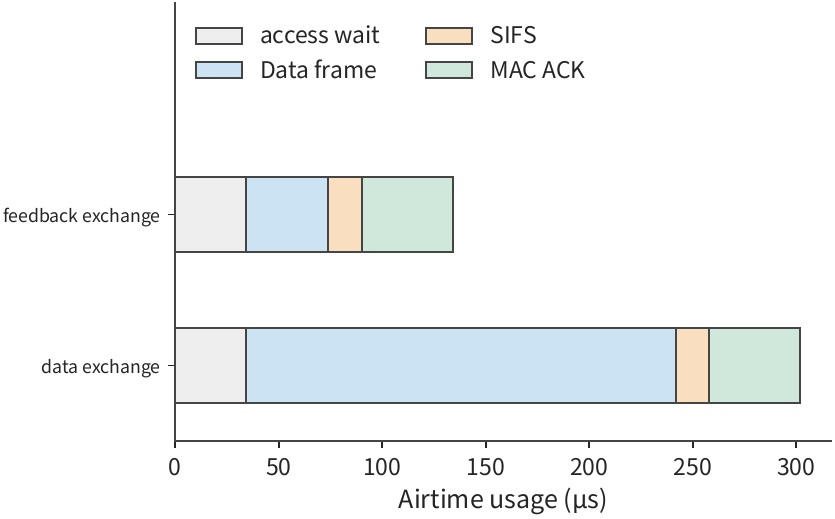
Trong Hình 12-24, cả hai lần trao đổi chia sẻ một chi phí cố định μs. Thời gian gửi của khung dữ liệu thu nhỏ từ 208 μs xuống 40 μs — giảm khoảng 80% — nhưng tổng thời gian trao đổi chỉ giảm khoảng 56%. Phần cố định càng lớn, lợi ích từ việc rút ngắn thêm payload càng nhỏ; gộp nhiều thông điệp nhỏ vào một lần gửi và giảm số lần trao đổi là cách trực tiếp hơn để cắt chi phí.
Vẫn gửi một ảnh 30 MB và một đoạn 5 MB, dưới cấu hình không dây này, cả các lần trao đổi dữ liệu lẫn các lần trao đổi phản hồi đều là 30.800 lần, và tổng thời gian chiếm giao diện vô tuyến khoảng
Giữ dấu vết dữ liệu và khôi phục không đổi, giảm một nửa số ACK đầu cuối-đầu cuối giải phóng khoảng giây thời gian giao diện vô tuyến. Như Mục 12.3.2 đã chỉ ra, tuy nhiên, tăng trễ phản hồi cũng làm tăng số lần dừng chờ cửa sổ. Vậy thời điểm gửi và xác nhận của mỗi gói phải được tính lại: giảm ACK giải phóng thời gian giao diện vô tuyến, nhưng chờ xác nhận lâu hơn cũng có thể trì hoãn các lần gửi tiếp theo. Hai hiệu ứng cùng nhau quyết định khi nào request hoàn chỉnh kết thúc.
Các giao thức thực tế đã bao gồm các cơ chế được thiết kế theo hướng này. TACK là một cơ chế phản hồi giảm chi phí xác nhận không dây. TACK tách việc xác nhận tích lũy thường lệ khỏi các sự kiện cần phản hồi tức thì: loại trước được gộp và gửi cùng nhau để giảm số lần trao đổi, còn loại sau được trả về ngay để bên gửi có thể tiếp tục hoặc truyền lại dữ liệu bị mất càng sớm càng tốt. Sự phân công lao động này đồng thời giảm chi phí gửi các thông điệp xác nhận và thời gian chờ phản hồi.
12.4.2 Hạn chót dịch vụ, dữ liệu lỗi thời và hủy bỏ
Trình phát trong Mục 12.1 chờ các khối bị thiếu để bảo toàn toàn bộ nội dung; một loại trình phát khác thay vào đó phát theo một đồng hồ cố định, và các khối âm thanh đến muộn chỉ đơn giản là không còn được dùng cho khe phát dự kiến ban đầu của chúng. Loại trước biến trễ mạng thành gián đoạn; loại sau làm một phần âm thanh bị thiếu. Yêu cầu chất lượng của tác vụ quyết định áp dụng quy tắc phát nào.
Ví dụ, giả sử tám khối âm thanh, mỗi khối 20 ms, được lên lịch phát liên tục bắt đầu từ giây 0,4, tổng cộng 0,16 giây. Khi các khối này chia sẻ một liên kết với một ảnh lớn, dưới FIFO tất cả các khối cuối cùng đều tới nơi nhưng mọi khối đều trễ thời điểm phát dự kiến; khi media được ưu tiên, cả tám khối tới đúng hạn. Trong cả hai trường hợp tổng số byte cuối cùng nhận được là như nhau, nhưng lượng âm thanh sẵn có đúng lúc lần lượt là 0 và 0,16 giây. Chỉ bằng cách tính các nội dung phát đúng lúc, việc lập lịch mới phản ánh được người dùng thực sự nghe được bao nhiêu âm thanh.
Dữ liệu đến muộn trễ khe phát dự kiến của nó, còn việc hủy bỏ khiến dữ liệu chưa phát trở nên vô giá trị ngay lập tức. Nếu hàng đợi chờ phát của trình phát đã chứa ba khối âm thanh 20 ms, ngay cả khi phía từ xa ngừng sinh ngay, việc phát cục bộ vẫn có thể tiếp tục thêm 60 ms. Nếu thông điệp điều khiển mất 100 ms để tới máy chủ, phía từ xa vẫn sẽ sinh các khối mới trước khi thông điệp tới nơi. Việc hủy bỏ vì thế tách thành hai đường song song (Hình 12-25): phía cục bộ xóa bộ đệm chờ phát của mình, còn phía từ xa chỉ ngừng sinh và gửi thêm âm thanh sau khi thông điệp điều khiển tới nơi. Cái trước quyết định khi nào người dùng ngừng nghe âm thanh; cái sau quyết định khi nào việc tiêu thụ tài nguyên thực sự dừng lại.
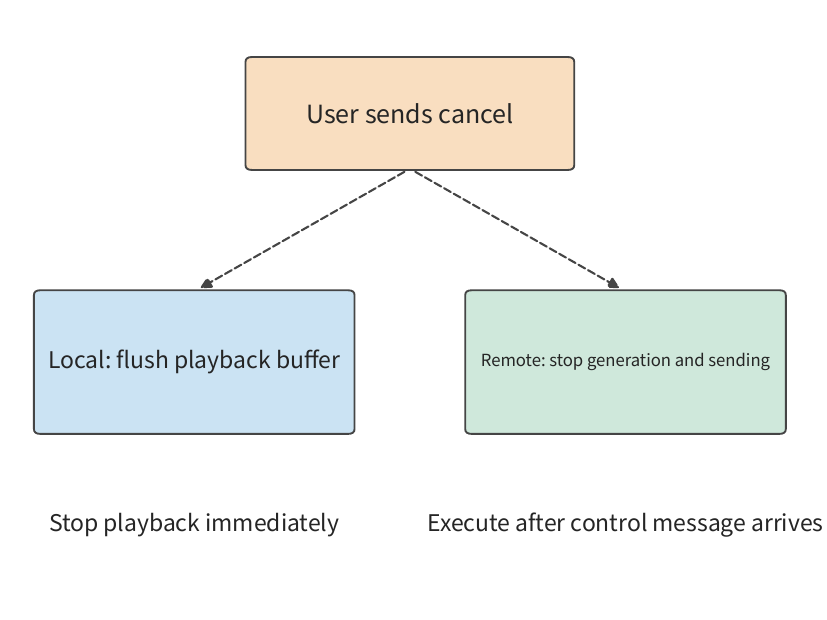
Sau khi âm thanh bị hủy, chỉ dữ liệu chưa phát bị loại bỏ; hành động của một agent chụp màn hình, ngược lại, làm thay đổi môi trường một khi được gửi đi. Khi một phản hồi bị mất, một lần thử lại nên truy vấn kết quả liên kết với mã thao tác gốc; nhấp lại sẽ biến một lần thử truyền thông thành một thao tác nghiệp vụ thứ hai. Lưu kết quả của thao tác cho phép việc thực thi tiếp tục từ nơi nó dừng khi mạng hồi phục, tránh các thao tác trùng lặp.
12.4.3 Chọn đường kép, chia lưu lượng và chuyển dự phòng
Phân tích phía trên chỉ xét một đường truy nhập đơn; các đầu cuối thường được kết nối với hai đường cùng lúc. Wi-Fi và mạng di động cung cấp hai đường truy nhập. Chia lưu lượng (traffic splitting) giao các phần dữ liệu khác nhau cho các đường khác nhau, nhắm đến việc dùng cả hai tài nguyên cùng lúc; nhân bản (replication) gửi cùng dữ liệu cho cả hai đường, nhắm đến việc có được một kết quả hợp lệ sớm hơn. Hai phương pháp này khác nhau về khối lượng dữ liệu và điều kiện hoàn thành và phải được tính riêng.
Ví dụ: Hai đường nên chia dữ liệu ảnh như thế nào để rút ngắn thời gian truyền? Hai đường độc lập với tốc độ không đổi chạy lần lượt ở 20 và 10 Mbit/s; một phần được giao cho đường nhanh và phần còn lại cho đường chậm. Hoàn thành đòi hỏi cả hai phần đều xong, nên
Nếu một đường hoàn thành trước, một số byte của nó có thể được chuyển sang từ đường kia, để phần mà lẽ ra hoàn thành muộn hơn hoàn thành sớm hơn. Vậy cách chia tối ưu làm cho cả hai đường hoàn thành cùng lúc, tức . Gửi 20 MB trên đường nhanh và 10 MB trên đường chậm mỗi đường mất 8 giây — nhanh hơn 4 giây so với 12 giây cần nếu chỉ dùng đường nhanh (Hình 12-26).
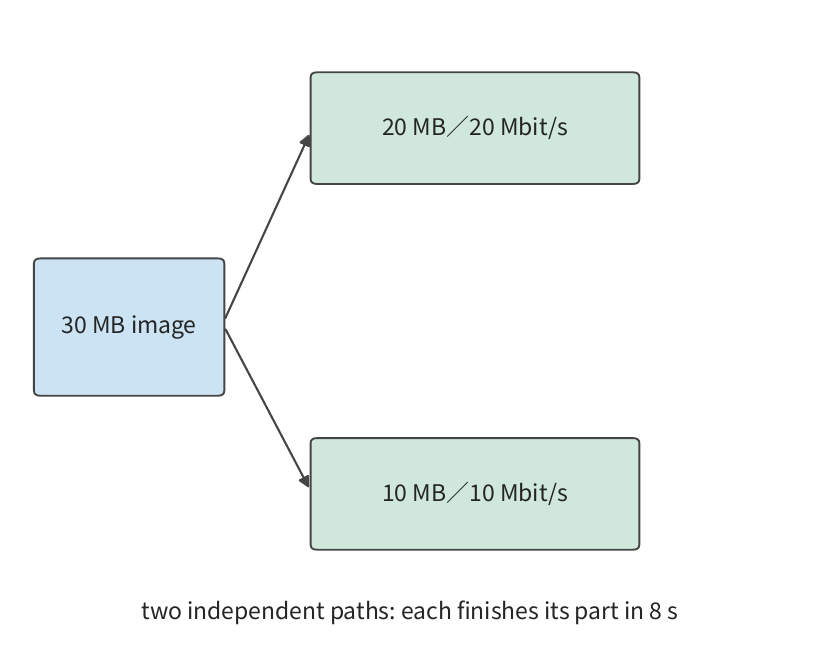
Nếu hai đường gộp vào một lối ra chia sẻ 24 Mbit/s, cả hai đường truy nhập vẫn có thể gửi đồng thời và mỗi đường vẫn mất 8 giây, nhưng toàn bộ dữ liệu phải đi qua lối ra đó, và truyền 30 MB qua nó mất ít nhất 10 giây. Nút thắt vì thế chuyển sang lối ra chia sẻ. Tăng thêm tốc độ truy nhập chỉ làm nhiều dữ liệu hơn xếp hàng chờ đi qua lối ra đó.
Trong Hình 12-27, hai đường lại hội tụ tại lối ra. Điểm hội tụ này vừa giải thích vì sao tốc độ của hai đường truy nhập không thể đơn giản cộng lại với nhau, vừa đặt ra một câu hỏi khác: nếu thiết bị chủ lối ra hỏng, đường truy nhập kia có thể tự mình tiếp tục truyền không?
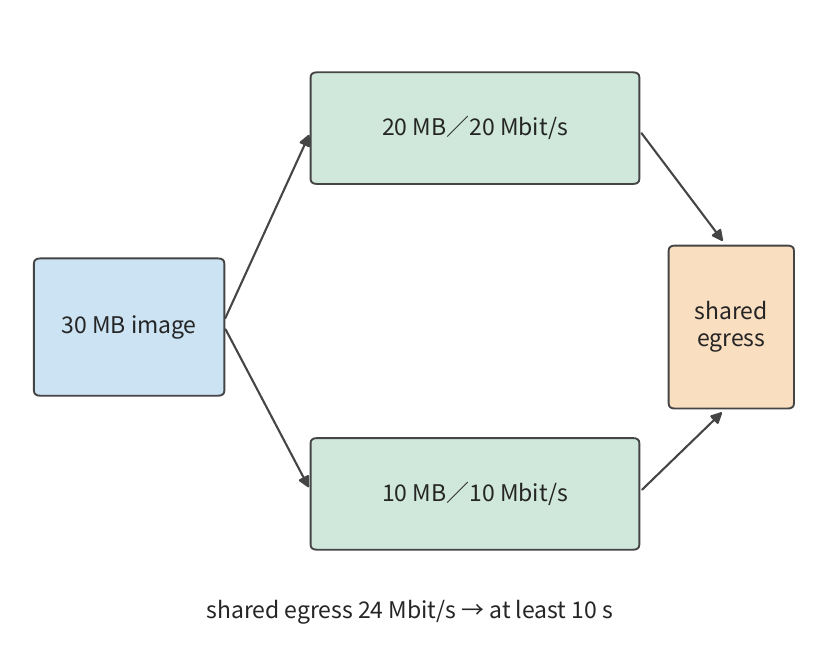
Nếu muốn cùng dữ liệu vẫn tới nơi sau khi một đường ngắt kết nối, có thể dùng nhân bản, và ta nên kiểm tra hai bản sao sẽ có khả năng hỏng cùng nhau ở đâu. Gọi là xác suất điểm cuối chia sẻ hỏng; khi điểm cuối hoạt động bình thường, hai đường truy nhập hỏng độc lập với xác suất . Hỏng hóc gồm điểm cuối hỏng, hoặc điểm cuối hoạt động bình thường nhưng cả hai đường truy nhập đều hỏng — hai sự kiện loại trừ lẫn nhau có xác suất cộng lại cho
Lấy , xác suất cả hai đường truy nhập cùng hỏng là 0,5%; cộng đưa tổng thể lên khoảng 2,5%. Trong đó, 2 điểm phần trăm đến trực tiếp từ điểm cuối chia sẻ. Ngay cả khi làm cả hai đường truy nhập hoàn toàn đáng tin cậy từng cái một, xác suất hỏng tổng thể vẫn là 2%; chỉ đặt các bản sao dịch vụ trong các vùng sự cố khác nhau mới giảm được số hạng này.
Một khi sự cố chia sẻ được tránh, nhân bản vẫn tốn thêm băng thông. Lấy tám khối âm thanh 640 byte làm ví dụ: một bản sao là 5.120 byte, và nhân đôi hoàn toàn là 10.240 byte. Bên nhận loại trùng lặp theo ID khối, và bản sao hoàn chỉnh đầu tiên tới nơi được đưa cho trình phát, còn bản sao sau bị loại bỏ. Gửi thêm một bản sao dữ liệu cho phép dùng kết quả của đường nào tới trước; nhưng nếu hai đường chia sẻ cùng một lối ra, dữ liệu trùng lặp cũng tiêu thụ băng thông mà các tác vụ khác cần.
Chia lưu lượng, nhân bản và các điểm hội tụ thường được triển khai trong các hệ thống thực tế bởi một giao thức hoặc một proxy truy nhập. Multipath TCP (MPTCP) tổ chức các luồng con TCP đi qua các đường khác nhau trong một kết nối logic đơn lẻ, và một proxy truy nhập có thể hội tụ các đường này giữa đầu cuối và một máy chủ thông thường. Thực hành hợp tác đa mạng (multi-network collaboration) của Huawei Link Turbo cũng dùng trạng thái của các mạng truy nhập khác nhau để chọn cách gửi. Vị trí của proxy đồng thời ảnh hưởng đến dung lượng chia sẻ, truyền lan và vùng sự cố, biến nó thành một nút tính toán-và-vận chuyển trong mô hình triển khai.
12.5 Từ phân công biên-đám mây đến triển khai hoàn chỉnh
12.5.1 Vùng, dữ liệu và vị trí dịch vụ
Tiếp tục phân tích tác vụ chụp màn hình 30 vòng từ Mục 12.1. Mười vòng đầu đã hoàn thành, và ta phải chọn một vị trí thực thi cho hai mươi vòng còn lại; từ thời điểm này, tác vụ phải hoàn thành trong vòng 45 giây. Dù chọn phương án nào, thời gian đã bỏ ra đều như nhau, nên thứ được so sánh là phần việc còn lại. Dịch vụ gốc mất 3,5 giây mỗi vòng, nên tiếp tục với nó sẽ cần 70 giây — cần thay đổi phương án thực thi.
Vẫn dùng 0,8 MB ảnh chụp màn hình mỗi vòng, 0,3 giây công việc đầu cuối, và đường lên 6,4 Mbit/s cùng RTT 0,2 giây của đường đám mây gốc, so sánh ba vị trí thực thi: biên là chiếc điện thoại trong Mục 12.1.5, trạm làm việc gần đó giữ một thẻ RTX PRO 6000 Blackwell Workstation Edition, và vùng đám mây dùng H100 SXM. Cả ba đều chạy cùng trọng số Qwen3-8B q4_0 và ngữ cảnh 8K, và mỗi vòng sinh cùng 45 token như trong Mục 12.1.5, nên chất lượng tác vụ giống hệt nhau ở cả ba. Thời gian model mỗi vòng tuân theo quy ước của Mục 12.1.5, lấy cận dưới đọc decode: 45 bước, mỗi bước đọc 5,47 GB, chia cho băng thông bộ nhớ của thiết bị. Khi dịch vụ mới tiếp quản, nó trước tiên phải chạy một prefill trên ngữ cảnh 8K còn lại từ mười vòng trước — “chuẩn bị một lần” trong bảng — tính là 133,6 TFLOPs phép toán ma trận chia cho đỉnh BF16 dense; điện thoại không có đỉnh ma trận trích dẫn được, nên phần chuẩn bị của nó được ghi là 0, một lựa chọn chỉ làm cho biên trông nhanh hơn thực tế. Trước tiên giả định các điều kiện không xếp hàng, không sự cố, và thời gian gửi phản hồi điều khiển bằng 0.
| Vị trí thực thi | Thiết bị | Chuẩn bị một lần | Model mỗi vòng | Đường lên | Truyền lan khứ hồi mỗi vòng | Nơi nhận ảnh chụp | Năng lượng 20 vòng |
|---|---|---|---|---|---|---|---|
| Biên | Điện thoại, 84,8 GB/s | 0 s | 2,90 s | Không cần tải lên | 0 s | Nằm lại trên thiết bị | 518–680 J |
| Trạm làm việc gần đó | RTX PRO 6000, 1.792 GB/s, 600 W | 0,27 s | 0,137 s | 80 Mbit/s | 0,02 s | Gửi tới trạm làm việc gần đó | ~1,81 kJ |
| Vùng đám mây | H100 SXM, 3.350 GB/s, 700 W | 0,14 s | 0,073 s | 6,4 Mbit/s | 0,20 s | Gửi tới vùng đám mây | ~1,12 kJ |
Chi phí được đo bằng năng lượng. Với hai GPU, năng lượng được tính là công suất định mức của bo mạch nhân thời gian bận, trong đó thời gian bận là chuẩn bị một lần cộng hai mươi vòng tính toán model; công suất định mức là một cận trên, nên hai hàng này cũng là các cận trên. Với điện thoại, ta dùng con số đo được của MELTing Point là 0,576–0,756 J mỗi token, cho tổng 900 token qua hai mươi vòng. Năng lượng mạng do tải lên và truyền lan tiêu thụ không được tính.
Trước khi so sánh thời gian và chi phí, ràng buộc về nơi cư trú dữ liệu (data residency) trước tiên phải được thỏa mãn — nghĩa là, dữ liệu chỉ có thể được lưu trữ và xử lý trên các thiết bị được chỉ định hoặc trong các vùng được chỉ định. Trong bảng, các ảnh chụp RAW của hàng biên không bao giờ rời khỏi thiết bị; các hàng trạm làm việc gần đó và vùng đám mây mỗi vòng phải truyền 0,8 MB ảnh chụp RAW ra khỏi thiết bị. Nếu các ảnh chụp chứa nội dung không được phép rời khỏi thiết bị hoặc không được vượt biên giới, hai hàng này bị loại trước khi so sánh bắt đầu; so sánh thời gian và chi phí bên dưới giả định việc tải lên được phép.
Tiếp tục chia nhỏ đám mây thành các vùng khác nhau vẫn đòi hỏi so sánh cùng các thời gian và chi phí này. Dưới dịch vụ Regionless (nơi nền tảng chọn vùng đám mây cho một request, thay vì ứng dụng gắn với một vùng cố định), ứng dụng chỉ định tác vụ, yêu cầu chất lượng và hạn chót hoàn thành, và nền tảng chọn vùng triển khai. Nền tảng vẫn phải so sánh chi phí thực tế của mỗi phương án: khoảng cách máy chủ ảnh hưởng đến thời gian truyền lan, bộ nhớ đệm ảnh hưởng đến lượng tái tính toán cần thiết, và truyền xuyên vùng ảnh hưởng đến chi phí truyền dữ liệu.
12.5.2 So sánh kết hợp hạn chót, chi phí và khôi phục
Ví dụ: Di trú trạng thái và số vòng tương tác còn lại thay đổi lựa chọn triển khai biên-đám mây như thế nào? Thời gian cho hai mươi vòng còn lại là
Băng thông bộ nhớ của H100 gấp 1,87 lần RTX PRO 6000, nên tính toán model mỗi vòng của đám mây ít hơn khoảng 0,064 giây so với trạm làm việc gần đó; qua hai mươi vòng tiết kiệm được khoảng 1,3 giây, cộng thêm 0,13 giây ở phần chuẩn bị. Nhưng mỗi vòng tải lên tốn thêm 0,92 giây và truyền lan thêm 0,18 giây, cộng dồn thành 22 giây chờ tăng thêm qua hai mươi vòng. Cân bằng lại, đường đám mây thực ra chậm hơn khoảng 20,6 giây. Tách chênh lệch thời gian ra cho thấy một model nhanh hơn có thể đánh mất lợi thế vào truyền thông mỗi vòng như thế nào: decode mỗi vòng chỉ mất từ vài chục đến hơn một trăm mili giây, ít hơn nhiều so với thời gian truyền thông mỗi vòng.
Các Hình 12-28 đến 12-30 tóm tắt phân rã thời gian theo giai đoạn của tác vụ hoàn chỉnh dưới ba chế độ triển khai. Đoạn tính toán màu xanh lá của đám mây ngắn hơn, nhưng đoạn tải lên màu xanh dương của nó dài hơn; các đoạn tích lũy tuần tự, và tổng của chúng quyết định thời gian hoàn thành tác vụ hiển thị ở cuối mỗi thanh.
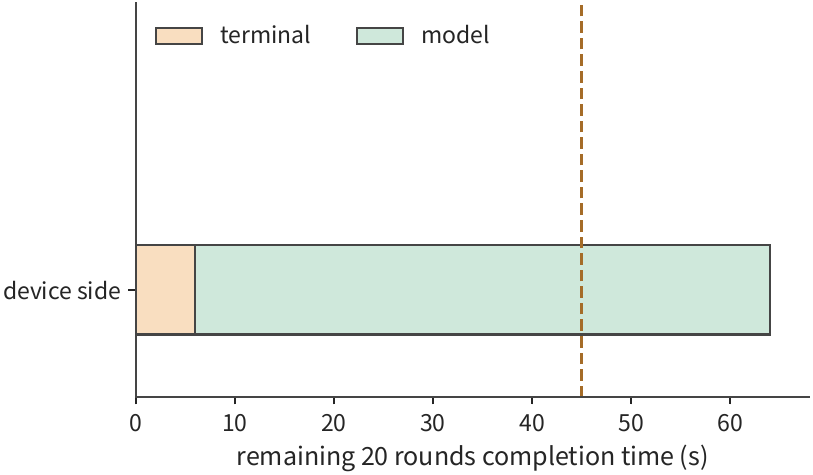
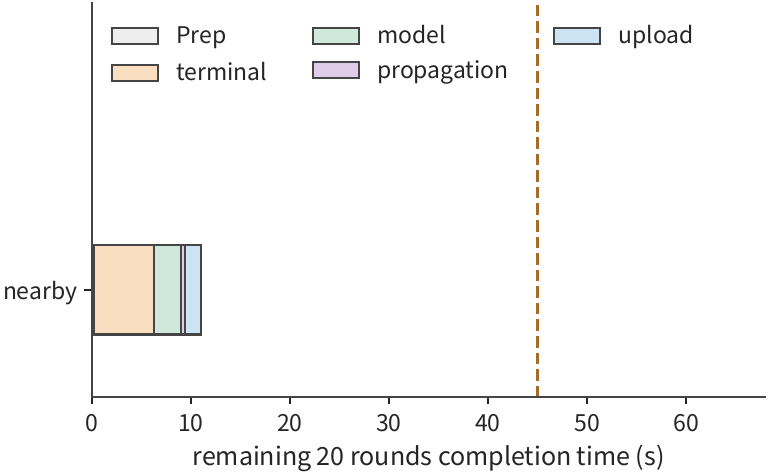
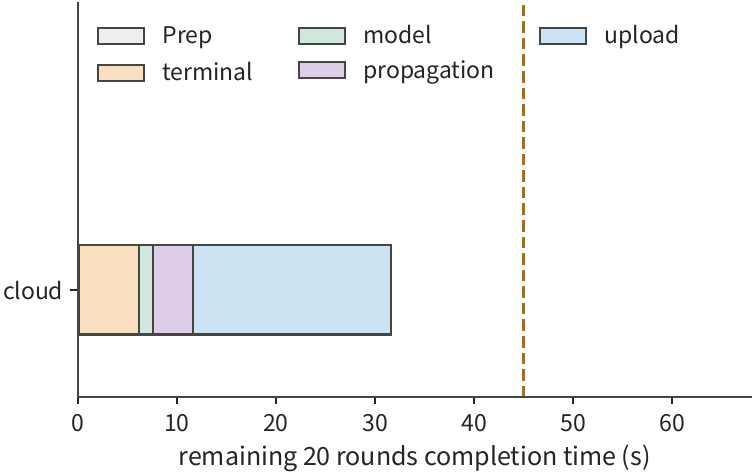
Hạn chót 45 giây trước tiên loại thiết bị local: nó có mức tiêu thụ năng lượng thấp nhất, nhưng cần 64,0 giây. Cả trạm làm việc gần đó lẫn đám mây đều hoàn thành đúng hạn, nên ta so sánh tiếp mức tiêu thụ năng lượng: đám mây dùng khoảng 1,12 kJ, trạm làm việc gần đó khoảng 1,81 kJ. Công suất định mức của H100 cao hơn RTX PRO 6000, nhưng thời gian bận mỗi vòng của nó chỉ hơn một nửa, nên mức tiêu thụ năng lượng của nó thực ra thấp hơn. Trong số các phương án hoàn thành đúng hạn, phương án đám mây vì thế có mức tiêu thụ năng lượng thấp nhất.
Hàng thiết bị local vẫn cần được kiểm tra với dung lượng pin, theo Mục 12.1.5. Con số 518–680 J cho hai mươi vòng trong bảng cần được quy đổi thành một phần của một lần sạc. Trang thông số của iPhone 16 Pro chỉ đưa ra thời gian phát video tối đa 27 giờ, không có con số watt-giờ pin, nên ta thay vào đó dùng phép đo của MELTing Point để quy đổi: một lần sạc có thể hoàn thành khoảng 490–590 prompt, và 20 vòng tương ứng với 20 prompt, tức khoảng 3,4%–4,1% của một lần sạc. Dung lượng pin không loại phương án thiết bị local; thứ loại nó là thời gian hoàn thành 64,0 giây.
Sự phụ thuộc của phương án đám mây vào tốc độ đường lên có thể được biểu diễn định lượng. Chỉ thay đổi tốc độ đường lên của đường đám mây, tính bằng Mbit/s, trong khi giữ các tham số khác cố định, thời gian hoàn thành của đám mây là
Con số 11,6 giây đến từ một bước chuẩn bị cộng hai mươi vòng công việc không tải lên; 128 Mbit là tổng khối lượng tải lên cho hai mươi ảnh chụp. Đáp ứng hạn chót đòi hỏi Mbit/s (Hình 12-31). Nhưng nó không bao giờ đánh bại được trạm làm việc gần đó: ngay cả với tải lên tức thì, đám mây vẫn cần 11,6 giây, vẫn chậm hơn 11,0 giây của trạm làm việc gần đó. Lý do là truyền lan khứ hồi 0,2 giây mỗi vòng: nó vượt tổng truyền lan và tải lên mỗi vòng của trạm làm việc gần đó (0,1 giây) 0,1 giây, nhiều hơn khoảng 0,064 giây mà H100 tiết kiệm được mỗi vòng về thời gian model.
Kết luận “không thể đuổi kịp” này phụ thuộc vào cách định nghĩa cận dưới đọc. Thí nghiệm 8-1 đo được 25,83 ms mỗi bước cho decode 8K batch 1 trên RTX PRO 6000, khoảng 2,83 lần cận dưới đọc 9,12 ms, với thời gian tăng thêm chủ yếu đến từ chi phí cố định mỗi bước. Nhân thời gian model của cả hai GPU với cùng hệ số này cho 16,04 giây cho trạm làm việc gần đó và 14,29 giây cho đám mây không kể tải lên, chênh lệch 1,75 giây; đám mây chỉ nhanh hơn khi tốc độ đường lên vượt Mbit/s.
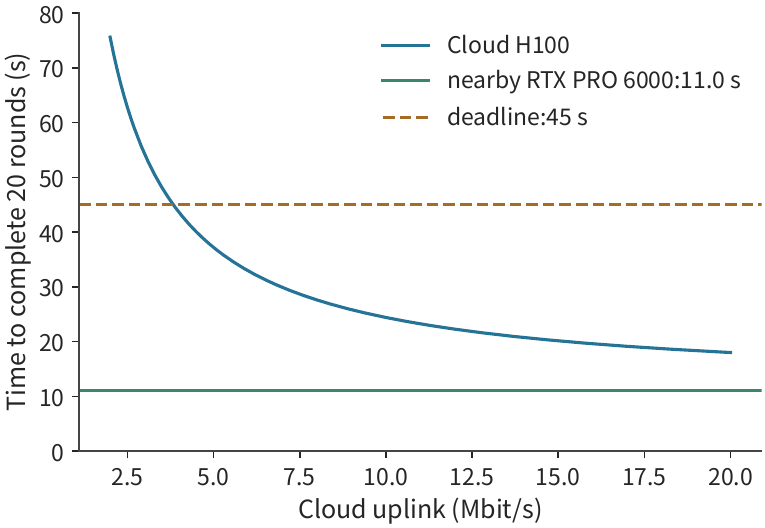
Gần hạn chót, ta cũng cần tính xem còn bao nhiêu dư địa cho chi phí tăng thêm. Ở tốc độ đường lên gốc 6,4 Mbit/s, tác vụ đám mây hoàn thành sớm hơn hạn chót khoảng 13,4 giây; nếu đường lên tụt xuống 4 Mbit/s, thời gian trở thành khoảng 43,6 giây, chỉ chừa lại khoảng 1,4 giây dư địa; ở 3,5 Mbit/s, nó trở thành khoảng 48,2 giây, đã vượt hạn chót. Nếu 99% tác vụ phải hoàn thành đúng hạn, ta cần phân tích phân phối xác suất của thời gian hoàn thành tác vụ. Vì tốc độ mỗi vòng có thể biến động, tổng thời gian gồm tải lên nên được viết là
Giả định tốc độ của mỗi vòng không đổi trong suốt lần tải lên của nó, một tốc độ trung bình 8 Mbit/s đạt được bằng mười vòng ở 6 Mbit/s và mười vòng ở 10 Mbit/s vẫn cho thời gian tác vụ khoảng 28,7 giây, chậm hơn 27,6 giây đạt được với 8 Mbit/s không đổi suốt quá trình. Thời gian gửi tỷ lệ nghịch với tốc độ, nên thời gian chờ tăng thêm do các vòng chậm vượt qua thời gian chờ tiết kiệm được nhờ các vòng nhanh. Nền tảng nên đánh giá liệu có được thỏa hay không dựa trên phân phối của thời gian tải lên trên toàn tác vụ, và cũng nên tính đến việc khi mạng chậm kéo dài một đoạn, nhiều vòng lân cận bị ảnh hưởng cùng nhau.
Lựa chọn triển khai ở trên bị chi phối bởi thời gian tải lên ảnh chụp. Với một tác vụ dựa trên văn bản có đầu vào nhỏ hơn và nhiều prefix lặp lại, trọng tâm tối ưu hóa chuyển sang tái sử dụng tính toán. Giữ lại trạng thái phiên giảm phần tính toán lặp lại này. Xét một phiên agent dựa trên văn bản: gửi lại prefix mỗi vòng tổng cộng khoảng 66 KB, trong khi giữ trạng thái giảm xuống còn khoảng 10 KB gửi, với mỗi phản hồi khoảng 2,5 KB. Ở 333 Mbit/s, gửi ít hơn khoảng 56 KB chỉ tiết kiệm 1,3 ms. So với tải lên ảnh chụp 16 MB, lợi ích chính ở đây đến từ việc tránh tính toán prefix lặp lại.
Phép toán ma trận cho cùng phiên giảm từ khoảng xuống FLOPs. Ở 989,4 TFLOP/s trên một H100 SXM trong đám mây, giữ trạng thái tiết kiệm khoảng 0,239 GPU-giây. Khoảng 465 MB trạng thái được lưu chiếm bộ nhớ GPU liên tục; quy đổi theo phần chia của nó trong 80 GB bộ nhớ của H100, mỗi giây lưu trữ tương đương việc chiếm GPU-giây. Chia hai cái: sau khoảng 41 giây giữ trạng thái đã lưu, bộ nhớ nó chiếm bù đắp toàn bộ phần tính toán tiết kiệm được lần này. Phép tính hòa vốn này giống hệt so sánh thời gian di trú trong Mục 12.2.3: lợi ích của việc tái sử dụng phải bù đắp chi phí lưu hoặc di chuyển trạng thái.
Lưu trạng thái không chỉ giảm tính toán lặp lại trong quá trình thực thi bình thường mà còn giảm công việc làm lại sau một sự cố. Lấy phương án đám mây đã chọn làm ví dụ, ta so sánh chi phí của cùng một sự kiện ngắt kết nối dưới hai cách tiếp cận lưu tiến độ khác nhau. Hoàn thành một vòng trên đám mây mất khoảng 1,57 giây. Giả sử vòng thứ mười đã thực thi xong nhưng xác nhận của nó chưa trở về thì kết nối ngắt, và kết nối lại mất 1 giây. Nếu tiến độ của chín vòng đầu đã được cam kết (commit), chỉ vòng thứ mười chưa được xác nhận cần làm lại, thêm khoảng 2,57 giây, nên tác vụ tăng từ 31,6 lên 34,2 giây; nếu cả mười vòng phải làm lại, nó thêm khoảng 16,7 giây, làm tác vụ thành 48,3 giây, vượt hạn chót. Dùng cùng một máy chủ suốt quá trình, liệu tiến độ có giữ được hay không quyết định tác vụ có hoàn thành đúng hạn hay không. Trạm làm việc gần đó chỉ cần khoảng 0,54 giây mỗi vòng, nên ngay cả mất tiến độ mười vòng cũng chỉ tốn 17,4 giây; một phương án có nhiều dư địa hạn chót hơn sẽ dung thứ sự cố tốt hơn.
Các Hình 12-32 và 12-33 đánh dấu sự khác biệt giữa hai cách tiếp cận khôi phục: sau cùng một sự kiện ngắt kết nối, một cách chỉ làm lại vòng cuối, cách kia làm lại mười vòng trước đó. Chi phí khôi phục lớn đến mức nào trước hết phụ thuộc vào những kết quả nào đã được lưu đáng tin cậy.
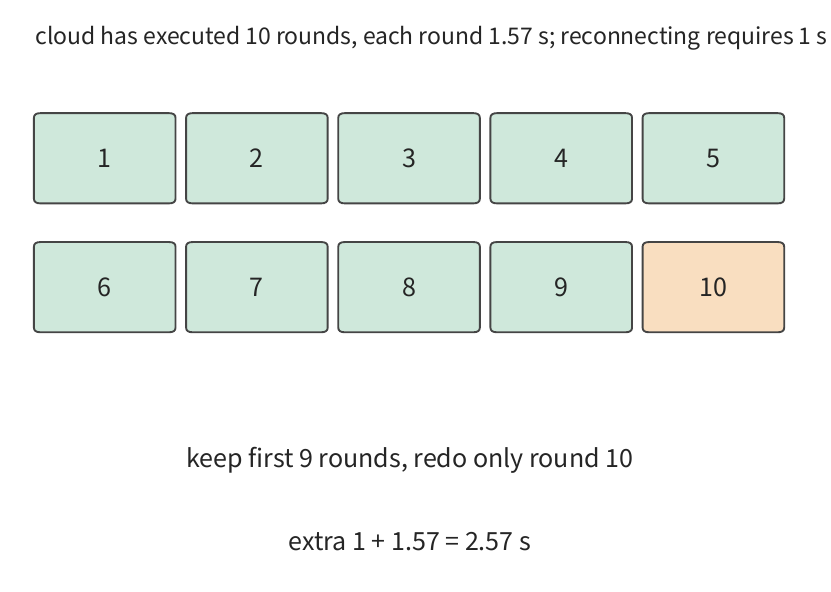
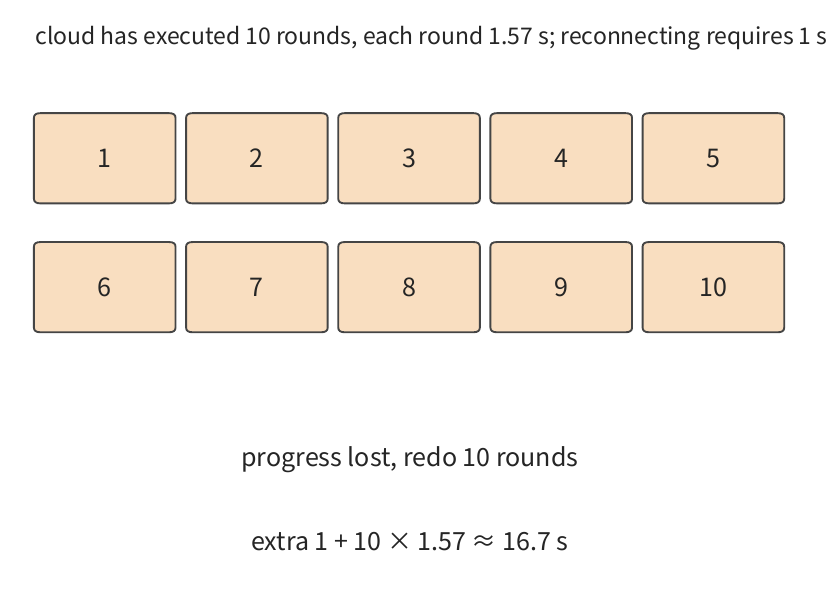
So sánh ở trên liên quan đến một sự kiện ngắt kết nối đơn lẻ đã xảy ra. Để ước tính chi phí trung bình qua nhiều tác vụ, ta cũng phải tính đến xác suất sự cố xảy ra: việc thử lại cũng thêm chi phí. Nếu mỗi lần thử độc lập với xác suất thành công , và một sự cố kích hoạt một lần thử lại toàn bộ tốn mỗi lần, chi phí kỳ vọng thỏa , nên . Tỷ lệ thành công 99% tương ứng khoảng , và 80% tương ứng . Lưu tiến độ có thể biến một lần thử lại toàn bộ thành một lần làm lại cục bộ, trực tiếp giảm thời gian và chi phí do mỗi sự cố thêm vào.
12.5.3 Khi một phương án triển khai cần thay đổi
Kết hợp các so sánh thời gian, năng lượng và khôi phục từ Mục 12.5.2, ví dụ này nên chuyển hai mươi vòng còn lại lên đám mây: 31,6 giây để hoàn thành, ở mức năng lượng khoảng 1,12 kJ. So với 70 giây nếu tiếp tục dùng dịch vụ gốc, cách này tiết kiệm khoảng 38,4 giây. Đầu cuối tiếp tục thu nhận và thực thi các thao tác, H100 trong đám mây đảm nhiệm phán đoán model, và mỗi vòng chỉ truyền ảnh chụp và kết quả điều khiển.
Quyết định này đến từ một so sánh từng mục của ba phương án triển khai: thiết bị local bị loại trước vì vượt hạn chót, còn cả trạm làm việc gần đó lẫn đám mây đều hoàn thành đúng hạn, với đám mây tiêu thụ ít năng lượng hơn. Các phân tích nén, đặc trưng và trạng thái của các Mục 12.1–12.2 chỉ ra các cải tiến tiếp theo: nén ảnh chụp có thể giảm thời gian tải lên, tải lên toàn bộ đặc trưng làm tăng thời gian truyền, và giữ lại tiến độ đã cam kết giảm công việc lặp lại sau khôi phục.
| Thay đổi điều kiện | Kết quả | Quyết định |
|---|---|---|
| Tốc độ đường lên của đường đám mây gốc là 6,4 Mbit/s | Đám mây: 31,6 s, khoảng 1,12 kJ; gần đó: 11,0 s, khoảng 1,81 kJ | Cả hai hoàn thành đúng hạn; dùng đám mây, phương án có mức tiêu thụ năng lượng thấp hơn |
| Tốc độ đường lên của đường đám mây tụt xuống 3,5 Mbit/s | Đám mây: khoảng 48,2 s | Đám mây vượt hạn chót; chuyển sang trạm làm việc gần đó |
| Tốc độ đường lên của đường đám mây ở bất kỳ mức nào | Đám mây không bao giờ dưới 11,6 s | Luôn chậm hơn trạm làm việc gần đó; các hạn chót chặt hơn chỉ có thể được đáp ứng bởi trạm làm việc gần đó |
| Một lần ngắt kết nối trên đám mây, giữ tiến độ đến vòng chín và làm lại vòng mười | 34,2 s | Vẫn trong hạn chót |
| Cùng lần ngắt kết nối nhưng mất mười vòng tiến độ | 48,3 s | Vượt hạn chót; cần lưu tiến độ tốt hơn, hoặc nên chuyển sang trạm làm việc gần đó |
Việc chuyển thiết bị giữa chừng tác vụ cũng đòi hỏi di trú trạng thái phiên. Phiên 64 MiB trong Mục 12.2 cần khoảng 7,7 giây chuẩn bị, và mỗi vòng sau đó nhanh hơn 0,4 giây; qua 20 vòng, điều này chỉ lãi ròng khoảng 0,3 giây. Nếu một cải thiện băng thông chỉ kéo dài mười vòng rồi quay lại như cũ, lần di trú này sẽ lỗ ròng khoảng 3,7 giây. Nền tảng vì thế nên cân nhắc cùng lúc lợi ích duy trì kỳ vọng và chi phí chuyển đổi: trạng thái chỉ nên được di trú khi thời gian tiết kiệm kỳ vọng đủ bù đắp phần chuẩn bị di trú còn chừa dư cho chi phí tăng thêm. Ở yên trên cùng một thiết bị một thời gian tránh phải di trú trạng thái lặp đi lặp lại gần một ngưỡng băng thông then chốt.
Chương 1 đã dùng dung lượng, sức tính toán và thời gian đọc để đánh giá liệu một accelerator có thể giữ một model hay không; chương này phân tích thêm truyền thông, thứ tự thực thi và quá trình khôi phục để đánh giá liệu một phương án triển khai có thể hoàn thành một tác vụ đúng hạn hay không. Chọn một phương án triển khai đòi hỏi phải trả lời theo thứ tự: tác vụ gồm những công việc gì, bước nào phải chờ, việc thực thi thực tế thêm chi phí gì, và phương án nào phù hợp hơn khi điều kiện thay đổi.
12.5.4 Điều chỉnh hệ thống sau khi điều kiện tài nguyên thay đổi
Các so sánh triển khai ở trên giữ model cố định và chỉ thay đổi vị trí thực thi; ngược lại, giữ luồng công việc tác vụ cố định và chỉ tăng tốc model cũng mang lại lợi ích hữu hạn cho tác vụ hoàn chỉnh. Giả sử trong một quỹ đạo cố định, thực thi model tổng cộng 8 giây, và công việc công cụ cùng mạng không thể chồng lấn tổng cộng 2 giây. Ngay cả tăng tốc model gấp mười lần tổng thể, tác vụ chỉ có thể giảm từ 10 giây xuống 2,8 giây, tăng tốc khoảng 3,57 lần; khi thời gian model tiến tới 0, cận dưới vẫn là 2 giây (Hình 12-34).
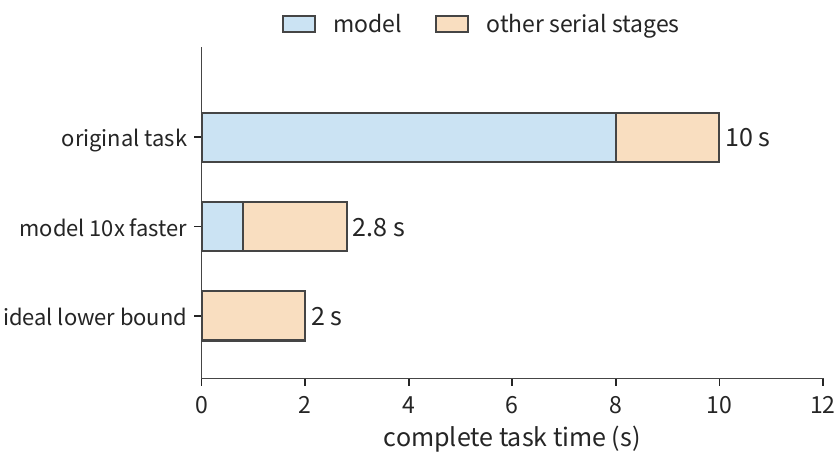
Để rút ngắn thêm hai giây còn lại đòi hỏi thay đổi tổ chức hệ thống. Chuyển thực thi xuống cục bộ có thể giảm các vòng khứ hồi mạng; giữ lại môi trường có thể giảm thời gian chờ tạo lập. Nhưng các thiết bị cục bộ và không gian cư trú cần cho việc này đi vào một ngân sách chi phí mới. Ví dụ triển khai trong Mục 12.5.2 đã cho phương pháp so sánh: trước tiên tìm các phương án đáp ứng yêu cầu chất lượng và hạn chót, rồi so sánh tổng chi phí của mỗi phương án hoàn thành tác vụ.
Ý tưởng tương tự cũng xuất hiện trong thiết kế model: sự thay đổi từ DeepSeek V4 sang V4.1 là một điều chỉnh tương tự ở phía model. Chia sẻ chéo tầng (cross-layer sharing) giảm lưu trữ dư thừa của KV toàn cục, cho phép model lưu lịch sử ở mức chi tiết hơn; CED giảm công việc đi qua decoder lặp lại trong giai đoạn đầu vào, và khôi phục cache rút ngắn đường khởi động lại một phiên nhiều lượt. Các thay đổi này lần lượt tác động lên dung lượng, tính toán đầu vào và thời gian chờ khôi phục, và có thể được đưa vào ngân sách của cùng một tác vụ từng mục một.
Từ lưu trữ trên chip đến triển khai biên-đám mây, các lựa chọn thiết kế luôn phụ thuộc vào việc hiểu toàn bộ quá trình thực thi. Cấu trúc reduction của attention cho phép các ma trận trung gian được xử lý theo khối; cấu trúc model lặp lại cho phép các kế hoạch thực thi được tái sử dụng; quan hệ prefix và nhánh cho phép ngữ cảnh được chia sẻ; và thời gian chờ công cụ cung cấp một cửa sổ cho việc hoán đổi trạng thái và chuẩn bị môi trường. Mỗi cải tiến dùng thông tin về model hoặc tác vụ để dẫn dắt thiết kế ở các mức khác, sắp xếp lại nơi dữ liệu được lưu, tính toán được phân chia, và việc bàn giao diễn ra như thế nào.
Bài tập chương
Các bài tập tiến từ tính toán, sang điều kiện thay đổi, đến giải thích cơ chế. 12-2, 12-3 và 12-7 là các bài tập cốt lõi. Trừ khi có ghi chú khác, các giá trị tuân theo các điều kiện giảng dạy trong văn bản chính.
12-1 Ngân sách truyền tải và tính toán cho tác vụ nâng cao chất lượng ảnh [mở rộng, ★].
(a) Với tốc độ đường lên 10, 20 và 100 Mbit/s, hãy tính thời gian hoàn thành theo ba phương án: phương án gốc, tăng tốc độ xử lý ảnh lên gấp mười lần ban đầu, và giảm một nửa kích thước đầu vào. Nén đầu vào vẫn cộng thêm 0,15 giây thời gian codec.
(b) Tìm tốc độ đường lên mà tại đó thời gian truyền tiết kiệm được nhờ nén đúng bằng thời gian codec tăng thêm. Sau đó, giữ nguyên kích thước ảnh gốc và tốc độ đường lên 20 Mbit/s: nếu chỉ 0,2 giây trong 0,3 giây thời gian xử lý ban đầu có thể được tăng tốc, và phần này được tăng tốc độ thực thi gấp mười lần, thì tổng thời gian tác vụ là bao nhiêu?
(c) Chia ảnh thành ba khối có thể xử lý độc lập và vẽ sơ đồ sự chồng lấn của tải lên, xử lý và truyền trả về. Đánh dấu bước giới hạn mọi khả năng giảm tiếp thời gian tác vụ.
12-2 Việc nén ảnh chụp màn hình tiết kiệm được thời gian truyền có bù được tương tác phát sinh thêm mà nó gây ra không [cốt lõi, ★].
(a) Nén ảnh chụp màn hình mỗi lượt từ 0,8 MB xuống 0,2 MB, cộng thêm 30 ms thời gian mã hóa mỗi lượt. Hãy tính lại tổng thời gian tiết kiệm được trong một tác vụ chụp màn hình 30 lượt.
(b) Tác vụ còn nhanh hơn không nếu việc nén cần 38 lượt? Tìm số lượt tối đa mà phương án nén vẫn nhanh hơn phương án ảnh gốc 30 lượt.
(c) Tăng RTT mỗi lượt thêm 100 ms, và tính riêng tổng thời gian cho phương án ảnh gốc 30 lượt và phương án ảnh nén 38 lượt. Giải thích vì sao cùng một thay đổi RTT lại tạo ra mức tăng thời gian tác vụ khác nhau.
(d) Thiết kế các trường bản ghi cho phiên bản ảnh chụp màn hình và số thao tác, giải thích cách phân biệt các lượt hiệu chỉnh do nén gây ra với các lượt lãng phí do trạng thái lỗi thời.
12-3 Vị trí mã hóa hình ảnh và việc di trú trạng thái ảnh hưởng đến thời gian tương tác như thế nào [cốt lõi, ★].
(a) Một ảnh có dung lượng 0,8 MB; sau khi mã hóa nó cho ra tensor đặc trưng BF16 có shape , với băng thông đường lên 6,4 Mbit/s. Mã hóa hình ảnh cần 1,31 TFLOP phép tính ma trận; hãy mã hóa cục bộ trên RTX 4090 và từ xa trên H100 SXM, dùng đỉnh dense BF16 của chúng (165,2 và 989,4 TFLOP/s) để tìm cận dưới thời gian mã hóa. So sánh tổng thời gian mã hóa cục bộ rồi tải đặc trưng lên với việc tải ảnh gốc lên rồi mã hóa từ xa.
(b) Đổi liên kết thành một cổng ConnectX-7 400 Gbit/s (50 GB/s mỗi chiều), và dùng việc tải trực tiếp ảnh gốc làm đường cơ sở, tìm xem việc tải đặc trưng hình ảnh lên tốn thêm bao nhiêu thời gian truyền; so sánh con số này với chênh lệch thời gian mã hóa giữa hai loại card trong (a) để xác định yếu tố nào quyết định vị trí của bộ mã hóa trong trường hợp này.
(c) Di trú đòi hỏi truyền 64 MiB trạng thái ở tốc độ 80 Mbit/s, cộng thêm 1 giây khôi phục; sau khi di trú, thời gian thực thi mỗi lượt giảm 0,4 giây. Tìm thời gian tiết kiệm ròng tương ứng cho 10, 20 và 40 lượt còn lại. Nếu thời gian khôi phục tăng thêm 1 giây nữa, tối thiểu phải thực thi thêm bao nhiêu lượt để bù được chi phí di trú?
(d) Giải thích, sau khi lần lượt lưu ảnh, đặc trưng hình ảnh và KV ngôn ngữ, việc tính lại nên nối tiếp từ đâu; giải thích cách các kết quả thao tác đã cam kết (committed) đi vào quá trình khôi phục.
12-4 Tái sử dụng kết nối và truyền tải đa luồng [mở rộng, ★].
(a) RTT là 200 ms, tác vụ có tổng cộng 30 lượt, và mỗi kết nối mới cần thêm hai vòng khứ hồi. Tính chênh lệch thời gian giữa việc thiết lập kết nối mới mỗi lượt và tái sử dụng một kết nối xuyên suốt.
(b) Tính riêng tổng số byte truyền cho ảnh, phần đầu (headers) và ACK dưới phương án báo nhận tức thời so với báo nhận gộp, và giải thích vì sao ít byte hơn được truyền thực tế nhưng vẫn có thể dẫn đến thời gian hoàn thành yêu cầu lâu hơn.
(c) So sánh mức ưu tiên gửi với việc bàn giao theo luồng trong Hình 12-20: chỉ ra điều gì thay đổi trong các giai đoạn sử dụng tài nguyên và các phụ thuộc chờ trong từng trường hợp.
(d) Thiết kế một tập các thí nghiệm có đối chứng chỉ thay đổi phương pháp tái sử dụng kết nối trong khi giữ mọi điều kiện khác cố định, liệt kê các sự kiện bắt đầu/kết thúc và các sự kiện trung gian dùng để giải thích các thay đổi thời gian.
12-5 Tần suất ACK và hiệu quả giao diện vô tuyến [mở rộng, ★].
(a) Một lần trao đổi khung dữ liệu mất 302 μs, và một lần trao đổi khung báo nhận mất 134 μs. Tổng cộng có 30.800 lần trao đổi khung dữ liệu, ban đầu mỗi lần được báo nhận riêng lẻ. Sau khi giảm một nửa số ACK, bao nhiêu thời gian giao diện vô tuyến được giải phóng?
(b) Vẽ sơ đồ trục thời gian khi bên gửi tạm dừng để chờ một ACK gộp, và giải thích mối quan hệ giữa việc giải phóng thời gian vô tuyến và việc bàn giao sớm.
(c) Phát PCM cần tốc độ 256 kbit/s, tốc độ nhận thực tế là 130 kbit/s, và bộ đệm ban đầu là 60 ms; tìm thời gian cạn đệm. Giữ nguyên tốc độ nhận và thời lượng âm thanh ban đầu 60 ms, đổi tần số lấy mẫu từ 16 kHz sang 24 kHz và tìm thời gian cạn đệm mới.
12-6 Chia lưu lượng và dự phòng qua hai đường [mở rộng, ★].
(a) 30 MB được chia qua hai đường ở tốc độ 20 và 10 Mbit/s; suy ra tỷ lệ chia và thời gian cần để cả hai đường cùng hoàn thành.
(b) Thêm một liên kết thoát (egress) dùng chung 24 Mbit/s, tìm cận dưới mới cho thời gian truyền, và xác định việc tăng băng thông của đoạn nào sẽ hạ cận dưới này.
(c) Hai đường truy nhập có xác suất lỗi lần lượt là 0,1 và 0,05, còn điểm cuối dùng chung có xác suất lỗi 0,02. Dùng giả định lỗi độc lập từ văn bản chính, tìm xác suất tác vụ vẫn thất bại sau khi gửi một bản sao đầy đủ qua mỗi đường; xác suất này là bao nhiêu khi cả hai đường truy nhập đều hoàn toàn tin cậy?
(d) Nhân bản mỗi khối trong tám khối âm thanh một lần, mỗi khối là 640 byte, tìm số byte thêm phải truyền, và giải thích cách bên nhận tránh phát trùng lặp.
12-7 Dùng thí nghiệm đơn yếu tố để phân biệt thiết lập kết nối, kích thước cửa sổ và độ trễ truyền tải [cốt lõi, ★★].
(a) Tính tỷ lệ thời gian trung vị của đường trực tiếp so với đường Queqiao trong hai nhóm thí nghiệm — kết nối mới mỗi lần so với kết nối bền vững đã tinh chỉnh — và giải thích lời giải thích “khoảng cách chính đến từ thiết lập kết nối và thời gian chờ gửi” hàm ý dự đoán gì.
(b) Với lượng dữ liệu khoảng 355 KB, tốc độ truyền 333 Mbit/s, RTT 200 ms và thời gian xử lý 30 ms, tìm thời gian hoàn thành lý tưởng. So sánh với thời gian đo được ban đầu khoảng một giây, và ước lượng còn bao nhiêu thời gian chờ cần được giải thích.
(c) Thiết kế một thí nghiệm đơn yếu tố về kích thước cửa sổ, giải thích cách luân phiên giữa các cấu hình cửa sổ khác nhau, và cần quan sát những gì về lượng dữ liệu đang lưu thông (in-flight), hành vi ACK và thời điểm gửi để hỗ trợ lời giải thích “cửa sổ giới hạn tốc độ truyền”.
(d) Dùng các bản ghi âm kèm theo, vẽ biểu đồ mốc thời gian của một khối từ lúc sinh ra đến khi phát, giải thích cách phân biệt sự sinh trễ, độ trễ truyền và thời gian chờ lập lịch cục bộ.
12-8 Băng thông đường lên và khôi phục sau lỗi làm thay đổi thời gian và năng lượng của triển khai xuyên vùng như thế nào [mở rộng, ★★].
(a) Tính lại thời gian và năng lượng cho tác vụ còn lại hai mươi lượt dưới ba phương án triển khai, rồi tìm băng thông đường lên mà đám mây cần để hoàn thành đúng hạn, và giải thích vì sao đám mây không bao giờ đuổi kịp trạm làm việc gần đó dù tốc độ đường lên có cao đến đâu.
(b) Đổi thành mười lượt còn lại với hạn chót 23 giây, và chọn phương án hoàn thành đúng hạn với mức tiêu thụ năng lượng thấp nhất; sau đó siết hạn chót xuống 15 giây và chọn lại.
(c) Trong một tương tác hai mươi lượt, mười lượt có tốc độ đường lên 6 Mbit/s và mười lượt còn lại có 10 Mbit/s; tìm tổng thời gian của đám mây, so sánh với tốc độ không đổi 8 Mbit/s, và giải thích sự khác biệt.
(d) Với một tác vụ mười lượt và hạn chót 23 giây, giả sử lượt tám vừa thực thi xong thì kết nối rơi, và việc kết nối lại mất 2 giây. Xét hai trường hợp khôi phục: tiến trình qua lượt bảy đã được giữ lại, chỉ cần làm lại lượt tám; hoặc toàn bộ tiến trình qua lượt tám bị mất, cần làm lại toàn bộ. Tính thời gian cần để hoàn thành phần việc còn lại trong từng trường hợp, và tổng thời gian tác vụ.
Bài tập này chỉ giả định dịch vụ từ xa gặp sự mất kết nối; phương án thiết bị cục bộ vẫn thực thi bình thường. Dịch vụ từ xa giữ trạng thái đang chạy của nó trong thời gian mất kết nối và tiếp tục dùng nó khi kết nối được phục hồi, nên không cần chuẩn bị lại; tiến trình tác vụ được khôi phục theo hai trường hợp nói trên. Các lượt làm lại phải được tính lại năng lượng model của chúng. Hãy chọn lại phương án đáp ứng hạn chót với mức tiêu thụ năng lượng thấp nhất.
12-9 Ngân sách băng thông, dung lượng và năng lượng cho thiết bị cục bộ [mở rộng, ★].
(a) Bốn kênh LPDDR5X x16 ở tốc độ 10,6 Gbit/s mỗi chân cho tổng băng thông bao nhiêu? Sau đó tìm cận dưới thời gian mỗi bước và trần token/s cho một lần giải mã (decode) 8K một yêu cầu BF16 của Qwen3-8B (đọc 15,14 GB trọng số và 1,21 GB KV mỗi bước).
(b) Sau khi lượng tử hóa trọng số sang q4_0 (cứ 32 giá trị đi từ 64 byte xuống 18 byte), tính lại cận dưới mỗi bước và trần token/s; trên một chiếc điện thoại có 12 GB bộ nhớ với 4 GB được dành riêng, tìm dung lượng còn lại sau khi trừ trọng số, số yêu cầu 8K đặt vừa, và chiều dài ngữ cảnh tối đa tính bằng token cho một yêu cầu.
(c) Dùng 0,576–0,756 J mỗi token và trần công suất duy trì 13,8 W, tìm trần token/s do riêng công suất ám chỉ; so sánh với các trần băng thông BF16 và q4_0, và xác định ràng buộc nào thắt chặt trước tiên.
12-10 Mất gói, truyền lại và dư thừa mã hóa [mở rộng, ★★].
(a) Với MSS 1.448 byte và RTT 0,2 s, tìm cận trên Mathis tại các tỷ lệ mất gói 14% và 3,6%, và thời gian cần để chỉ riêng việc gửi 354.640 byte dưới mỗi cận.
(b) 245 gói, mỗi gói bị mất độc lập với xác suất 14%. Tìm số gói mất kỳ vọng. Giả sử mỗi lượt dùng một RTT cho truyền lại chọn lọc lý tưởng, và các gói truyền lại tiếp tục bị mất với xác suất , nên số lượt cần cho mỗi gói tuân theo phân phối hình học với xác suất thành công ; xác suất cả 245 gói tới nơi trong lượt là . Ngân sách nối tiếp là 238,5 ms, với mỗi lượt thêm cộng thêm một RTT; tìm thời gian hoàn thành kỳ vọng, rồi lấy phân vị thứ 99 của phân phối số lượt để có p99.
(c) Ở tỷ lệ thành công 99,9%, cần bao nhiêu gói sửa chữa và tỷ lệ dư thừa kết quả là bao nhiêu, cho từng mức trong hai tỷ lệ mất gói? Tìm thời gian hoàn thành gồm cả phần dư thừa này, và so sánh với p99 truyền lại tương ứng.
(d) Giải thích vì sao tỷ lệ dư thừa nên được điều chỉnh dựa trên tỷ lệ mất gói đo được thay vì cố định ở 25,7%: đưa ra lý do theo cả hướng không đạt được mục tiêu tỷ lệ thành công và hướng lãng phí băng thông gửi.
Chú thích nguồn
-
Bản tóm tắt sản phẩm Snapdragon 8 Elite và bản tóm tắt thế hệ thứ năm: hỗ trợ LPDDR5X tới 5.300 MHz, dung lượng tối đa 24 GB, không công bố độ rộng bus. Trang sản phẩm Micron LPDDR5X: mức tốc độ cao nhất 10,7 Gbit/s, chuẩn JEDEC là thiết bị đơn kênh x16, với quy trình 1γ bổ sung các tùy chọn dung lượng 6/12/24 GB cùng một thiết bị 16 GB hướng tới điện thoại flagship; trang sản phẩm Samsung LPDDR5X cũng dừng ở mức 10,7 Gbit/s. Trang thông số iPhone 16 Pro của Apple không công bố dung lượng hoặc tốc độ bộ nhớ.
-
Sổ tay bus và năng lượng thiết bị cục bộ: số kênh được lấy là bốn x16 (
declared_phone_channels_x16=4; bản tóm tắt SoC không cho độ rộng bus), tốc độ mỗi chân lấy theo mức SoC hỗ trợ 10,6 Gbit/s, tổng cộng 84,8 GB/s; 15.136.819.200 byte trọng số và 1.207.959.552 byte KV được đọc trực tiếp từ kết quả giải mã 8K một yêu cầu. -
MELTing Point: Mobile Evaluation of Language Transformers, arXiv 2403.12844, §5.2.2 và Bảng 5 ở Phụ lục: 0,16/0,20/0,21 mWh mỗi token; iPhone 14 Pro có trần công suất duy trì 13,8 W với các đỉnh tức thời trên 18 W, trong khi Galaxy S23 duy trì dưới 8,5 W; trên iPhone 14 Pro, Zephyr-3B q4_k chạy ở 14,8 token/s và Llama-2 7B q3_k ở 6,0 token/s; một lần sạc có thể chạy 490,05–590,93 prompt (542,78 với S23). Việc kiểm tra từng dòng các giá trị được trích xuất nằm trong bảng trích xuất giá trị.
-
Mathis và cộng sự, The Macroscopic Behavior of the TCP Congestion Avoidance Algorithm, ACM CCR 1997. Phương trình (3): ; với mất gói tuần hoàn và báo nhận từng gói thì , còn với mất gói ngẫu nhiên là 1,31; Phương trình (4) cho một cận trên đơn giản hơn.
-
BBR Congestion Control, bản thảo IETF draft-cardwell-iccrg-bbr-congestion-control-02: BBR.max_bw là giá trị lớn nhất của các mẫu băng thông gần đây trong một cửa sổ, BBR.min_rtt là mẫu RTT nhỏ nhất trong một cửa sổ, và BBR.bdp là tích của chúng; độ lợi pacing của Startup là với cwnd_gain là 2, còn độ lợi pacing của ProbeBW_UP là 1,25.
-
Các phép tính tại tỷ lệ mất gói 14% và tỷ lệ mất gói 3,6%. Các tham số đường đi được lấy từ bản ghi đường Queqiao: khứ hồi 199–207 ms, điểm gấp dung lượng khoảng 333 Mbit/s, mất gói chiều tải xuống từ Irvine đến Quý Dương khoảng 14% (3,6% trong một giai đoạn khác), mất gói bằng không trên 41.663 gói từ Quý Dương đến Irvine, MSS 1.448 byte, kích thước tệp cố định 354.640 byte; thời gian model được lấy theo khoảng 30 ms trong phần đo lại tệp cố định, nhất quán với phép đo: trung vị đã tinh chỉnh 236,5 ms trừ đi khứ hồi ngắn nhất cùng giai đoạn là 197 ms và 8,5 ms gửi để lại thời gian model không quá khoảng 31 ms; con số 38 ms đã ghi chú trước đó đến từ một phép thử trước luân phiên qua tám tệp. Kích thước ký hiệu FEC được lấy bằng MSS, còn mục tiêu thành công khôi phục khối được lấy là 99,9%. Mô hình truyền lại thực hiện một truyền lại chọn lọc lý tưởng mỗi lượt, bỏ qua thu hẹp cửa sổ và truyền lại do hết thời gian chờ, nên là một cận dưới có lợi cho TCP.
-
Tình huống nâng cao chất lượng ảnh RAW và ngân sách có điều kiện. Ví dụ đặt ảnh gốc là 30 MB, ảnh hoàn thiện là 5 MB, và thời gian xử lý ảnh là 0,3 giây.
-
Hai phép tính cho ba khối lần lượt là 12,8 s và 12,36 s; văn bản chính giải thích lợi ích chồng lấn bằng chênh lệch khoảng 0,4 s; một bản xem trước bổ sung làm tăng thêm mã hóa và truyền tải. Nguồn: rào cản toàn ảnh, các khối độc lập và bản xem trước bổ sung.
-
Phép tính mốc thời gian khối âm thanh; sự tương ứng một-một giữa các khung đầu vào và các khối âm thanh đầu ra là một sự đơn giản hóa của mô hình này, dùng để minh họa sự phụ thuộc giữa xử lý từng khối và việc phát theo đúng thứ tự.
-
Tài liệu và phán đoán kỹ thuật của tác giả. AOI và Latent Bridge được dùng để minh họa thông tin giao diện nào cần quan sát và dữ liệu nào nên được truyền giữa các thiết bị.
-
Shape hình ảnh cố định với phép tính EC/KV đầy đủ, tình huống đặt giai đoạn đa phương thức. Các biến thể với hình ảnh cố định, DeepStack và trạng thái ngôn ngữ được đo riêng biệt.
-
Phép tính thiết bị cho vị trí mã hóa và thiết lập ba tầng biên/máy chủ biên/đám mây: khối lượng công việc ma trận cho mã hóa hình ảnh được lấy từ kết quả mã hóa hình ảnh một ảnh, còn giá trị đỉnh được lấy từ bảng tham số phần cứng; bảng dữ liệu ConnectX-7: tốc độ một cổng lên tới 400 Gbit/s.
-
Thí nghiệm mã hóa CPU Qwen3-VL-8B và truyền TCP cục bộ. Đầu vào là ảnh thử nghiệm tổng hợp 256×256; EC đầy đủ khoảng 2 MiB, PNG khoảng 3,4 KiB; dữ liệu giống hệt từng bit trước và sau 8 lần truyền. Mã hóa hoàn tất trước khi bắt đầu tính thời gian truyền; các con số thời gian được liệt kê tương ứng với giai đoạn truyền đặc trưng.
-
Phép tính khối lượng truyền thông mỗi thao tác cho Qwen3-8B với TP=2, PP=4. Mỗi lớp trong 36 lớp có hai phép khử đầu ra, tạo tổng cộng 72 lần khởi động truyền thông; các embedding, kích hoạt theo giai đoạn, logits và việc trả về token bổ sung thêm truyền thông.
-
RFC 9000: QUIC Transport, §2, §7, §9, §13; RFC 9001: TLS; RFC 9114: HTTP/3; RFC 9221: Unreliable Datagrams. HTTP/3 quy định cách truyền các yêu cầu và phản hồi HTTP qua QUIC.
-
Phân tích gói chính xác là 25.685 gói tải lên, 4.281 gói tải xuống; tổng cộng 29.966 gói dữ liệu cộng với cùng số lượng ACK; truyền tải thực tế trên mạng là 39.554.832 byte; phản hồi hoàn chỉnh mất 14,36339008 s. Nguồn: vòng kín tham chiếu ảnh hoàn chỉnh.
-
Trong cùng điều kiện phần đệm, ACK tức thời là 39.555.120 byte/14,52103724 s, còn ACK gộp là 38.177.328 byte/14,564459796 s — chênh lệch khoảng 1,38 MB và 43,4 ms. Nguồn: điều khiển NewReno ACK tức thời, điều khiển ACK gộp và bản ghi giai đoạn điều khiển CUBIC.
-
FIFO và ưu tiên âm thanh; với các bản ghi gửi cố định, thứ tự toàn kết nối và bàn giao theo luồng. Các phép tính này lần lượt xem xét tác động của việc lập lịch gửi và các phụ thuộc bàn giao phía bên nhận.
-
Phép tính ảnh trên phổ dùng chung. Dữ liệu và MAC ACK dùng OFDM 54/6 Mbit/s tương ứng, không gộp khung; thời gian chờ truy nhập kênh là SIFS 16 μs cộng hai khe 9 μs, tức DIFS 34 μs của OFDM 802.11a, không gồm backoff ngẫu nhiên; báo nhận lớp MAC và báo nhận đầu cuối-đầu cuối được đo riêng biệt.
-
The New Golden Age of Computer Networking (Phần 3), giới thiệu bối cảnh lịch sử của TACK, Link Turbo và việc triển khai proxy.
-
Phép tính phản hồi hỗn hợp cho ưu tiên đa phương tiện và ACK gộp cùng các điều khiển FIFO/ACK tức thời trong cùng thư mục. Thời gian xử lý model và mốc phát được lập lịch do phép tính thiết lập.
-
Thí nghiệm hai tiến trình, hai kết nối TCP: thí nghiệm mô phỏng hai đường truyền bằng hai tiến trình và hai kết nối TCP; 30 lần thử chính thức gồm các trường hợp lỗi điểm cuối dùng chung.
-
Về định vị của hệ thống và động lực cho việc vận hành xuyên trung tâm dữ liệu, xem Queqiao README, bản lưu cố định, tương ứng với commit GitHub
496ca627, đọc ngày 2026-09-10. Mô tả hệ thống theo phiên bản này; dữ liệu so sánh hiệu năng đến từ commit168ff4b. -
Bản ghi đường đi bản lưu cố định và bản ghi thiết kế, từ commit
168ff4b. Các tệp, cài đặt tinh chỉnh và các điểm bắt đầu/kết thúc tính thời gian đều tuân theo định nghĩa trong các bản ghi gốc. -
Với các kết nối mới thiết lập, p50 trực tiếp/Queqiao là 1185,3/301,6 ms; với các kết nối bền vững đã tinh chỉnh là 240,9/236,5 ms; hai tỷ lệ trung vị lần lượt khoảng 3,93/1,019. Lấy trung vị của các tỷ lệ thời gian mỗi lượt sẽ cho 3,96/1,03. Nguồn: thống kê Queqiao cùng điều kiện.
-
Trong 8 lần thử nghiệm thu hoàn chỉnh, PCM thu được và PCM được callback phát đọc giống hệt từng bit trong mọi trường hợp; callback phát tích lũy 360–1440 ms không lấy được đủ mẫu âm thanh. Thí nghiệm dùng thiết bị đầu ra đã tắt tiếng; bản ghi gồm cả các sự kiện thu và các sự kiện callback phát. Thêm 3 yêu cầu nữa bị hủy trước callback phát đầu tiên; số byte nhận được, các sự kiện đóng kết nối và EOF từ xa ghi lại quá trình hủy. Dữ liệu đầy đủ bốn lượt xuất hiện trong bản ghi chú bằng chứng kèm theo. Nguồn: thí nghiệm âm thanh với ràng buộc giao diện vật lý tường minh, cố định tại commit
496ca627; đường cơ sở gồm việc thích ứng gắn socket. -
Thảo luận về mạng xuyên đám mây và Regionless trong The New Golden Age of Computer Networking (Phần 2). Phương án vùng của chương này đo chi phí theo mức tiêu thụ năng lượng thiết bị và thời gian GPU.
-
Với lần chạy lại cùng model, cùng chuỗi token và cùng lượt, dữ liệu gửi tới máy chủ lần lượt là 66.207/10.193 byte, còn dữ liệu trả về máy khách là 2.527 byte trong cả hai trường hợp. Khối lượng công việc ma trận lần lượt là 296.505.803.538.432 và 60.380.764.176.384 FLOP; chia cho đỉnh dense BF16 của H100 SXM cho cận dưới thời gian GPU; trạng thái là 465.371.136 byte, và quy đổi thời gian lưu trú của nó theo phần chia trong 80 GB bộ nhớ GPU cho thấy sau khoảng 41,0 s thì khoản tiết kiệm 0,239 giây GPU bị triệt tiêu. Nguồn: đặt vùng cho một quỹ đạo agent cố định; các byte và token đến từ quỹ đạo gốc.
-
Phép tính thiết bị cho thiết lập ba tầng biên/máy chủ biên/đám mây. Lượng đọc mỗi bước được lấy từ trọng số và KV trong kết quả giải mã 8K một yêu cầu, với trọng số được sắp xếp lại thành q4_0 ở 18 byte mỗi 32 giá trị; các con số bus của điện thoại được lấy từ hạch toán bus và năng lượng phía biên; băng thông, đỉnh dense BF16 và công suất định mức đến từ bảng tham số phần cứng; hệ số nhân đo được đến từ hàng batch-1, 8K của bảng hiệu quả cho Thí nghiệm 8-1. Tệp kết quả cũng liệt kê mọi trường hợp cho mười lượt, các hạn chót siết chặt và việc khôi phục sau mất kết nối.
-
Phép tính lại theo hạng mục và chương trình tính toán cho các so sánh điều kiện của chương này.
-
Báo cáo kỹ thuật chính thức DeepSeek V4.1, các Mục 1, 2, 3 và 6; các điều kiện cố định và phép tính lại cho phiên xuyên chương.
Tóm tắt chương
Một tương tác hoàn chỉnh cần được phân tích ở ba mức. Trước hết, suy ra thời gian cần cho mỗi bước từ lượng dữ liệu, lượng tính toán và khoảng cách truyền lan; sau đó, dựa trên các phụ thuộc thực thi, xác định chi phí thời gian nào phải cộng dồn và bước nào có thể chồng lấn; cuối cùng, thêm vào thiết lập kết nối, cơ chế cửa sổ, tranh chấp và khôi phục để giải thích thời gian chờ quan sát được trong thực tế. Thời gian hoàn thành 12,8 giây của ảnh, sự lặp lại từng khối của giọng nói, và sự tích lũy từng lượt của một tác vụ agent đều cho thấy ba mức này hoạt động cùng nhau như thế nào. Bản thân thiết bị biên cũng khai triển theo cùng một lối: băng thông bộ nhớ đặt cận trên cho số token mỗi giây, dung lượng quyết định những model và kích thước ngữ cảnh nào có thể được đặt vừa, còn mức tiêu thụ năng lượng và pin quyết định nó có thể chạy liên tục trong bao lâu.
Phân chia model làm thay đổi hình thái và tần suất dữ liệu được truyền qua các thiết bị. Chuyển tính toán về biên có thể thay một ảnh gọn nhẹ bằng một đặc trưng lớn hơn; tách model trên nhiều thiết bị có thể thay một lần truyền đơn lẻ bằng việc đồng bộ hóa từng lớp. Khi so sánh các phương án, trước hết trừ đi chi phí thời gian mà cả hai cùng phải chịu, rồi so sánh thời gian tính toán tiết kiệm được với thời gian truyền thông tăng thêm — điều này cho thấy lợi ích thực sự đến từ đâu.
Tái sử dụng san sẻ một chi phí chuẩn bị một lần trên các lần gọi sau. Di trú, khởi động nóng kết nối, biên dịch đồ thị và lưu trạng thái đều có thể được đánh giá, dựa trên chi phí chuẩn bị và thời gian tiết kiệm được mỗi lần dùng, để xác định số lần dùng tối thiểu cần thiết mới đáng giá. Thời gian hoặc chi phí kỳ vọng tiết kiệm được cũng cần chừa biên độ để hấp thụ chi phí hao tổn do biến động và khôi phục.
Mô hình thời gian này cũng có thể được áp dụng khi thiết kế thí nghiệm. Cố định đầu vào và các điểm bắt đầu/kết thúc tính thời gian, ghi lại thời gian chờ ở mỗi giai đoạn, rồi thay đổi các cài đặt từng cái một và kiểm tra xem sự thay đổi tổng thời gian có thể được giải thích bằng sự thay đổi ở một giai đoạn cụ thể hay không. Việc hiệu chỉnh đường cơ sở của Queqiao minh họa quá trình này: một khi việc tinh chỉnh loại bỏ phần lớn thời gian chờ thừa, việc cải thiện hiệu năng tiếp theo đòi hỏi rút ngắn thời gian truyền lan. Mất gói cũng không nhất thiết chỉ ra tắc nghẽn: trên một đường có mất gói ngẫu nhiên, việc suy băng thông từ tỷ lệ mất gói đánh giá thấp tốc độ khả dụng đi khoảng ba bậc độ lớn; chỉ bằng cách đo băng thông trực tiếp, rồi đặt dư thừa mã hóa theo tỷ lệ mất gói đo được, thời gian hoàn thành mới có thể được kéo trở lại gần ngân sách nối tiếp.
Lựa chọn cuối cùng thỏa mãn trước tiên các yêu cầu về chất lượng và hạn chót, rồi mới so sánh chi phí. Ngay cả khi tốc độ tính toán trung bình và tốc độ truyền tải là đủ, một tác vụ vẫn có thể chạy quá hạn chót do một lượt chậm hoặc tiến trình bị mất; do đó, xác suất hoàn thành đúng hạn và khối lượng công việc làm lại sau khôi phục là một phần của ý nghĩa việc triển khai một model.
Quay lại ứng dụng model được đề xuất trong Chương 1: nhà phát triển diễn đạt tác vụ qua ngữ cảnh, và hệ thống thực thi sắp xếp tính toán, lưu trạng thái và truyền dữ liệu tương ứng. Giờ đây, giữ lại một mẩu lịch sử, thêm một nhánh ứng viên, chuẩn bị trước môi trường công cụ, hoặc di trú một phiên — mỗi việc trong số đó đều mang theo một chi phí tài nguyên có thể theo dõi được. Hiểu các chi phí này giúp xác định được chi phí hao tổn thực thi chung nào có thể được loại bỏ bằng thông tin cấp ứng dụng, và chọn một phương án triển khai dựa trên chất lượng tác vụ, thời gian hoàn thành và tổng chi phí. Đây là năng lực thiết kế hệ thống mà việc nghiên cứu AI Infrastructure mang lại.