Chương 11 · Lập lịch tài nguyên & môi trường thực thi
Model serving và môi trường thực thi công cụ chia sẻ tài nguyên nhàn rỗi, giảm thời gian chờ và tăng tận dụng tài nguyên.
~85 phút đọc · Thuật ngữ
Lập lịch tài nguyên và môi trường thực thi
Một dịch vụ sửa mã nguồn nhận một vấn đề do người dùng gửi lên, yêu cầu model tạo ra bản sửa lỗi, sau đó để một công cụ sửa đổi tệp và chạy kiểm thử, trao kết quả kiểm thử lại cho model, và tiếp tục vòng tiếp theo cho tới khi thu được một bản vá vượt qua các bài kiểm thử. Công việc này — bắt buộc phải cho ra kết quả cuối cùng — được gọi là một task (tác vụ); một yêu cầu model đơn lẻ hay một lần thực thi công cụ đơn lẻ chỉ là một bước trong đó.
Controller (bộ điều khiển) lưu bản ghi của task và quyết định gọi thành phần nào tiếp theo, executor (bộ thực thi) thực sự chạy các công cụ, còn môi trường thực thi chứa các tệp, tiến trình và bộ nhớ mà các công cụ cần. Lời gọi model dùng dịch vụ suy luận, thực thi công cụ dùng CPU, còn các tiến trình và bộ nhớ đệm bên trong môi trường chiếm bộ nhớ. Bằng cách theo dõi từng lời gọi, từng kết quả trả về và từng lần chờ đợi, ta có thể suy ra khi nào và trong bao lâu mỗi loại tài nguyên này bị chiếm dụng.
Hai chương trước đã thảo luận việc xây dựng các dịch vụ suy luận và huấn luyện. Chương này xem xét cách tổ chức các dịch vụ model, môi trường công cụ và tài nguyên dùng chung thành một hệ thống thực thi task. Xuất phát từ một bài toán thiết kế nền tảng, chúng ta lần lượt thảo luận khi nào nên tạo và giải phóng môi trường, cách lập lịch task, cách chọn model và cách phục hồi sau sự cố.
Bài toán thiết kế xuyên suốt: dung lượng tài nguyên, hạn hoàn thành và chi phí task của một nền tảng sửa mã nguồn. Chương này phát triển thảo luận quanh các điều kiện sau. Các task đến đều đặn, mỗi task cách nhau 0,1 giây; mỗi task thực thi ba vòng, và mỗi vòng trước tiên gọi model, sau đó chạy công cụ. Công cụ dùng một nhân CPU và thực thi trong 1 giây, bao gồm đọc tệp, chạy kiểm thử, lưu kết quả và dọn dẹp trạng thái làm việc. Thư mục làm việc và kết quả của công cụ được lưu trong bộ lưu trữ bền vững, nên tiến trình công cụ có thể được dựng lại giữa các vòng.
| Đầu vào thiết kế | Giá trị cho trước |
|---|---|
| Tốc độ đến của task | 10 task/s |
| Mỗi task | 3 lần gọi model, 3 lần thực thi công cụ |
| Dịch vụ model | DeepSeek V4-Flash, 4 B200 mỗi replica, phục vụ đồng thời 32 phiên |
| Thời gian một lần gọi đầy đủ của dịch vụ model thông thường | 355 token đầu ra mỗi lần gọi, khoảng 25,3 ms mỗi token, tổng cộng khoảng 9,0 s |
| Dung lượng đồng thời của dịch vụ model | 10 replica (40 B200), tối đa 320 lần gọi đồng thời |
| Thời gian thực thi công cụ và thời gian CPU tích lũy | 1 s, 1 CPU-giây mỗi lần thực thi |
| Môi trường công cụ đang hoạt động | microVM (máy ảo thu nhỏ) với 1 vCPU, 2 GiB bộ nhớ |
| Nền tảng công cụ | Một EC2 m5d.metal (máy chủ kim loại trần của đám mây Amazon): 48 nhân CPU, 384 GB (khoảng 358 GiB) bộ nhớ |
| Mục tiêu dịch vụ | Ít nhất 95% task được gửi đi vượt qua kiểm thử trong 24 s |
Thời gian mỗi token được lấy từ ước tính dịch vụ của cuốn sách này cho lần triển khai đó, và đã tính gộp xử lý đầu vào cũng như tái lập ngữ cảnh phân bổ đều theo từng token. m5d.metal là máy chủ được dùng trong các benchmark microVM của bài báo Firecracker (bộ giám sát máy ảo nhẹ mã nguồn mở của Amazon); thông số 1 vCPU, 2 GiB là một trong những thông số sandbox được liệt kê trên trang giá của E2B (một nền tảng môi trường thực thi công cụ).
Chúng ta bắt đầu bằng một sơ đồ đơn giản: khi task bắt đầu, một môi trường được cấp phát từ một bể môi trường đã chuẩn bị sẵn và không được giải phóng cho tới khi task kết thúc; sau khi dọn dẹp trạng thái làm việc, môi trường có thể được trao cho task tiếp theo. Các phần sau lần lượt xem xét chi phí tạo môi trường, bùng nổ yêu cầu, lựa chọn model và phục hồi sự cố, đồng thời so sánh nhu cầu tài nguyên của từng sơ đồ trong cùng một bộ điều kiện task.
11.1 Tính nhu cầu tài nguyên từ quá trình thực thi task
11.1.1 Thực thi và chờ đợi của một task sửa mã nguồn
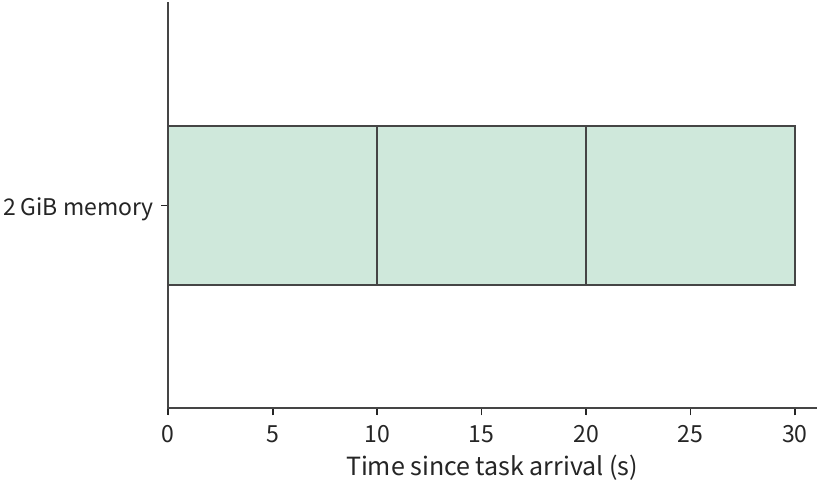
Lấy task sửa mã nguồn ở đầu chương làm ví dụ. Trong mỗi vòng, model trước tiên dành 9 giây để tạo ra một lời gọi công cụ, sau đó công cụ thực thi trong 1 giây. Lời gọi model ở vòng sau cần kết quả kiểm thử của vòng này, nên ba vòng phải tiến hành tuần tự, tổng thời gian là giây. Vòng 1 kết thúc ở giây thứ 10, vòng 2 ở giây 20, và vòng 3 ở giây 30.
Trong khi chờ model tạo ra lời gọi công cụ tiếp theo, công cụ tạm thời không chiếm CPU, nhưng theo sơ đồ này môi trường của nó vẫn được giữ lại. Việc dừng thực thi không tự động giải phóng không gian đã chiếm dụng: còn lại là các tiến trình và bộ nhớ của môi trường; thư mục làm việc và kết quả công cụ đã nằm trong bộ lưu trữ bền vững, và việc hủy môi trường để dựng lại ở vòng sau có đáng hay không sẽ được so sánh trong Mục 11.2.
Trong 30 giây này, công cụ chỉ chiếm một nhân CPU, thực thi ba lần, mỗi lần 1 giây, với thời gian CPU tích lũy là 3 giây. Thời gian CPU ở đây là tổng thời gian thực thi thực tế trên các nhân, ký hiệu bằng CPU-giây: một nhân thực thi 3 giây, hay ba nhân mỗi nhân thực thi 1 giây, đều là 3 CPU-giây. Môi trường chiếm 2 GiB bộ nhớ trong suốt quá trình, nên tích của bộ nhớ chiếm dụng và thời gian là GiB-giây.
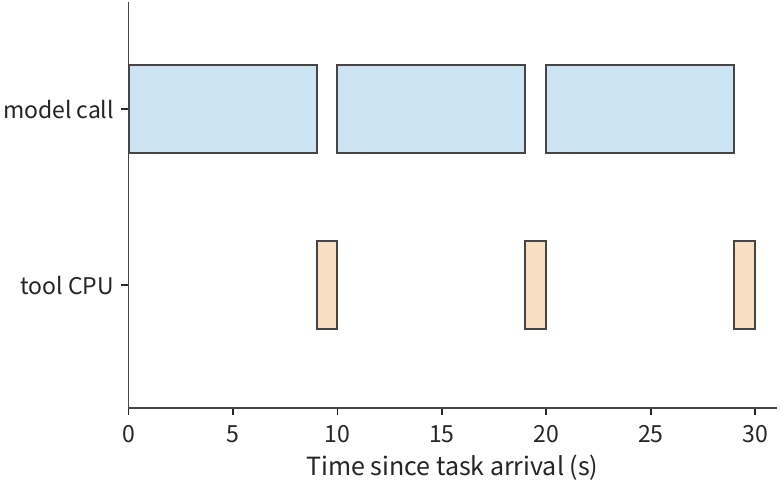
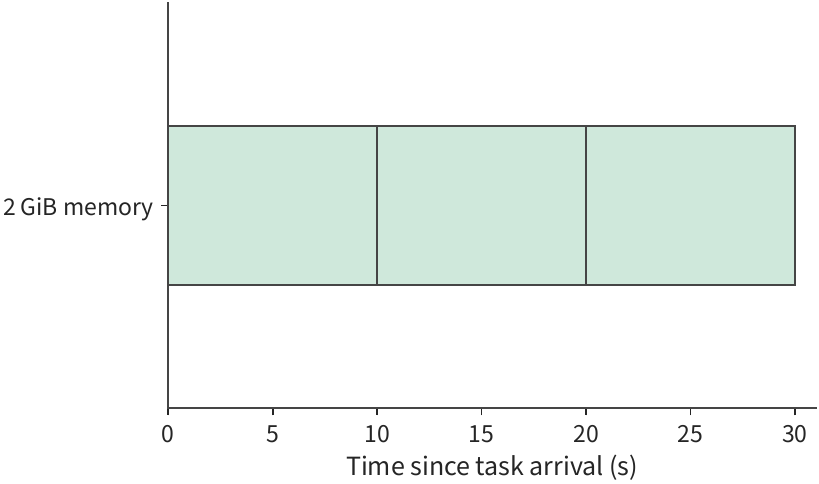
Sự chờ đợi này phát sinh từ quá trình trao đổi giữa controller và executor. Khi một lời gọi model kết thúc, controller nhận được đầy đủ tham số công cụ, rồi gửi tham số cho executor. Executor sửa đổi tệp, khởi chạy kiểm thử, lưu kết quả và trao kết quả lại cho controller. Công cụ phải chờ model sinh ra đủ tham số mới có thể thực thi, nên trong phần lớn thời gian của task nó không chiếm CPU.
Khi model dùng đầu ra streaming, nó có thể trả về văn bản từng phần sớm hơn, nhưng công cụ vẫn phải chờ đủ tham số của lời gọi: chỉ sau khi nhận được tệp đích, nội dung sửa đổi và loại thao tác, executor mới có thể thực hiện thay đổi. Việc tải template và khởi tạo runtime chỉ phụ thuộc vào loại môi trường đã định trước, nên có thể được chuyển sớm hơn, trong lúc model đang sinh. Mục 11.2 tận dụng khoảng thời gian này để chuẩn bị môi trường.
Tổng quát hóa ví dụ này lên vòng, khi các giai đoạn thực thi tuần tự, tổng thời gian của task là
Phương trình trên lần lượt tính đến xếp hàng, chuẩn bị môi trường, lời gọi model và thực thi công cụ của từng vòng, và thời gian cần để gửi kết quả cuối cùng. Thời gian gọi model gồm xử lý yêu cầu và trả về kết quả, thời gian thực thi công cụ gồm lưu kết quả của vòng đó, còn ký hiệu thời gian còn lại cần cho việc gửi cuối cùng. Nếu môi trường được chuẩn bị trong lúc gọi model, khi cả hai kết thúc công cụ có thể bắt đầu thực thi ngay. Hai giai đoạn vốn tuần tự giờ chồng lên nhau, và cả tổng thời gian task lẫn thời gian chiếm môi trường đều thay đổi tương ứng.
11.1.2 Khối lượng công việc CPU, thời gian trú môi trường và dung lượng đồng thời
Để gom nhu cầu của từng task lên toàn bộ nền tảng, trước tiên ta tính riêng số task, số lần gọi model và số lần tạo môi trường. Nền tảng nhận 10 task mỗi giây, mỗi task cần ba lần gọi model, nên ở trạng thái ổn định dịch vụ model nhận 30 lần gọi mỗi giây; công cụ cũng thực thi 30 lần mỗi giây. Nếu mỗi task chỉ tạo một môi trường, tốc độ tạo là 10 mỗi giây; nếu môi trường được dựng lại mỗi vòng thì là 30 mỗi giây. Dù khối lượng task như nhau, việc dựng lại môi trường mỗi vòng làm số lần tạo tăng gấp ba.
Các nhu cầu này đều xuất phát từ cùng một quan hệ:
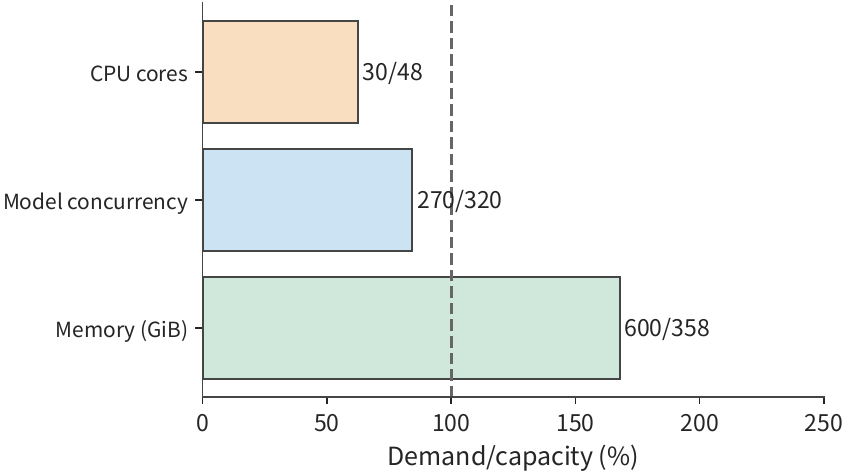
Mỗi task dùng tích lũy 3 giây thời gian CPU, nên các task đến trong mỗi giây cùng cần 30 giây thời gian CPU, tức trung bình 30 nhân CPU đang thực thi công cụ; mỗi task có thời gian chiếm bộ nhớ tích lũy là 60 GiB-giây, nên các môi trường của nền tảng cần trung bình 600 GiB bộ nhớ; mỗi task có ba lần gọi model, mỗi lần 9 giây, nên trung bình có lần gọi model đang tiến hành.
Ví dụ 11-1: Vì sao nền tảng sửa mã nguồn bị giới hạn trước tiên bởi dung lượng bộ nhớ môi trường? Chia các nhu cầu cho các dung lượng cho ở đầu chương: chiếm CPU là , mức dùng dung lượng đồng thời của lời gọi model là , còn nhu cầu bộ nhớ chạm . 358 GiB bộ nhớ chỉ chứa được nhiều nhất 178 môi trường 2 GiB đồng thời; vì mỗi môi trường phải được giữ trong 30 giây, nền tảng chỉ có thể khởi động nhiều nhất khoảng 5,9 task mỗi giây, phần còn lại phải xếp hàng. Lúc này 18 nhân CPU vẫn nhàn rỗi, nên thêm nhân CPU không thể giải quyết tình trạng thiếu bộ nhớ môi trường.
Ta cũng có thể suy ra trực tiếp số môi trường. Mỗi task chiếm một môi trường trong 30 giây, và 10 task mỗi giây bắt đầu dùng môi trường, nên ở trạng thái ổn định trung bình có 300 môi trường đang được sử dụng. Đây chính là định luật Little dưới dạng phù hợp với bài toán này:
Mỗi môi trường chiếm cố định 2 GiB bộ nhớ, nên 300 môi trường cần 600 GiB. Khi khối lượng bộ nhớ của một task thay đổi theo từng giai đoạn, thay diện tích chiếm dụng của từng task vào vẫn cho nhu cầu bộ nhớ trung bình. Tương tự, thời gian CPU cộng toàn bộ thời gian thực thi thực tế trên mọi nhân.
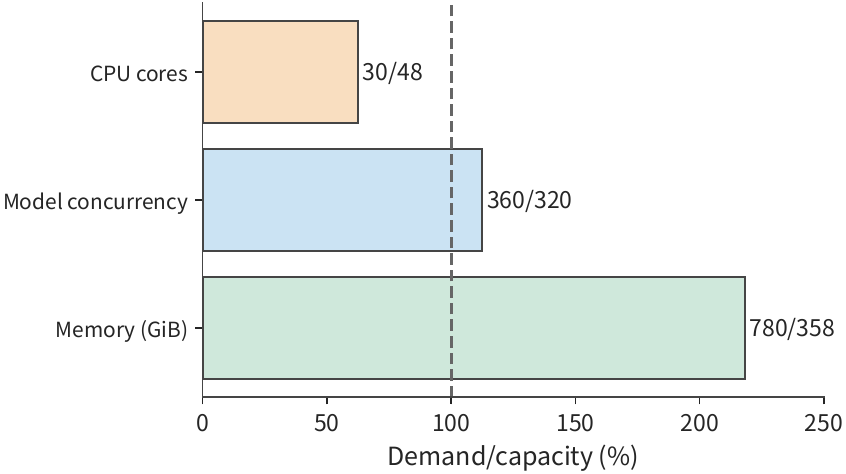
Kéo dài mỗi lần gọi model từ 9 giây lên 12 giây, với thực thi công cụ không đổi, thời gian task trở thành 39 giây, nhu cầu bộ nhớ trung bình tăng lên 780 GiB, số lần gọi model đồng thời tăng lên 360, trong khi công cụ vẫn chỉ cần trung bình 30 nhân CPU. Khoảng trống bộ nhớ càng nới rộng, và số lần gọi model đồng thời cũng vượt quá 320 slot đồng thời, nên càng nhiều task phải xếp hàng. Điều này cho thấy phản hồi model chậm hơn cũng làm tăng nhu cầu bộ nhớ của nền tảng công cụ, vì môi trường phải được giữ lâu hơn.
Hình 11-3 và 11-4 quy ba loại tài nguyên về phần trăm so với dung lượng tương ứng của chúng. Với 9 giây mỗi lần gọi, cột bộ nhớ đã vượt qua đường dung lượng; khi lời gọi chậm lại, chiều dài cột CPU không đổi, cột độ đồng thời của model cũng vượt qua đường dung lượng, còn cột bộ nhớ càng dài thêm. Bài toán vì thế chuyển từ “còn bao nhiêu CPU nhàn rỗi” sang “liệu có thể giảm bộ nhớ chiếm dụng trong lúc chờ không”.
Ngoài việc rút ngắn thời gian giữ môi trường, ta cũng có thể so le thực thi công cụ để giảm số tiến trình đồng thời chiếm bộ nhớ. Trong một tập thí nghiệm với bốn tiến trình công cụ chạy ngốn CPU, thời gian CPU tích lũy khi khởi động đồng thời so với khởi động so le lần lượt khoảng 0,29 giây và 0,27 giây — khối lượng công việc tương đương nhau. Kích thước tập thường trú (resident set size, RSS) là lượng bộ nhớ vật lý hiện bị chiếm dụng bởi các trang thường trú của một tiến trình; RSS đỉnh được lấy mẫu giảm từ khoảng 320 MiB xuống 80 MiB, trong khi thời gian để cả nhóm hoàn thành kéo dài từ khoảng 0,10 giây lên 0,54 giây. Sau khi so le khởi động, số tiến trình chạy đồng thời ít hơn nên đỉnh bộ nhớ giảm, nhưng cả nhóm task cũng mất nhiều thời gian hơn để hoàn thành.
11.1.3 Điều kiện hoàn thành task và trạng thái bắt buộc phải giữ lại
Giảm bộ nhớ chiếm dụng trong lúc chờ nghĩa là giải phóng một phần trạng thái của môi trường. Trước khi giải phóng, trước tiên ta phải xác định phần công việc nào sẽ phải làm lại nếu trạng thái này bị mất. Trong task ba vòng ở Hình 11-1, tới cuối hai vòng đầu đã trôi qua 20 giây, trong đó thời gian CPU tích lũy của công cụ chỉ là 2 giây. Nếu thư mục làm việc bị mất và mọi thứ phải thực thi lại từ đầu, sẽ tốn thêm 20 giây nữa, chứ không phải chỉ 2 giây tính toán của công cụ. Trạng thái nào có thể giữ lại quyết định những giai đoạn nào phải làm lại sau sự cố.
| Trạng thái | Thông tin phải ghi lại | Phương pháp phục hồi sau khi mất |
|---|---|---|
| Ngữ cảnh model và tiến trình sinh | Task, phiên bản model, tiền tố đầu vào, đầu ra đã chọn | Gửi lại ngữ cảnh, dựng lại trạng thái model |
| Thư mục làm việc và các tệp | Phiên bản kho lưu trữ, hàm băm tệp, phiên bản bản vá | Lấy từ bản sao bền vững hoặc áp lại bản vá |
| Tiến trình và bộ nhớ | Thể hiện môi trường, trạng thái tiến trình, điều kiện runtime | Khôi phục từ snapshot hoặc thực thi lại công cụ |
| Kết quả công cụ | Thao tác công cụ, lần thử thực thi, phiên bản tệp đầu vào | Truy vấn kết quả đã lưu hoặc thực thi lại |
| Thao tác ngoài | Mã định danh thao tác và trạng thái gửi trong hệ thống đích | Truy vấn, khử trùng lặp, hoặc bồi thường theo quy tắc nghiệp vụ |
Khi ghi lại các thông tin này, task, thao tác công cụ và từng lần thử thực thi đều cần mã định danh riêng. Cùng một kết quả kiểm thử có thể được truyền đi hai lần; cùng một bài kiểm thử cũng có thể thực sự được thực thi hai lần. Trường hợp trước chỉ cần khử trùng lặp thông điệp, nhưng trường hợp sau đã tiêu thụ tài nguyên hai lần. Nếu phiên bản tệp khác nhau, hai bài kiểm thử cùng tên thậm chí không phải cùng một thao tác công cụ.
Sau khi ghi lại từng lần thử, ta cũng cần phân biệt vì sao lần thử đó thất bại. Kết quả kiểm thử quyết định bước tiếp theo của controller. Nếu đầu ra của chương trình sai, controller cần sửa chương trình; nếu tiến trình công cụ ngừng do thiếu tài nguyên, cần phục hồi việc thực thi. Hai kiểu lỗi này đòi hỏi công việc tiếp theo khác nhau, và xác suất hoàn thành của chúng cũng khác nhau. Sự phân biệt tương tự xuất hiện trong huấn luyện model. RL cập nhật model dựa trên kết quả xác minh của một mẫu, và việc xác minh đó cũng phải phân biệt hai trường hợp: câu trả lời đúng hay sai, dùng để tính phản hồi học tập; còn các lỗi thực thi được xử lý trước tiên bởi hệ thống thực thi.
Lỗi và thử lại cũng mang theo chi phí bổ sung. Một lần gửi có thể kích hoạt nhiều lần thử. Nền tảng trả chi phí model, công cụ và môi trường cho mọi lần thử, nhưng người dùng chỉ nhận được task cuối cùng đã hoàn thành. Mục 11.5 tích lũy chi tiêu dọc theo các nhánh này, rồi chia cho số task vượt qua kiểm thử.
11.2 Tạo, giữ và giải phóng môi trường thực thi
11.2.1 Đường thực thi công cụ và ranh giới cô lập
Mục 11.1.3 đã phân biệt các tệp, tiến trình và kết quả thao tác cần giữ lại; phần này giải thích cách tạo và giải phóng các môi trường chứa trạng thái này. Các lời gọi công cụ do model sinh ra cần được thực thi bởi các chương trình thông thường. Executor chuyển các lời gọi thành thao tác tệp, khởi chạy tiến trình, hành động trình duyệt hoặc tác vụ thiết bị. Môi trường thực thi cung cấp giao diện hệ điều hành, hệ thống tệp, bộ nhớ, mạng và giới hạn tài nguyên mà việc thực thi mã cần. Môi trường thực thi cũng cần cô lập các task khác nhau để ngăn chúng can thiệp lẫn nhau.
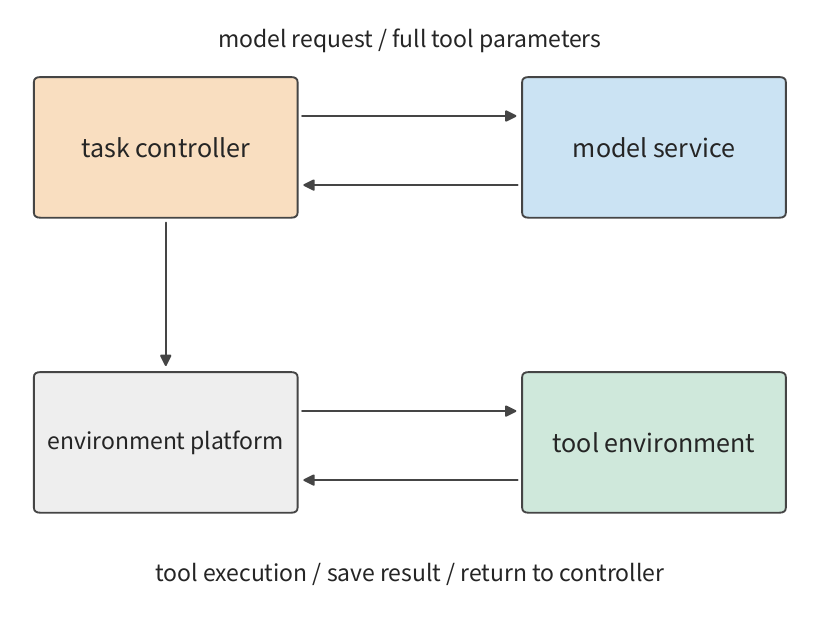
Hình 11-5 chia nền tảng ở đầu chương thành hai đường: dịch vụ model và môi trường công cụ. Dịch vụ model gồm 10 replica V4-Flash, xử lý tới 320 lần gọi đồng thời; nền tảng môi trường cấp phát tài nguyên công cụ trong 48 nhân CPU và khoảng 358 GiB bộ nhớ của một máy m5d.metal. Controller điều phối hai bên để hoàn thành task: trước tiên lấy tham số từ model, sau đó để công cụ thực thi và trả về kết quả.
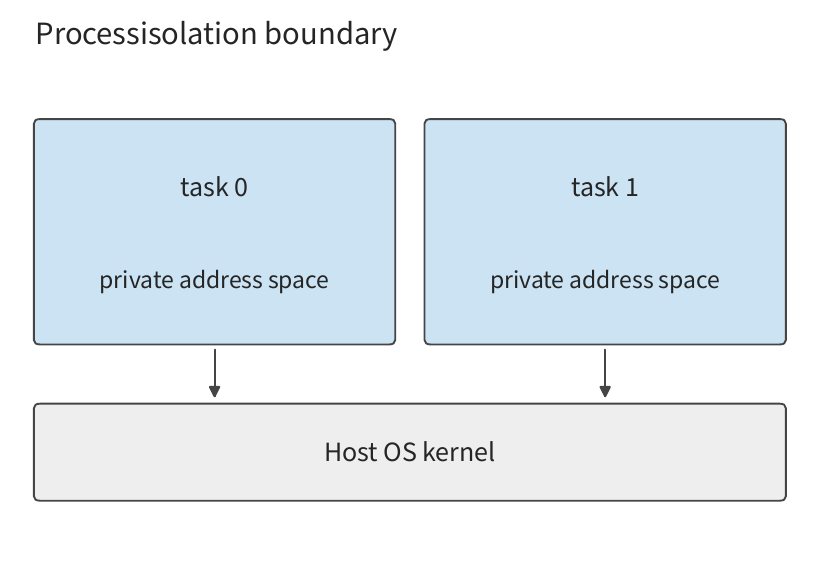
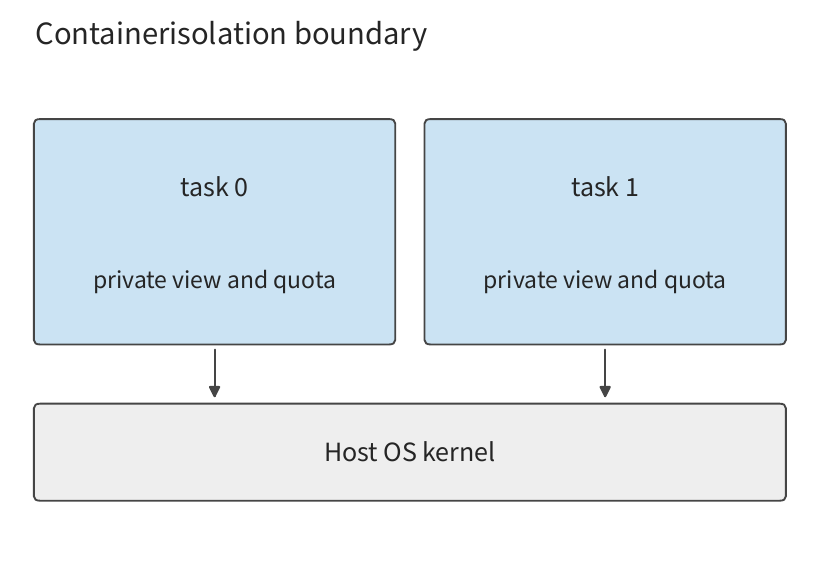
Cô lập các task khác nhau có nhiều cách triển khai, với mức độ cô lập tăng dần. Các tiến trình thường chia sẻ cùng một nhân hệ điều hành, dựa vào không gian địa chỉ và quyền hạn để cô lập cơ bản. Container thêm các namespace (cho tiến trình một góc nhìn riêng về các tài nguyên như mã định danh tiến trình và mạng), góc nhìn hệ thống tệp và các bộ kiểm soát tài nguyên, nhưng thường vẫn chia sẻ nhân của máy chủ. Một máy ảo hoàn chỉnh chạy nhân hệ điều hành riêng và được cô lập khỏi máy chủ qua phần cứng ảo; microVM giữ mô hình cô lập của máy ảo trong khi giảm chi phí qua các thiết bị ảo và chức năng quản lý tinh gọn. Sandbox là một mô tả các ràng buộc thực thi, chứ không phải một cách triển khai cụ thể.
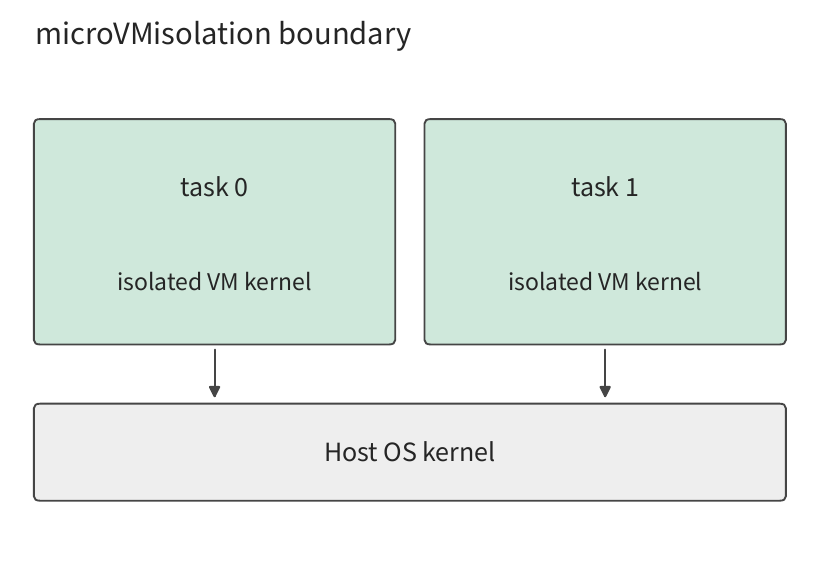
Lựa chọn của nền tảng ở đầu chương chính xác là sơ đồ microVM. Firecracker được Amazon Web Services (AWS) phát triển cho điện toán serverless và mở mã nguồn vào năm 2018; bài báo NSDI 2020 của đội Firecracker đã thảo luận cách cân bằng giữa cô lập ảo hóa phần cứng, tốc độ khởi động và chi phí bộ nhớ trên một số lượng lớn các task ngắn hạn. E2B dùng microVM Firecracker để chạy các môi trường công cụ, với template có thể dựng từ image container. Khi tạo, nền tảng xây dựng môi trường từ template; lúc chạy, công cụ đọc ghi tệp và khởi chạy tiến trình qua nhân máy ảo. Image container quyết định những tệp và phụ thuộc nào nằm trong môi trường, còn microVM quyết định cách các chương trình này được cô lập khỏi hệ thống máy chủ lúc chạy.
Hai đường hội tụ tại cùng một controller task: controller biết khi nào lời gọi model bắt đầu, khi nào công cụ dùng môi trường, và những tệp nào cần được lưu giữ qua các vòng. Dựa trên điều này, nền tảng có thể lập lịch riêng việc giữ và giải phóng trạng thái model và trạng thái công cụ: môi trường của vòng sau có thể được chuẩn bị trong lúc model đang tính toán, và các tệp có thể được lưu, các tiến trình được giải phóng ngay khi công cụ kết thúc.
11.2.2 Cấp phát tài nguyên và tạo môi trường
Sau khi chốt cách cô lập, nền tảng vẫn cần cấp phát tài nguyên cho môi trường và nạp dữ liệu mà chương trình cần. Nền tảng công cụ cấp phát tài nguyên qua hạn mức CPU, giới hạn bộ nhớ và quyền truy cập tệp, thiết bị. Tăng hạn mức CPU cho một môi trường đang chờ model không làm thay đổi trạng thái tệp và bộ nhớ của nó; hủy môi trường đó giải phóng bộ nhớ, nhưng nội dung này phải được dựng lại trước lần thực thi kế tiếp. Một số công cụ cũng cần GPU — ví dụ khi xác minh chương trình CUDA, phải xin GPU từ bể tài nguyên tăng tốc. Truyền thiết bị (device passthrough) cho phép máy ảo vận hành trực tiếp thiết bị vật lý được gán cho nó, và có thể thực hiện bằng chương trình máy ảo QEMU kết hợp giao diện truy cập thiết bị VFIO của Linux.
Tạo một môi trường đòi hỏi lấy template, thiết lập trạng thái riêng và chuẩn bị dữ liệu cho phần việc đầu tiên. Cách đơn giản nhất là sao chép toàn bộ template; một cách khác là chia sẻ nội dung chỉ đọc và chỉ sao chép các trang cần ghi; dữ liệu cũng có thể được nạp theo nhu cầu truy cập. Nạp ít dữ liệu hơn khi tạo môi trường rút ngắn thời gian khởi động, nhưng chương trình vẫn phải chờ nạp khi lần đầu truy cập dữ liệu đó.
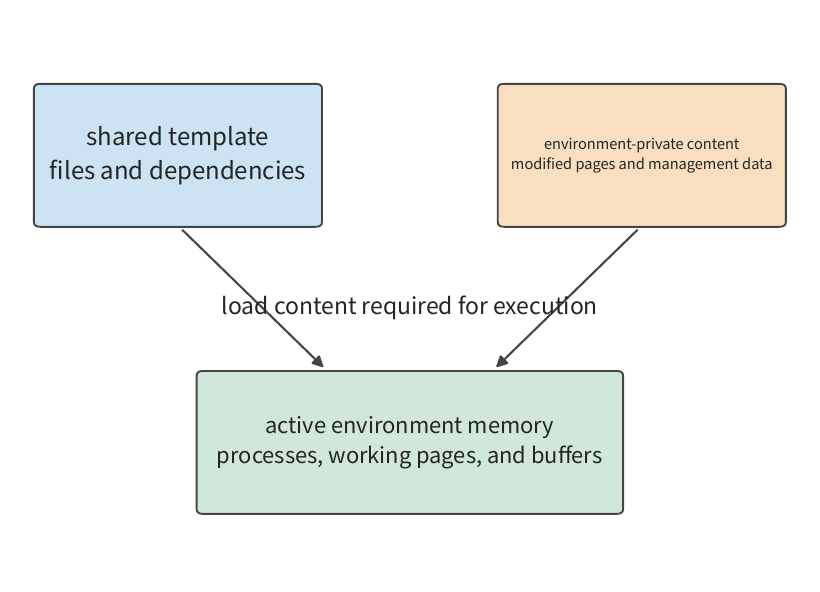
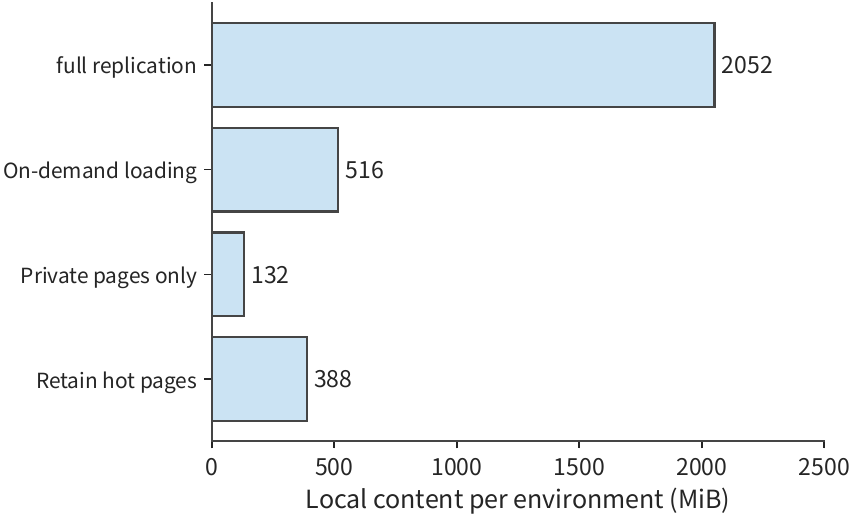
Ví dụ 11-2: Nạp theo nhu cầu và chia sẻ chỉ đọc có thể tiết kiệm bao nhiêu bộ nhớ môi trường? Để phân tích chi phí tạo, trước tiên lấy 100 trong số 300 môi trường ở đầu chương và so sánh bộ nhớ cần để nạp nội dung template vào 100 môi trường này. Mỗi template là 2 GiB, trong đó công cụ truy cập 512 MiB, sửa đổi 128 MiB, cộng thêm 4 MiB chi phí quản lý riêng. Sao chép từng cái toàn bộ cần 2.052 MiB bộ nhớ cục bộ mỗi môi trường, khoảng 200 GiB cho 100 cái; chỉ nạp nội dung được truy cập cần 516 MiB mỗi môi trường, tổng cộng khoảng 50 GiB. Lượng dữ liệu phải nạp vào bộ nhớ cho cùng một tập thao tác công cụ vì thế giảm khoảng 150 GiB.
Ta cũng có thể để các môi trường chia sẻ nội dung chỉ đọc, chỉ giữ lại 128 MiB trang bẩn (các trang bộ nhớ được sửa đổi so với template) cộng 4 MiB chi phí quản lý. Như vậy mỗi môi trường là 132 MiB, khoảng 13 GiB cho 100 cái. Các trang chỉ đọc chưa nạp vào bộ nhớ cục bộ sẽ được kéo về khi truy cập. Nếu mỗi môi trường giữ thêm 256 MiB trang chỉ đọc nóng, tổng cục bộ tăng trở lại khoảng 38 GiB, đổi lại là giảm số lần truy cập từ xa.
Bốn cách nạp lần lượt chiếm khoảng 200, 50, 13 và 38 GiB, cộng thêm một template dùng chung 2 GiB được giữ riêng. 2 GiB bộ nhớ cấp cho mỗi môi trường đang hoạt động ở đầu chương cũng bao gồm không gian tiến trình và bộ đệm mà công cụ cần lúc chạy. Chia sẻ nội dung chỉ đọc giảm lưu trữ trùng lặp, còn giữ dữ liệu được dùng thường xuyên ở cục bộ giảm việc đọc từ xa. Giữ lại bao nhiêu phụ thuộc vào những trang nào công cụ truy cập trước tiên và nó truy cập lại chúng sớm đến đâu.
Hình 11-10 phân tích từng loại nội dung mỗi môi trường lưu cục bộ. Việc lưu ít dữ liệu hơn có khiến công cụ chờ lâu hơn khi đọc lần đầu hay không vẫn cần được tính toán.
Giả sử cả việc kéo về lẫn việc nạp đều bị giới hạn bởi cùng một đường liên kết 25 GbE, với tốc độ 3,125 GB/s (khoảng 2,91 GiB/s). Khi template chưa được lưu trong bộ nhớ cục bộ, việc kéo 2 GiB rồi nạp 0,5 GiB dữ liệu vào bộ nhớ cùng nhau mất ít nhất 0,86 giây; khi template đã được lưu, chỉ cần nạp 0,5 GiB, giảm xuống 0,17 giây. Khoảng chênh 0,69 giây đến từ việc truyền template được bỏ qua. Nói chung, cận dưới của thời gian đường liên kết này cần để kéo và nạp dữ liệu là , trong đó và lần lượt là khối lượng dữ liệu được kéo về và được nạp, còn là băng thông đường liên kết.
Nếu lần thực thi đầu tiên của công cụ còn truy cập 1 GiB trang chưa được nạp vào bộ nhớ, đường liên kết này làm việc thêm khoảng 0,34 giây nữa. Nạp theo nhu cầu cho phép giao diện tạo trả về sớm hơn, dữ liệu chưa được truy cập chỉ được kéo về khi thực sự cần. Việc đọc trang và tệp của E2B được tổ chức đúng theo cách này: quá trình khởi động trước tiên đưa ra một môi trường có thể chạy, các lần truy cập sau lấp dần nội dung. Thời gian hoàn thành lần thực thi công cụ đầu tiên gồm khởi động môi trường cộng thời gian chờ khi lần đầu truy cập các trang bị thiếu. Nạp theo nhu cầu hoãn một phần công việc chuẩn bị sang giai đoạn thực thi công cụ.
11.2.3 Tạm dừng, tiếp tục và dựng lại môi trường
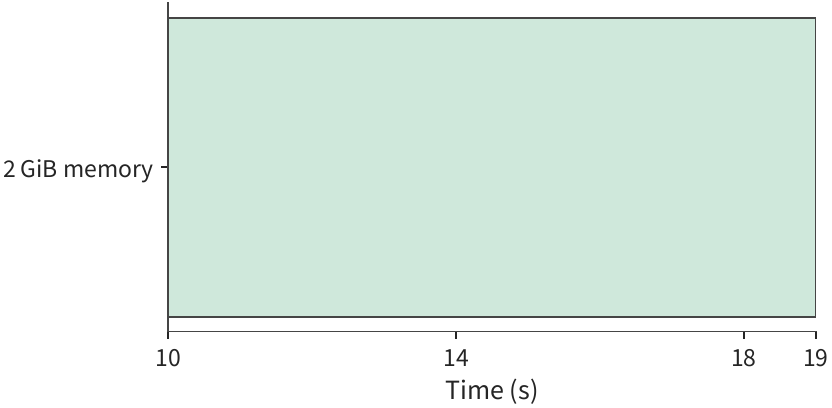
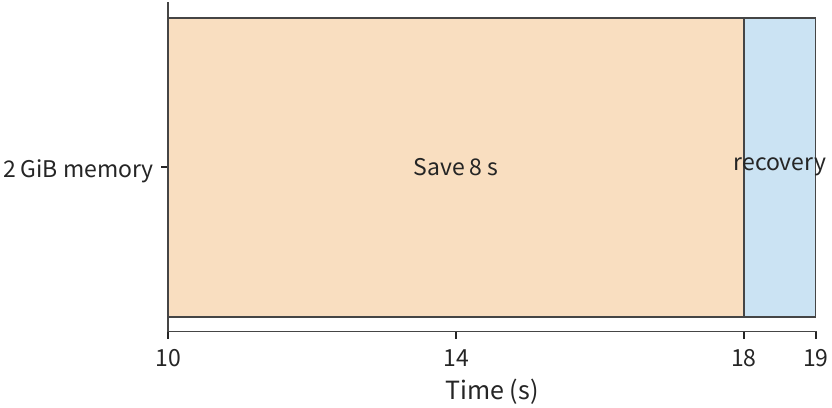
Mục 11.2.2 đã giảm dữ liệu sao chép ở mỗi lần tạo; một cách tiết kiệm bộ nhớ khác là tạm thời giải phóng toàn bộ môi trường giữa hai lần thực thi công cụ. Trong task ba vòng ở đầu chương, công cụ của vòng 1 kết thúc ở giây 10, nhưng công cụ vòng 2 không bắt đầu cho tới giây 19, với một lời gọi model 9 giây ở giữa. Giữ nó luôn thường trú chiếm GiB-giây. Theo tài liệu của E2B, tạm dừng một sandbox mất khoảng 4 giây mỗi GiB bộ nhớ, tiếp tục mất khoảng 1 giây, và môi trường vẫn chiếm 2 GiB trong lúc lưu và tiếp tục. Tạm dừng một môi trường 2 GiB mất 8 giây: trạng thái được lưu từ giây 10 tới giây 18, và được tiếp tục từ giây 18 tới giây 19. Công cụ tiếp theo vẫn có thể bắt đầu ở giây 19, nhưng toàn bộ khoảng thời gian bị lấp đầy bởi việc lưu và tiếp tục, và mức chiếm dụng vẫn là 18 GiB-giây — chẳng tiết kiệm gì cả.
Các vùng chiếm dụng trong Hình 11-11 và 11-12 là như nhau. Để giải phóng bộ nhớ trong lúc chờ, trước tiên ta phải lưu bất cứ trạng thái nào vẫn cần cho vòng kế tiếp, và thời gian lưu tăng theo dung lượng bộ nhớ; vậy tạm dừng tiết kiệm được bao nhiêu phụ thuộc vào cái gì cần lưu và được tiếp tục theo cách nào.
Có nhiều hơn một cách để tiếp tục trạng thái đã lưu. Tiếp tục sau khi tạm dừng nối tiếp việc thực thi của cùng một task; dẫn xuất từ một snapshot tạo ra nhiều nhánh từ cùng một trạng thái; tái tạo từ một môi trường ban đầu không kế thừa bất kỳ sửa đổi nào của task trước. Cả ba đều cho lại một môi trường có thể chạy, nhưng chúng kế thừa trạng thái khác nhau.
Một agent tiếp tục từ một snapshot đang chạy kế thừa các tệp và tiến trình đã được sửa đổi trước đó. Xác minh RL thường yêu cầu mỗi mẫu bắt đầu từ cùng một thư mục ban đầu, nên nó dẫn xuất từ một template sạch thay vì thế. Nếu các tệp của snapshot chứa đầu ra của bài kiểm thử trước, việc tiếp tục cũng mang theo đầu ra đó. Template ban đầu được dùng cho các lần thử lặp lại, còn snapshot đang chạy được dùng để tiếp tục tiến trình — hai cái bảo toàn trạng thái ở những thời điểm khác nhau.
Quay lại khoảng chờ model 9 giây trong task ở đầu chương. Tạm dừng chỉ bắt đầu có lợi khi môi trường nhỏ hơn hoặc khoảng thời gian dài hơn: với cùng khoảng 9 giây, một môi trường 512 MiB có thể được lưu trong khoảng 2 giây, giải phóng được 6 giây; nhưng nếu khoảng thời gian ngắn hơn tổng thời gian lưu và tiếp tục, thì việc tiếp tục sẽ thực sự làm trễ lần thực thi công cụ kế tiếp. E2B cũng cung cấp một tùy chọn tạm dừng chỉ lưu hệ thống tệp, khởi động lại hệ thống khi tiếp tục; việc dựng lại môi trường mỗi vòng trong Mục 11.2.4 đi đúng theo hướng này, chỉ giữ lại các tệp chứ không giữ bộ nhớ tiến trình.
Có nên tạm dừng hay không có thể quyết định bằng cách so sánh chi phí. Gọi là bộ nhớ được giải phóng tính bằng GiB, là số giây bộ nhớ nằm nhàn rỗi sau khi được giải phóng, là giá mỗi GiB-giây, và là chi phí bổ sung của việc lưu trạng thái, lưu trữ và tiếp tục; tạm dừng tiết kiệm chi phí khi . Vế trái tăng theo thời gian nhàn rỗi, còn vế phải là chi phí phải trả cho mỗi lần lưu-rồi-tiếp-tục; đặt hai vế bằng nhau sẽ cho thời gian nhàn rỗi mà từ đó việc tạm dừng bắt đầu tiết kiệm chi phí.
So sánh chi phí quyết định có tạm dừng hay không; một khi đã tạm dừng, các trạng thái khác nhau phải được tiếp tục theo những cách khác nhau. Một snapshot lưu tệp và bộ nhớ, các kết nối được thiết lập lại bởi client, và bộ lưu trữ ngoài tiếp tục giữ các bản ghi đã cam kết. Sau khi tiếp tục, controller trước tiên lấy kết quả thao tác, rồi chuyển sang vòng kế tiếp, tránh làm lại các sửa đổi đã hoàn thành.
11.2.4 Luôn thường trú, tạo theo nhu cầu và chuẩn bị trước
Tạm dừng đòi hỏi lưu trạng thái tiến trình. Nếu vòng kế tiếp chỉ cần các tệp và kết quả đã lưu, có thể bỏ hẳn snapshot tiến trình và dựng lại môi trường trực tiếp. Với task mã nguồn ở đầu chương, thư mục làm việc và kết quả đã được lưu bền vững, nên mỗi vòng dùng công cụ đều có thể khởi chạy một tiến trình mới. Bản thân template của E2B là những snapshot máy ảo đã được khởi động một lần; tài liệu nêu rằng việc khôi phục một sandbox mất khoảng 1 giây. Khi template đã được lưu trên máy cục bộ, khởi động một microVM từ template, rồi nạp thư mục làm việc và khởi tạo runtime công cụ, tổng thời gian chuẩn bị là 2 giây — gọi đây là đường nóng (warm path). Khi template không có ở cục bộ, trước tiên phải kéo một template 2 GiB qua 25 GbE, thêm khoảng 0,69 giây, khiến đường lạnh (cold path) tốn khoảng 2,7 giây. Phần còn lại của mục này giả định đường nóng. Mỗi lần chuẩn bị tiêu thụ tích lũy 0,1 giây thời gian CPU, và chiếm 2 GiB từ lúc bắt đầu chuẩn bị cho tới khi công cụ kết thúc. Chuẩn bị chỉ nạp runtime công cụ đã biết và thư mục làm việc; các sửa đổi tệp thực thi sau khi nhận được đầy đủ tham số lời gọi công cụ.
Vì biết lời gọi model đầu tiên trả về ở giây 9, nền tảng có thể bắt đầu chuẩn bị môi trường ở giây 7, thực thi công cụ ở giây 9, rồi lưu kết quả và hủy môi trường ở giây 10. Hai vòng tiếp theo bắt đầu chuẩn bị lần lượt ở giây 17 và giây 27. Cả ba lần chuẩn bị đều hoàn thành trong lúc gọi model, task vẫn kết thúc ở giây 30, và mỗi vòng chỉ cần giữ môi trường trong 3 giây chuẩn bị và thực thi.
Dấu chân bộ nhớ tích lũy mỗi task giảm từ 60 xuống GiB-giây, và dấu chân bộ nhớ trung bình của nền tảng giảm từ 600 xuống 180 GiB. Cái giá phải trả là tạo 30 môi trường mỗi giây; công việc chuẩn bị cộng thêm trung bình nhân CPU, nâng nhu cầu CPU từ 30 lên 33 nhân. Bài báo Firecracker cho biết một máy chủ đơn có thể tạo tới 150 microVM mỗi giây, nên 30 mỗi giây nằm thoải mái trong phạm vi đó. Bằng cách thêm một lượng nhỏ công việc tạo môi trường, nền tảng tiết kiệm được 420 GiB trạng thái mà nếu không thì phải giữ trong lúc chờ, hạ nhu cầu bộ nhớ từ 600 GiB — mức máy chủ này không thể chứa — xuống còn khoảng một nửa dung lượng đó.
Hình 11-13 và Hình 11-14 so sánh dòng thời gian task đầy đủ dưới hai cách quản lý môi trường, cho thấy mức sử dụng bộ nhớ thay đổi thế nào. Ba thời điểm thực thi công cụ không đổi; biến mất chính là dấu chân bộ nhớ trong khoảng chờ model dài. Thời điểm chuẩn bị có thể được lập lịch chính xác ở đây vì cả loại công cụ vòng sau sẽ dùng lẫn thời điểm model trả về đều được biết trước.
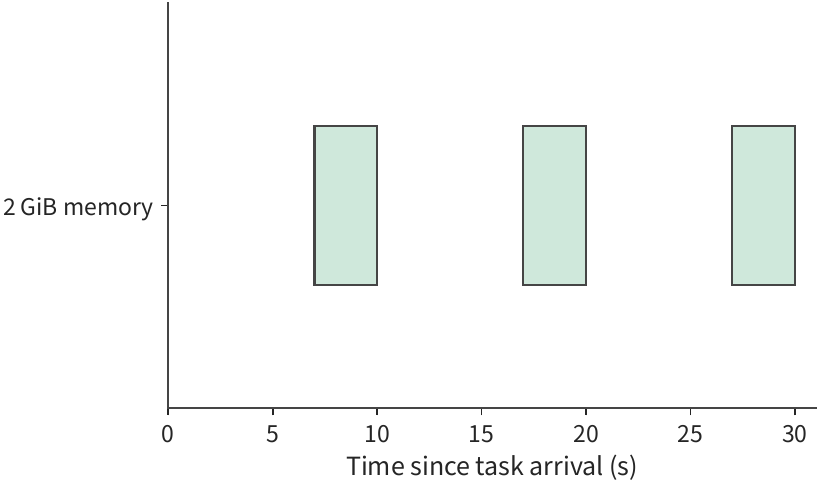
Sự sắp xếp này giả định việc chuẩn bị có thể hoàn thành trước khi thực thi công cụ bắt đầu. Nếu loại công cụ tiếp theo phải được dự đoán từ đầu ra streaming, thì thời gian người gọi phải chờ sau khi phát lời gọi phụ thuộc vào việc chuẩn bị đã bắt đầu sớm bao nhiêu và dự đoán có đúng hay không. SpecBox dùng loại công cụ lộ ra trong đầu ra streaming, kết hợp với bản ghi các lần chuyển công cụ, để chuẩn bị trước môi trường tương ứng; phân tích dưới đây xem xét lợi ích cho một lời gọi đơn lẻ.
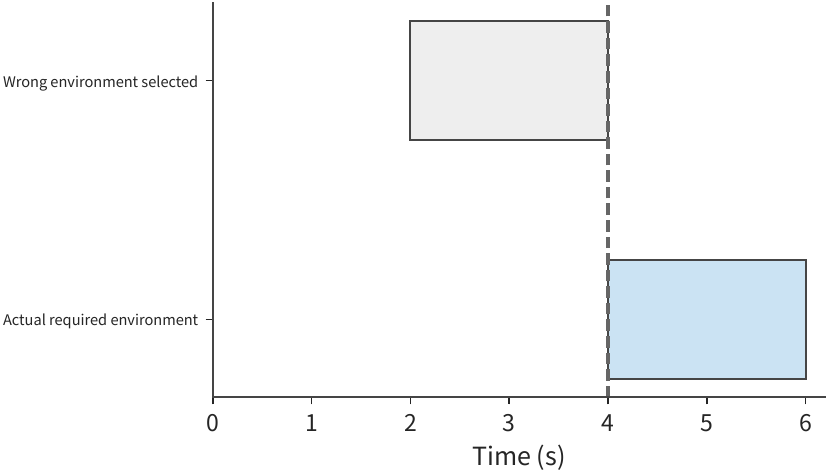
Giả sử một lần chuẩn bị mất giây, thời gian dẫn (lead time) là giây, và xác suất dự đoán đúng môi trường cần thiết là . Giả định các dự đoán đúng không tranh chấp tài nguyên, và các dự đoán sai có thể bị hủy ngay lập tức, sau đó môi trường đúng được chuẩn bị theo nhu cầu, thì thời gian chờ trung bình để môi trường sẵn sàng sau khi lời gọi được phát là
Khi dự đoán đúng, giây đầu tiên của việc chuẩn bị chồng lấp với lời gọi model, và lời gọi công cụ vẫn phải chờ phần chuẩn bị còn lại hoàn thành; khi dự đoán sai, môi trường thực sự cần được chuẩn bị từ đầu. Gán trọng số cho hai đường theo xác suất trúng sẽ ra biểu thức trên. Một khi việc chuẩn bị có thể hoàn thành trước khi model trả về, bắt đầu chuẩn bị sớm hơn nữa chỉ làm kéo dài thời gian môi trường đã sẵn sàng nằm nhàn rỗi chờ lời gọi.
Lấy giây và . Không chuẩn bị trước, mọi lời gọi chờ 2 giây. Với 1 giây thời gian dẫn, trung bình ba trong bốn lời gọi chỉ chờ 1 giây, còn một lời gọi — do dự đoán sai — vẫn chờ 2 giây, cho thời gian chờ trung bình 1,25 giây. Với 2 giây thời gian dẫn, nhánh đúng không còn chờ đợi gì, và trung bình giảm xuống 0,5 giây. Với 3 giây thời gian dẫn, trung bình vẫn là 0,5 giây, nhưng nhánh đúng giờ nằm sẵn sàng lâu hơn 1 giây. Với một môi trường 2 GiB, mỗi lần dự đoán vì vậy cộng thêm trung bình GiB-giây dấu chân bộ nhớ nhàn rỗi.
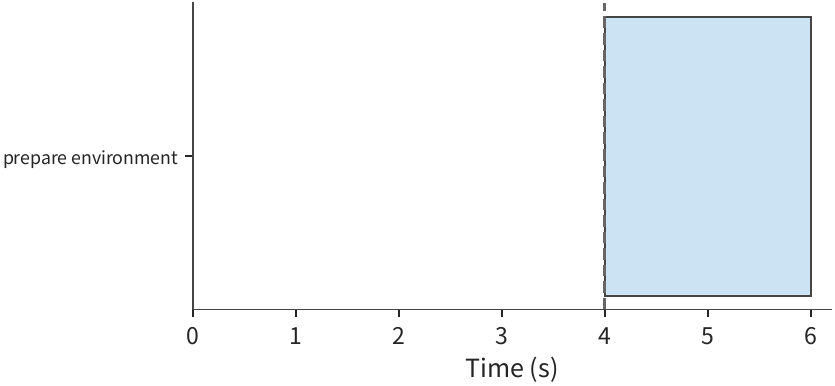
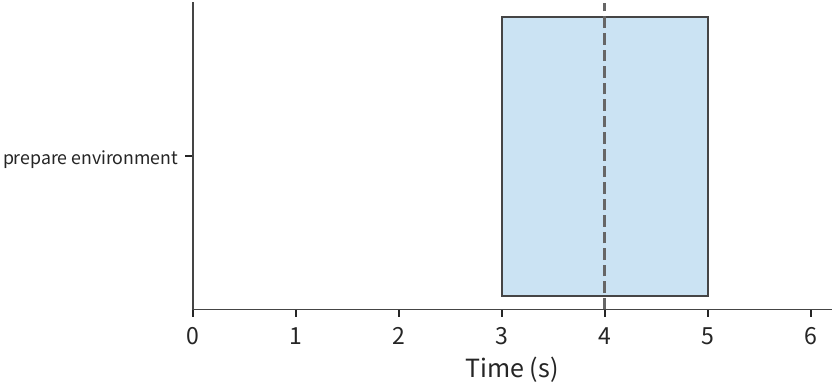
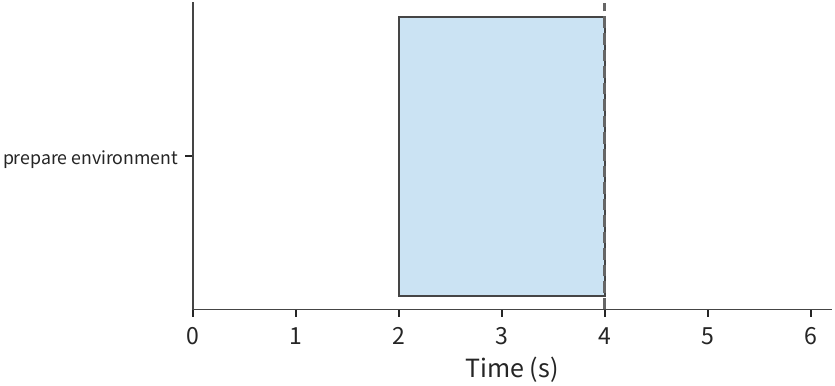
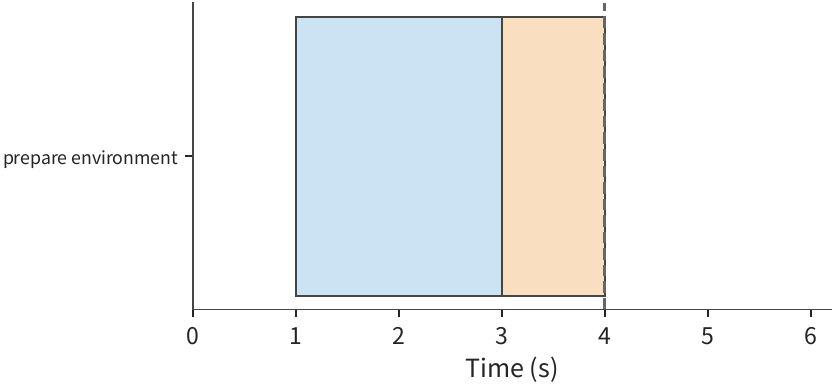
Điều này cho ta ba cách để so sánh việc giảm thời gian chờ. Lưu template trong bộ nhớ có thể loại bỏ chi phí kéo dữ liệu lặp đi lặp lại; giữ một môi trường đã khởi động luôn thường trú cho phép thực thi ngay khi lời gọi đến, nhưng đòi hỏi chiếm bộ nhớ liên tục; dựng lại môi trường mỗi vòng thay vào đó có thể tận dụng thời lượng của lời gọi model để hoàn thành việc chuẩn bị. Trong task ở đầu chương, runtime cần cho vòng kế tiếp đã được biết, nên môi trường của vòng sau được chuẩn bị trong lúc gọi model; khi nhiều công cụ xuất hiện xen kẽ, tỷ lệ trúng của dự đoán cũng phải được đưa vào tính toán.
Một lần phát lại các lời gọi công cụ cục bộ minh họa chi phí của việc chuẩn bị quá sớm: chuyển từ việc chuẩn bị với 50 ms thời gian dẫn sang việc chuẩn bị bắt đầu ngay từ đầu khoảng chờ model khiến thời gian tích lũy của các lời gọi công cụ gần như không đổi, khoảng 0,26–0,28 giây, nhưng dấu chân bộ nhớ tích lũy tính từ các kết quả được lấy mẫu tăng từ khoảng 0,0193 lên 0,467 GiB-giây — cao gấp khoảng 24 lần. Phần lớn dấu chân bộ nhớ thêm này diễn ra trong khoảng thời gian môi trường đã sẵn sàng nhưng lời gọi vẫn chưa đến. Chỉ cần môi trường có thể được chuẩn bị xong trước khi lời gọi công cụ đến, thì việc tạo nó sớm hơn chẳng mang lại lợi ích gì.
11.3 Cấp phát và lập lịch trong bể tài nguyên dùng chung
11.3.1 Tài nguyên không đồng nhất, cấp phát theo nhóm và ràng buộc vị trí
Sau khi tính xong nhu cầu tài nguyên của một task, người ta vẫn phải xác định liệu bể tài nguyên dùng chung có thể cung cấp đồng thời các tài nguyên này hay không. Một công việc nhiều thẻ thường đòi hỏi một loại thẻ cụ thể, bộ nhớ mỗi thẻ, CPU và bộ nhớ máy chủ tương ứng, cùng một vị trí phù hợp với mô hình giao tiếp của nó. Việc tổng số GPU nhàn rỗi đáp ứng nhu cầu chỉ là một điều kiện cần để công việc có thể khởi động.
Các tài nguyên này còn phải nằm trên những nút phù hợp: trong khi công cụ CPU ở đầu chương độc lập dùng từng nhân một, huấn luyện nhiều thẻ đòi hỏi một nhóm bộ tăng tốc phải tiến lên cùng nhau, để mọi tiến trình trong công việc có thể khởi động cùng lúc. Việc một công việc nhiều thẻ có thể khởi động hay không vì vậy cũng phụ thuộc vào các tài nguyên nhàn rỗi đang phân bố trên những nút nào.
Ví dụ 11-3: Các ràng buộc về GPU, CPU và nút tạo ra sự phân mảnh tài nguyên như thế nào? Một công việc cần bốn H100 và 16 nhân CPU, và yêu cầu các tài nguyên này nằm trên cùng một nút. Nút 1 là DGX H100 (8 thẻ H100 SXM, hai Xeon Platinum 8480C với tổng cộng 112 nhân), đang chạy một công việc chiếm bốn H100 và 104 nhân, để lại bốn H100 và 8 nhân nhàn rỗi; Nút 2 là DGX A100 (8 thẻ A100, hai EPYC 7742 với tổng cộng 128 nhân), với bốn A100 và 32 nhân nhàn rỗi. Toàn bể có bốn H100 nhàn rỗi và đủ nhân CPU, nhưng không một nút nào thỏa mãn mọi điều kiện.
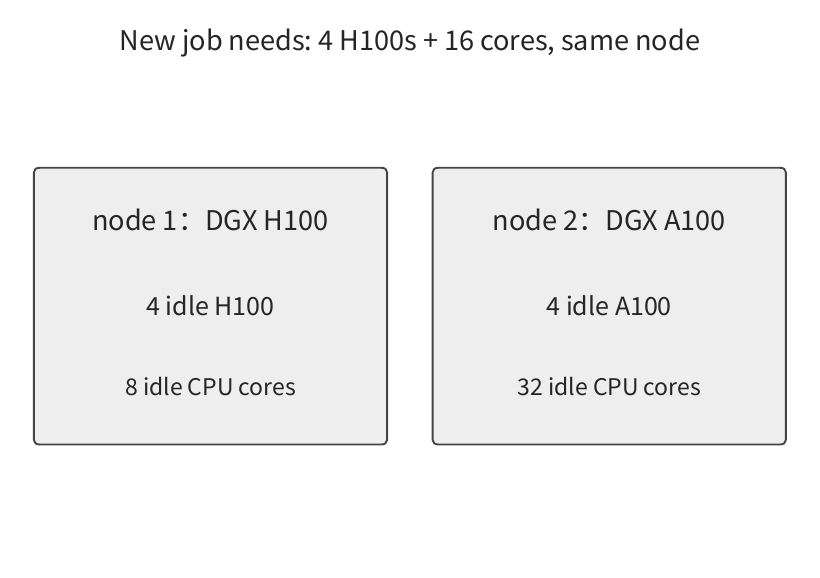
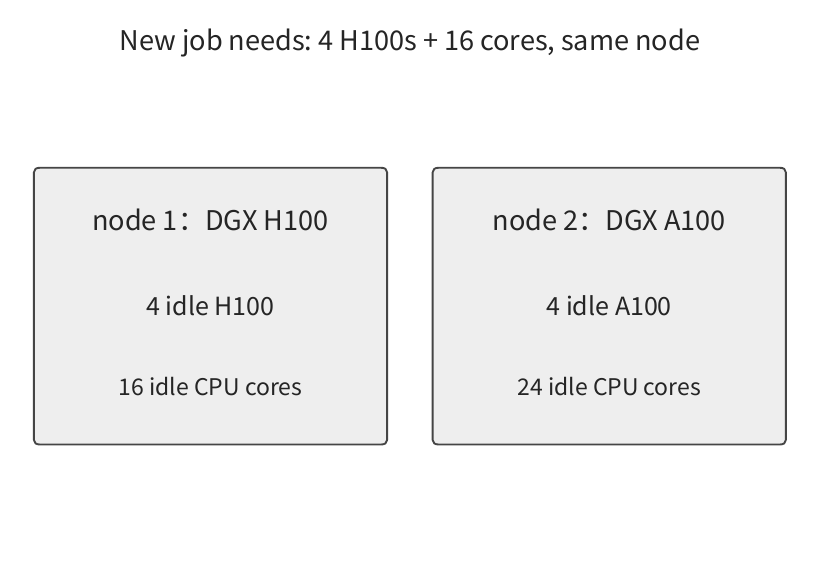
Giả sử chờ task ban đầu của Nút 1 kết thúc mất 12 giây, di chuyển task đó mất 4 giây, và thực thi cục bộ công việc mới mất 20 giây. Chờ rồi thực thi mất tổng cộng 32 giây; di chuyển rồi thực thi mất tổng cộng 24 giây — bằng cách sắp xếp lại tài nguyên, công việc mới hoàn thành sớm hơn 8 giây. Nếu một cấu hình đa nút tương thích khác cần 1 giây chuẩn bị và 32 giây thực thi, thì khởi động nó ngay theo kiểu phân tán mất tổng cộng 33 giây — thực ra muộn hơn. Thời gian hoàn thành của ba sơ đồ lần lượt là
Trong ví dụ này, sơ đồ di chuyển hoàn thành sớm hơn phương án chờ 8 giây và sớm hơn khởi động phân tán 9 giây. Khi trạng thái cần di chuyển lớn lên, thời gian di chuyển cũng tăng; một khi đạt 12 giây, sơ đồ di chuyển và sơ đồ chờ đều mất 32 giây. Bộ lập lịch vì vậy có thể so sánh trực tiếp thời gian di chuyển dự đoán với thời gian còn lại của task gốc, và chọn sơ đồ nào tập hợp được sớm hơn toàn bộ tài nguyên cần thiết.
Sự phân mảnh tài nguyên cũng xảy ra trong các cluster sản xuất. Một nghiên cứu năm 2026 của các nhà nghiên cứu tại Đại học Khoa học và Công nghệ Hồng Kông, Alibaba và các tổ chức khác đã phân tích các cluster GPU sản xuất trên Hạ tầng Serverless (ASI) của Alibaba. Nghiên cứu cho thấy CPU khớp không đủ, các công việc yêu cầu khởi động theo nhóm và ràng buộc vị trí mạng đều có thể khiến các GPU nhàn rỗi trở nên không dùng được. Sau khi thêm các công việc ưu tiên thấp có thể chiếm trước, tỷ lệ cấp phát GPU trong nghiên cứu tăng từ 68% lên 93%. Các công việc ưu tiên thấp này dùng các bộ tăng tốc mà các công việc ưu tiên cao chưa dùng ngay; khi một công việc yêu cầu khởi động theo nhóm đến, bộ lập lịch thu hồi các bộ tăng tốc này và tập hợp tài nguyên cần thiết bằng cách di chuyển các task.
11.3.2 Hàng đợi, ưu tiên và chi phí chiếm trước
Ngay cả khi cấu hình nút phù hợp, các yêu cầu đến đồng thời vẫn có thể vượt quá tốc độ quay vòng tài nguyên. Trong task ở đầu chương, các yêu cầu đến đều đặn, cần 30 lần gọi công cụ mỗi giây, mà 48 nhân CPU xử lý thừa sức. Khi các lời gọi đến theo đợt bùng nổ, thời gian xếp hàng có thể khác nhau dù tổng khối lượng công việc không đổi.
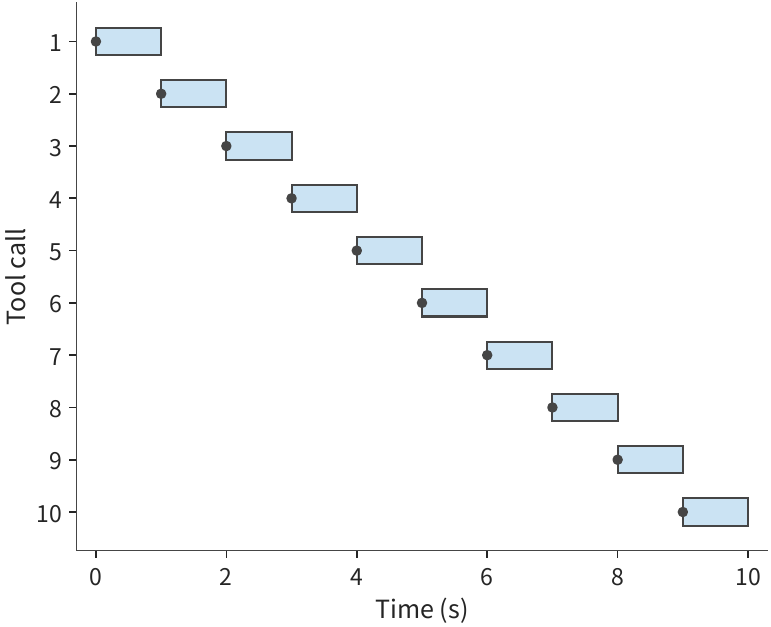
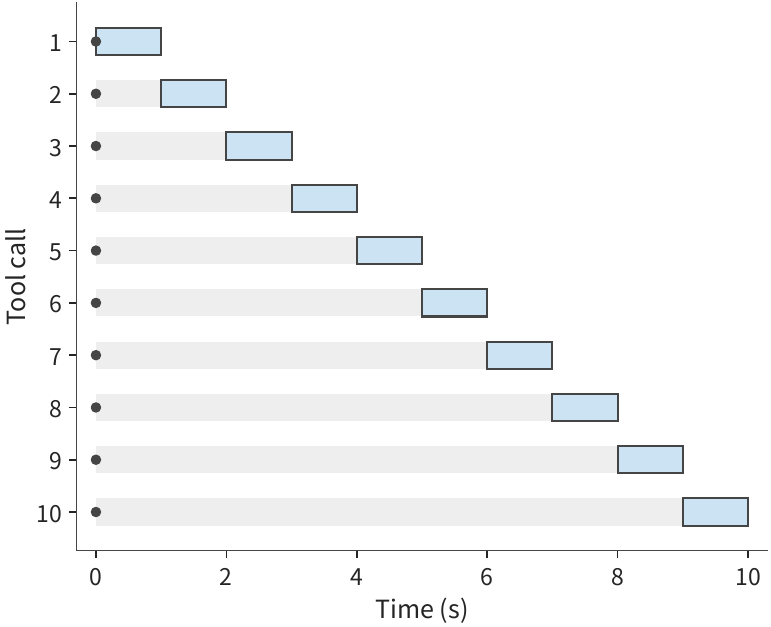
Trước tiên xét một tiến trình thực thi đơn lẻ, trong đó mỗi đơn vị công việc công cụ mất 1 giây. Nếu mười đơn vị công việc lần lượt đến ở các giây 0, 1, …, 9, mỗi đơn vị có thể thực thi ngay khi đến, và thời gian xếp hàng bằng không trong suốt quá trình. Nếu cả mười đơn vị đến ở giây 0, việc thực thi vẫn mất 10 giây, nhưng thời gian xếp hàng của từng mục lần lượt là 0, 1, …, 9 giây, trung bình 4,5 giây. Tổng khối lượng công việc quyết định tiến trình thực thi phải làm việc trong bao lâu; thời điểm đến và thứ tự thực thi quyết định mỗi task phải chờ bao lâu trước đó.
Hình 11-22 và Hình 11-23 so sánh hai kiểu đến này, với hình sau dùng các thanh xám phía trước các khối thực thi để thể hiện thời gian chờ. Cùng 10 giây công việc thực thi có thể tạo ra hoặc không chút xếp hàng nào hoặc sự chờ đợi đáng kể. Việc ngoại suy từ nhu cầu tài nguyên trung bình ra thời gian phản hồi thực tế vì vậy cũng đòi hỏi biết các yêu cầu có tập trung về mặt thời gian hay không.
Lấy đợt bùng nổ các lời gọi công cụ của nền tảng sửa mã nguồn làm ví dụ. Giả sử cả 48 nhân của nền tảng đều nhàn rỗi khi 80 lời gọi công cụ, mỗi lời gọi cần 1 giây, đến đồng thời; 48 lời gọi đầu thực thi ngay, 32 còn lại chờ 1 giây; thời gian chờ trung bình là 0,4 giây, và tất cả hoàn thành trong 2 giây. Mở rộng lên hai máy m5d.metal (96 nhân), đợt bùng nổ này hoàn thành trong 1 giây. Thêm nhân CPU nâng dung lượng xử lý các yêu cầu bùng nổ; khi task đến đều đặn, vẫn chỉ cần 30 nhân CPU để thực thi các công cụ.
Cùng đợt lời gọi công cụ đó cũng cần đủ bộ nhớ môi trường. Mỗi môi trường chiếm 2 GiB, nên 80 môi trường đã chuẩn bị cần 160 GiB. Sơ đồ luôn thường trú cần khoảng 600 GiB, bản thân con số này đã vượt 358 GiB bộ nhớ khả dụng; sơ đồ dựng lại mỗi vòng ở Mục 11.2 chỉ chiếm trung bình 180 GiB, để lại khoảng 178 GiB — đủ để chứa 80 môi trường này. Giảm các môi trường được giữ trong lúc chờ giải phóng bộ nhớ cho các lời gọi mới, để CPU nhàn rỗi bắt đầu thực thi kịp thời.
Sau khi dành dung lượng cho các yêu cầu bùng nổ, người ta cũng phải quyết định thứ tự giữa các yêu cầu. Ưu tiên quyết định ai dùng phần dôi ra này trước. Các task trực tuyến cần khởi động nhanh, còn các task ngoại tuyến có thể chờ, nên nền tảng có thể để công việc ngoại tuyến tạm mượn tài nguyên và thu hồi lại khi một lời gọi trực tuyến đến. Giả sử một task trực tuyến phải chờ tối đa 2 giây, trong khi một công việc ngoại tuyến cần 30 giây để lưu trạng thái. Nhóm tài nguyên này, dù có thể bị chiếm trước, cũng không thể được trao lại cho tới khi 30 giây trôi qua; nền tảng vì vậy cần dành riêng các tài nguyên có thể cấp cho task trực tuyến trong 2 giây.
Một lần chiếm trước cũng làm mất tiến trình chưa lưu. Với một công việc đã chạy 20 giây và có thời gian phục hồi 2 giây, sự khác biệt giữa việc tiếp tục từ checkpoint gần nhất và làm lại từ đầu phụ thuộc vào khối lượng công việc tích lũy kể từ checkpoint đó. Bộ lập lịch phải cân nhắc cả việc task mới có thể bắt đầu sớm hơn bao nhiêu lẫn chi phí lưu và khôi phục trạng thái, cùng với độ trễ thêm gây ra cho công việc ban đầu.
Chiếm trước minh họa chi phí của việc đưa một task lên trước một task khác. Về dài hạn, người ta cũng phải tránh trì hoãn vĩnh viễn cùng một đợt task, và vì vậy phải quyết định tính công bằng cấp phát được đo theo chuẩn nào. Hai task mỗi task nhận hai GPU có thể trông giống một phần chia đều; nếu một loại thẻ mất gấp đôi thời gian của loại khác để làm cùng một công việc, mức tiến triển thực tế của chúng khác nhau. Công bằng tài nguyên trội (dominant resource fairness, DRF) chỉ định, với mỗi task, loại tài nguyên mà nó tiêu thụ phần lớn nhất làm tài nguyên trội của nó, và cấp phát tài nguyên công bằng theo các phần tài nguyên trội; các nghiên cứu như Gavel và Pollux tiến xa hơn, tính đến sự khác biệt về khả năng xử lý của bộ tăng tốc hay tiến độ huấn luyện. Cấp phát theo phần tài nguyên tập trung vào mỗi task nhận được bao nhiêu tài nguyên; cấp phát theo tiến độ tập trung vào mỗi task tiến lên nhanh đến đâu; còn giới hạn thời gian chờ tối đa nhằm ngăn một số task bị bỏ đói thực thi vĩnh viễn.
Mở rộng từ một lời gọi công cụ đơn lẻ lên huấn luyện RL, nhu cầu tài nguyên cũng thay đổi theo từng giai đoạn. Các quỹ đạo tương tác do rollout tạo ra gồm cả đầu ra model lẫn phản hồi từ công cụ hoặc môi trường. Phần sau tính toán xem việc thêm bộ tăng tốc để sinh các quỹ đạo như vậy thực sự tiết kiệm bao nhiêu thời gian huấn luyện.
11.3.3 Tỷ lệ tài nguyên động giữa giai đoạn sinh và huấn luyện của RL
Một vòng lặp RL đồng bộ đơn lẻ đòi hỏi sinh mẫu, hoàn tất xác minh và thực hiện cập nhật. Nếu khối lượng sinh hiệu quả cần mỗi vòng là và tốc độ của bể sinh là , thời gian giai đoạn sinh rút gọn là . Thêm bộ tăng tốc rollout chỉ có thể rút ngắn phần sinh song song được; mỗi vòng vẫn cần hoàn tất xác minh, cập nhật, công bố trọng số và mọi đồng bộ cần thiết. Nếu các giai đoạn này thực thi tuần tự, thì
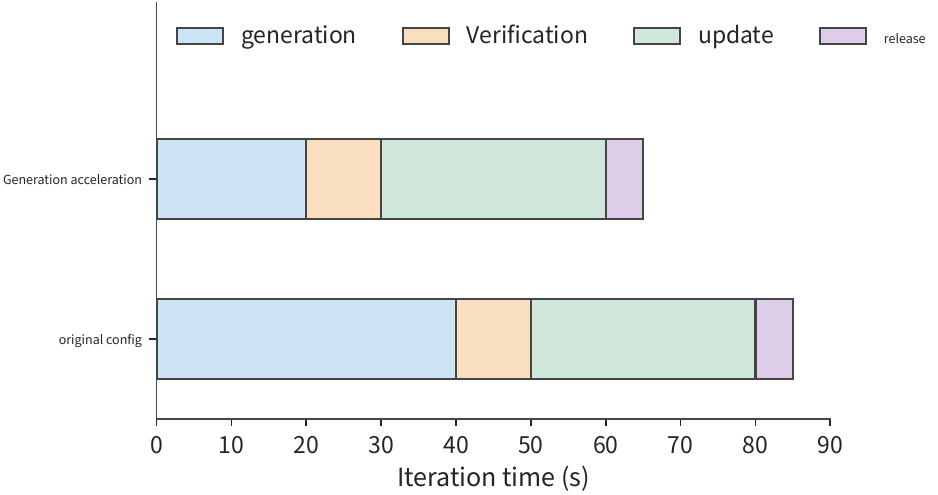
Ví dụ, nếu sinh, xác minh, cập nhật và công bố lần lượt mất 40, 10, 30 và 5 giây, một vòng mất tổng cộng 85 giây. Chỉ nhân đôi tốc độ sinh đưa một vòng xuống 65 giây — mức tăng tốc tổng thể chỉ khoảng 1,3×; ngay cả khi thời gian sinh giảm về không, các giai đoạn còn lại vẫn mất 45 giây, nên mức tăng tốc tổng thể không thể vượt quá khoảng 1,9×. Khi thời gian sinh co lại, xác minh và cập nhật chiếm phần ngày càng lớn trong tổng thời gian, và thời gian tiết kiệm được bằng cách thêm các bộ tăng tốc sinh tiếp theo liên tục giảm xuống.
Trong Hình 11-24, thêm bộ tăng tốc sinh chỉ rút ngắn phần màu xanh. Có hai hướng tiến tiếp: thay đổi thứ tự thực thi để xác minh chồng lấp với sinh; hoặc tiếp tục thêm bộ tăng tốc sinh, nhưng trước tiên tính chi phí chuẩn bị phải trả trước khi các bộ tăng tốc mới tham gia.
Cách tiếp cận cho xác minh chồng lấp với sinh được trình bày ở Mục 11.3.4. Khi thêm các bộ tăng tốc sinh tạm thời, RLBoost giữ nhóm huấn luyện không đổi và cho các thể hiện tạm thời tham gia bể sinh một khi việc chuẩn bị trọng số của chúng hoàn tất.
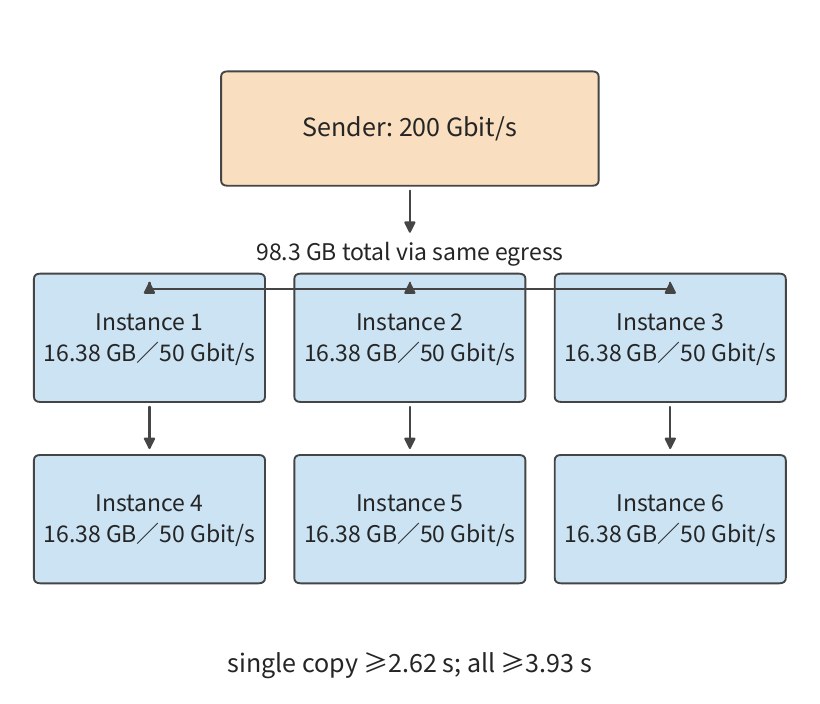
Ví dụ 11-4: Một đường liên kết cổng ra dùng chung giới hạn tốc độ phân phối trọng số tới nhiều thể hiện như thế nào? Trọng số BF16 đầy đủ của Qwen3-8B tổng cộng là 16.381.470.720 byte, khoảng 16,38 GB (thập phân), cần được gửi riêng tới sáu thể hiện rollout. Theo cấu hình thí nghiệm của RLBoost, thể hiện huấn luyện tám thẻ H100 gửi qua một NIC biên 200 Gbit/s (kết nối tới mạng trung tâm dữ liệu đa dụng, không phải liên kết nối giữa các GPU tốc độ cao), trong khi giao diện biên của mỗi thể hiện rollout hai thẻ là 50 Gbit/s, và sáu lần truyền chia sẻ đường cổng ra của người gửi. Gửi toàn bộ trọng số cho một người nhận mất ít nhất
còn đường cổng ra dùng chung phải gửi tổng cộng khoảng 98,3 GB, nên gửi toàn bộ trọng số cho cả sáu thể hiện mất ít nhất
Đưa trọng số tới cả sáu thể hiện mất ít nhất 3,93 giây; thể hiện đầu tiên có thể nhận 16,38 GB của riêng nó sớm hơn. Sau đó, người nhận nạp trọng số vào bộ nhớ GPU và xác nhận phiên bản, và chỉ lúc đó bộ lập lịch mới gán yêu cầu cho nó. PolyRL, vốn dùng tài nguyên tạm thời để mở rộng bể sinh RL, trước tiên nhận toàn bộ trọng số vào một bộ đệm CPU rồi trao cho một nhóm GPU dùng TP (xem Mục 6.2.2). Do đó TP=2 chỉ chia tính toán trong một thể hiện cho hai thẻ; mỗi thể hiện vẫn nhận đủ 16,38 GB trọng số từ bên ngoài.
Hình 11-25 đánh dấu đường cổng ra được chia sẻ bởi cả sáu bản sao của trọng số. Khi số thể hiện nhận tăng lên, tổng số byte phải gửi cũng tăng, nhưng băng thông của người gửi không tăng theo. Sau khi trọng số truyền xong, chúng vẫn phải được nạp lên GPU, và thời gian chuẩn bị này cũng phải được trừ khỏi thời gian mà thể hiện tạm thời có sẵn.
Một khi thể hiện tạm thời được cấp tài nguyên, nó phải hoàn tất chuẩn bị trước khi thời gian còn lại có thể được dùng cho việc sinh. Giả sử một thể hiện cần tổng cộng 8 giây từ lúc cấp tài nguyên tới lúc bắt đầu sinh, và có tổng cộng 20 giây khả dụng, chỉ để lại 12 giây cho việc sinh; nếu chỉ có 5 giây khả dụng, thể hiện bị thu hồi trước khi kịp bắt đầu làm việc. Gọi thời gian khả dụng là và thời gian chuẩn bị-phục hồi là ; cửa sổ làm việc dùng được lúc đó là . Thể hiện còn khả dụng càng lâu, phần bị chiếm bởi chi phí chuẩn bị càng nhỏ, và phần để lại cho việc sinh thực tế càng lớn.
Khi một thể hiện tạm thời bị thu hồi sớm, thứ bị mất không chỉ là dung lượng chưa dùng mà còn cả nội dung đã sinh. Lưu tiền tố đã sinh có thể mang công việc đã hoàn thành sang một thể hiện mới: thể hiện mới đọc vào “đầu vào gốc cộng đầu ra đã ghi”, thực hiện prefill, xây dựng bộ đệm KV, rồi tiếp tục sinh. Khi PolyRL thu hồi một nhóm yêu cầu dùng chung tham số lấy mẫu, nó cắt mọi phản hồi trong nhóm về độ dài đã lưu ngắn nhất trong số chúng: nếu hai phản hồi đã lần lượt nhận được 4.000 và 1.000 token, cả hai đều bị cắt về 1.000 token, tái sử dụng 2.000 token gộp lại, còn 3.000 token vượt quá trong phản hồi dài hơn phải được sinh lại. Một khi được cắt về cùng độ dài, nhóm yêu cầu này có thể được lập lịch đồng nhất cho việc sinh tiếp theo.
Trong một so sánh có kiểm soát trên bản triển khai Qwen3-8B 4-bit cục bộ, giữ tiền tố đã tiết kiệm được 96 token lấy mẫu trùng lặp, nhưng tổng thời gian yêu cầu khoảng 12,8 giây, so với khoảng 11,6 giây khi làm lại từ đầu. Số token tiết kiệm được tương ứng với giai đoạn sinh, trong khi đường đầy đủ còn gồm tái dựng tiền tố và lập lịch lại. Trong so sánh này, thời gian thêm bỏ vào tái dựng tiền tố và lập lịch lại vượt quá thời gian sinh đã tiết kiệm được.
Việc thêm các thể hiện tạm thời có đáng giá hay không cũng có thể được đánh giá từ chi phí. Dùng các mức giá lịch sử mà RLBoost sử dụng, một thể hiện huấn luyện tốn khoảng 84 mỗi giờ, và mỗi thể hiện trong sáu thể hiện thêm vào tốn khoảng 5,30, cho một tốc độ gộp khoảng 116 mỗi giờ. Khi mọi thể hiện được tính tiền suốt cả thời gian, thông lượng cho cùng một đợt task huấn luyện phải đạt khoảng lần tốc độ ban đầu trước khi chi phí trên mỗi đơn vị công việc giảm. Nếu thông lượng chỉ đạt 1,2 lần ban đầu, thời gian hoàn thành rút ngắn nhưng chi phí tăng lên khoảng 1,15 lần ban đầu; ở mức 1,6 lần thông lượng ban đầu, chi phí thay vào đó giảm xuống khoảng 0,86 lần.
11.3.4 Đợt xác minh, đuôi dài và giải phóng tài nguyên
Mục 11.3.3 coi xác minh là một khối công việc đơn lẻ theo sau toàn bộ giai đoạn sinh; trên thực tế, các mẫu thường được sinh lần lượt, và việc xác minh có thể bắt đầu sớm hơn — thứ mà việc cập nhật huấn luyện phải chờ là kết quả cuối cùng trên toàn bộ đợt xác minh. Xác minh mã CUDA đòi hỏi trước tiên biên dịch trên CPU, sau đó thực thi trên GPU. Lập lịch các task xác minh cần xem xét không chỉ dung lượng CPU mà còn cả sự can nhiễu mà việc thực thi đồng thời gây ra đối với phép đo hiệu năng GPU.
Nếu mẫu đến tại thời điểm , lần lượt cần giây để biên dịch và giây để thực thi, thì bỏ qua sự tranh chấp tài nguyên, cận dưới của thời gian hoàn thành toàn đợt là
Thiếu tiến trình thực thi gây ra xếp hàng, và khởi chạy tiến trình cũng như truyền dữ liệu cũng tốn thời gian — tất cả đều làm trễ thời điểm hoàn thành của đợt. Gửi các mẫu đã sinh càng sớm càng tốt cho phép xác minh chồng lấp với việc sinh tiếp theo. Hai cách sắp xếp trong Hình 11-26 và Hình 11-27 đều cần 30 giây thời gian xử lý xác minh, thế mà thời điểm hoàn thành của chúng lệch nhau 20 giây; khác biệt duy nhất là thời điểm gửi.
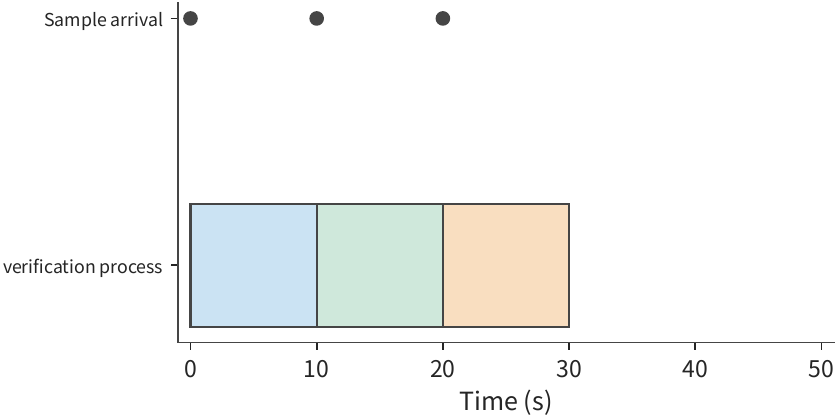
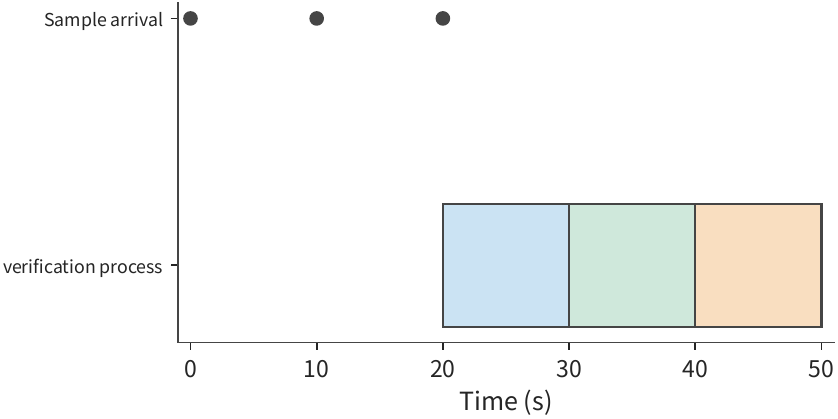
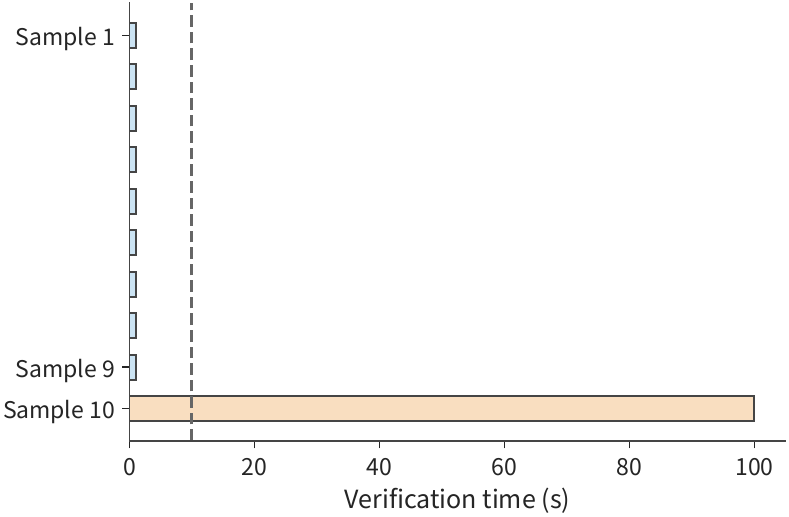
Gửi theo từng mẫu loại bỏ khoảng trống phải dành để chờ toàn đợt được sinh xong, nhưng thời gian hoàn thành của đợt vẫn có thể bị quyết định bởi lần xác minh chậm nhất. Ước tính một task đuôi dài như vậy còn chạy bao lâu đòi hỏi cập nhật ước tính dựa trên thời gian nó đã chạy. Giả sử, từ các phép đo có sẵn, chín lần xác minh mỗi lần mất 1 giây và một lần mất 100 giây, trung bình 10,9 giây. Nếu một lần xác minh nào đó đã chạy 10 giây mà chưa kết thúc, trừ 10 khỏi 10,9 sẽ dự đoán chỉ còn 0,9 giây. Thế nhưng trong phân phối rời rạc này, lần xác minh đó hẳn là lần 100 giây, nên vẫn cần thêm 90 giây. Thời gian còn lại vì vậy nên được ước tính có điều kiện trên việc task chưa kết thúc, tức , trong đó là tổng thời gian thực thi của một lần xác minh, là thời gian đã trôi qua, và ký hiệu việc chỉ lấy trung bình trên các mẫu chưa kết thúc. Thuật toán lập lịch của DistRS áp dụng kiểu thời gian còn lại có điều kiện này thay vì luôn dùng trung bình tổng thể.
Một khi thời gian còn lại của mỗi mẫu được ước tính, các lần xác minh khác có thể được lập lịch tương ứng để càng nhiều càng tốt tránh kéo dài thời gian chờ của toàn đợt. Giả sử một mẫu trong đợt sớm nhất phải tới giây 120 mới kết thúc. Để lập lịch một phần việc không cần quá 100 giây thực thi, phần việc đó phải bắt đầu không muộn hơn giây 20 để dùng khoảng trống phía trước mà không trì hoãn đợt; nếu việc chuẩn bị môi trường của nó mất 5 giây, việc chuẩn bị phải bắt đầu không muộn hơn giây 15. Làm ngược từ thời điểm hoàn thành của đợt sẽ cho thời điểm bắt đầu muộn nhất cho phép của từng phần việc, để bộ lập lịch trì hoãn các công việc không khẩn cấp và ưu tiên tài nguyên cho các đợt có hạn sớm hơn.
Trì hoãn các lần xác minh không khẩn cấp có thể giảm mức sử dụng tài nguyên xác minh, nhưng nếu nó làm trễ thời điểm hoàn thành của toàn đợt, nó cũng khiến nhóm huấn luyện chờ lâu hơn. Giả sử trì hoãn xác minh tiết kiệm 60 H100-giây, nhưng khiến một nhóm huấn luyện vẫn giữ 64 H100 (8 khối HGX H100) chờ thêm 2 giây. Nhóm huấn luyện lúc đó cộng thêm H100-giây, cho mức tăng ròng trên toàn hệ thống là 68 H100-giây. Nếu nhóm huấn luyện chỉ có 16 thẻ (2 khối), thời gian chờ thêm là 32 H100-giây, và hệ thống thay vào đó tiết kiệm ròng 28 H100-giây. Việc thu nhỏ tài nguyên xác minh có đáng hay không vì vậy phụ thuộc vào kích thước của nhóm huấn luyện đang bị chặn.
Một khi thời điểm hoàn thành được lập lịch, người ta vẫn phải xác nhận rằng các task đã kết thúc hoặc hết thời gian chờ thực sự đã ngừng thực thi trước khi tài nguyên của chúng được trao cho task kế tiếp. Trong một lần xác minh có kiểm soát, sau khi bộ chờ trả về hết thời gian, luồng nền vẫn tiếp tục chạy thêm khoảng 130 ms; sau khi chủ động kết thúc tiến trình con, việc thoát của tiến trình được quan sát thấy sau khoảng 0,8 ms. Nếu cùng tài nguyên được trao cho task kế tiếp ngay khi hết thời gian, trong khi chỉ báo cáo hết thời gian mà không kết thúc luồng nền, hai task sẽ cùng sử dụng tài nguyên cùng lúc. Với việc xác minh hiệu năng CUDA, kiểu tranh chấp này thậm chí có thể làm thay đổi thời gian thực thi và phần thưởng được đo.
11.4 Lựa chọn dịch vụ model và chi phí lời gọi
11.4.1 Chất lượng task và ngân sách suy nghĩ
Dựng lại môi trường mỗi vòng đã đưa nhu cầu bộ nhớ của nền tảng từ 600 GiB ở đầu chương xuống 180 GiB, nhưng thời gian hoàn thành task vẫn là 30 giây, vượt mục tiêu 24 giây. Vì vậy ta cần thay đổi lời gọi model trên đường tới hạn. Giảm số phiên mà mỗi replica V4-Flash phục vụ đồng thời từ 32 xuống 16 làm giảm thời gian mỗi token đầu ra từ 25,3 ms xuống 16,9 ms; một lời gọi đầy đủ sinh 355 token giảm từ 9 giây xuống 6 giây, nên ba vòng giảm từ 30 giây xuống 21 giây; bản thân model không đổi, và tỷ lệ vượt qua kiểm thử của task vẫn giữ nguyên. Nếu môi trường thường trú suốt quá trình, mức chiếm dụng mỗi task cũng giảm từ 60 xuống 42 GiB-giây, đưa tổng nhu cầu bộ nhớ của nền tảng từ 600 xuống 420 GiB — vẫn trên ngân sách 358 GiB; nếu thay vào đó môi trường được dựng lại mỗi vòng, nó chỉ cần được giữ trong lúc chuẩn bị và thực thi của từng vòng, giữ mức chiếm dụng tích lũy ở 18 GiB-giây. Lựa chọn dịch vụ model vì vậy đồng thời ảnh hưởng cả thời lượng task lẫn nhu cầu bộ nhớ môi trường.
Lựa chọn model cũng quyết định cấu trúc chi phí của mỗi lời gọi. Thời gian và chi phí của một lời gọi model gồm ba phần: xử lý đầu vào, sinh token suy nghĩ và sinh đầu ra hiển thị. Ngân sách suy nghĩ quyết định lượng lý luận nội bộ được phép sinh ra, còn mức sử dụng thực tế quyết định mỗi lời gọi tốn bao nhiêu. Trước tiên, với điều kiện cả hai cài đặt đều vượt qua kiểm thử, ta so sánh chi phí mỗi lời gọi của hai cài đặt độ dài suy nghĩ, rồi so sánh chi phí mỗi cài đặt cần để hoàn thành ba vòng của task.
Ví dụ 11-5: Nếu độ dài suy nghĩ rút ngắn còn một phần mười, tổng chi phí giảm bao nhiêu? Giả sử cả hai cài đặt độ dài suy nghĩ đều vượt qua cùng các bài kiểm thử, mỗi lời gọi có 10.000 token đầu vào và 200 token đầu ra hiển thị, với lượng suy nghĩ thực tế lần lượt là 1.000 và 100 token. Định giá theo giá API tiêu chuẩn của Claude Sonnet 5: 2 đô la cho mỗi triệu token đầu vào, 10 đô la cho mỗi triệu token được sinh, với token suy nghĩ tính tiền như đầu ra. Thì chi phí mỗi lời gọi (tính bằng đô la) lần lượt là
Số token suy nghĩ giảm còn một phần mười so với ban đầu, thế mà tổng chi phí chỉ giảm khoảng 28%. Trong chi phí ban đầu, 0,020 dành cho đầu vào và 0,002 cho đầu ra hiển thị — cả hai không đổi; phần giảm là chi phí suy nghĩ, từ 0,010 xuống 0,001. Như vậy, tỷ trọng của chi phí ban đầu thuộc về suy nghĩ quyết định việc nén suy nghĩ có thể tiết kiệm bao nhiêu.
Hình 11-29 đánh dấu chính xác chỗ tiết kiệm xảy ra. So sánh này giả định cả hai cài đặt đều có thể hoàn thành task; nếu rút ngắn suy nghĩ đòi hỏi một lần thử lại, khoản tiết kiệm màu cam phải được cân với chi phí đầy đủ của một lời gọi thử lại bổ sung.
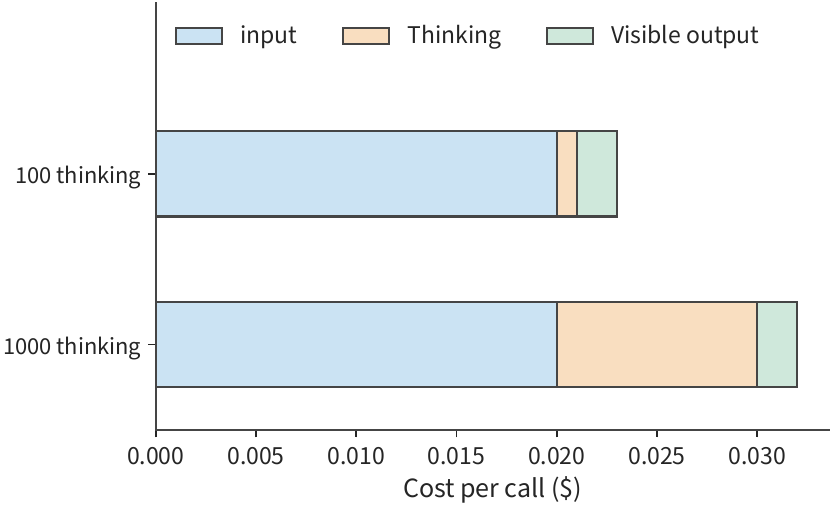
Giả sử 100 lời gọi mỗi lời gọi tiết kiệm 0,009, tổng tiết kiệm 0,9; nhưng 30 trong số đó phải thử lại do ngân sách bị cắt cụt, và mỗi lần thử lại tốn 0,032, cộng thêm 0,96. Tổng chi phí thực tế tăng thêm 0,06. Rút ngắn ngân sách suy nghĩ có thể làm tăng số lần thử lại. Vì vậy, khi so sánh tổng chi phí task, người ta phải tính cả khoản tiết kiệm mỗi lời gọi lẫn chi phí thêm của các lần thử lại bổ sung.
11.4.2 Đường dịch vụ, lưu tiền tố trong bộ nhớ và mức sử dụng thực tế
Mục 11.4.1 dựa vào việc giảm khối lượng sinh để hạ chi phí; cơ hội tiết kiệm chính ở phía đầu vào là các tiền tố lặp lại: nhiều lời gọi trong cùng một task thường gửi lại một prompt chung và lịch sử hội thoại trước đó. Một yêu cầu model đi vào từ controller tới một điểm cuối dịch vụ thống nhất, rồi được trao cho backend model đã chọn. Ở đây “backend” chỉ thể hiện suy luận hoặc nhà cung cấp dịch vụ thực sự thực thi suy luận model. Điểm cuối xử lý xác thực, định tuyến và giới hạn tốc độ; backend xử lý việc xử lý đầu vào và sinh đầu ra. 30 lời gọi mỗi giây từ đầu chương tạo ra nhu cầu liên tục trên đường này; phần đầu vào của mỗi lời gọi có thể được tái sử dụng bao nhiêu được quyết định bởi prompt chung và lịch sử task mà nó mang theo.
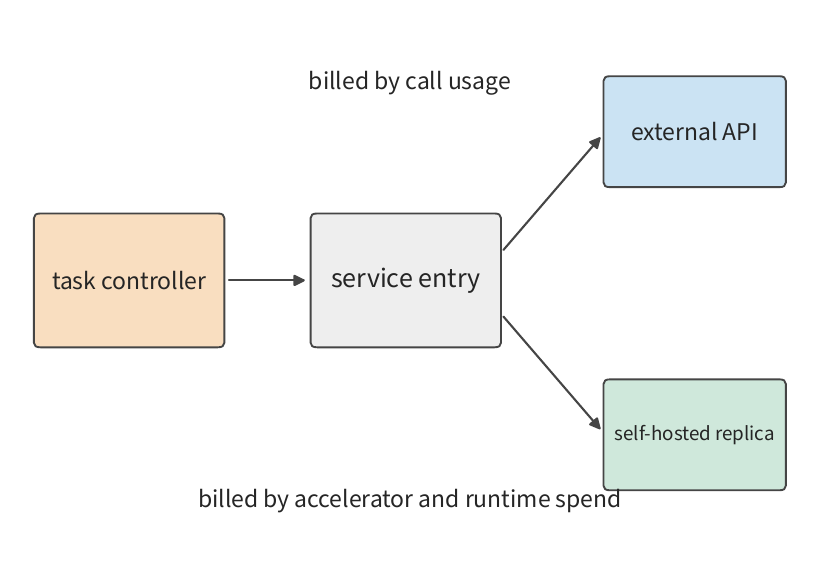
Tách đầu vào của một lời gọi thành các phần loại trừ lẫn nhau: đầu vào thông thường , đầu vào tạo bộ nhớ đệm và đầu vào đọc bộ nhớ đệm , với số token sinh ra bị tính phí là , và các mức giá tương ứng mỗi triệu token là , cho ta
Trong một lời gọi, bất kỳ token đầu vào nào cũng thuộc chính xác một trong ba loại: đầu vào thông thường, tạo bộ nhớ đệm hoặc đọc bộ nhớ đệm. Sắp xếp bản ghi mức sử dụng do dịch vụ trả về vào ba loại này, nhân mỗi loại với đơn giá tương ứng rồi cộng lại cho ta chi phí đầu vào. Số token sinh ra là tổng của token suy nghĩ và token đầu ra hiển thị.
Ví dụ 11-6: Lưu trữ một tiền tố chung trong bộ nhớ qua các vòng có thể tiết kiệm bao nhiêu chi phí đầu vào? Mỗi vòng có 8.000 token tiền tố chung và 2.000 token đầu vào mới không được tái sử dụng. Theo định giá tiêu chuẩn của Claude Sonnet 5, đầu vào thông thường tốn 2 đô la mỗi triệu token, lần tạo đầu tiên của bộ nhớ đệm 5 phút tốn 2,5, và đọc bộ nhớ đệm tốn 0,2. Bộ nhớ đệm được tạo ở lời gọi đầu tiên và trúng vào cả chín lời gọi sau trong khoảng hiệu lực của nó. Không lưu trữ, chi phí đầu vào cho mười vòng là 0,20; có lưu trữ (tính bằng đô la) là
Ví dụ này giữ việc sinh và thực thi công cụ giống hệt nhau qua mười vòng, nên toàn bộ chênh lệch chi phí được so sánh đến từ đầu vào. Lời gọi đầu tiên dùng bộ nhớ đệm tốn 0,024, nhiều hơn 0,004 so với 0,020 của xử lý thông thường; mỗi vòng sau chỉ tốn 0,0056, ít hơn 0,0144 so với xử lý thông thường. Vậy lần truy cập thứ hai đã thu hồi phần chênh phải trả cho lần tạo đầu tiên. Với tổng cộng lần truy cập, lưu trữ tiết kiệm hơn khi . Khoảng hiệu lực của bộ nhớ đệm càng dài, các lần đọc lặp lại càng có nhiều cơ hội để thu hồi chi phí thêm của lần tạo đầu tiên.
Việc bộ nhớ đệm tiết kiệm bao nhiêu cũng phụ thuộc vào yêu cầu nào trúng nó. Xét hai lời gọi, một lời gọi có tiền tố 1.000 token và một lời gọi có tiền tố 9.000 token. Nếu chỉ tiền tố ngắn trúng, tỷ lệ trúng theo yêu cầu là 50%, nhưng số token đọc bộ nhớ đệm chỉ bằng 10% tổng chiều dài tiền tố của hai lời gọi; nếu chỉ tiền tố dài trúng, tỷ lệ trúng theo yêu cầu vẫn là 50%, nhưng phần đọc lên tới 90%. Với phép tính phí theo token, cách sau tiết kiệm trên chi phí xử lý đầu vào nhiều hơn hẳn cách trước. Trọng số của mỗi lần trúng được quyết định bởi độ dài đầu vào.
11.4.3 Xếp hàng, giới hạn tốc độ và định tuyến model
Bộ nhớ đệm chỉ có thể được tái sử dụng khi một yêu cầu tới được một backend đã lưu tiền tố tương ứng. Vì vậy việc chọn backend ảnh hưởng cả tỷ lệ trúng lẫn thời gian xếp hàng. Để dùng một bộ nhớ đệm tiền tố có sẵn, đôi khi chờ thêm một chút là đáng. Giả sử backend A chạy cùng model xếp hàng 200 ms, và xử lý tiền tố sau khi trúng mất 50 ms; backend B xếp hàng 20 ms, và xử lý sau khi trượt mất 500 ms; thời gian mạng dùng chung là 50 ms, và việc sinh phía sau là như nhau. Trước khi vào giai đoạn sinh, A mất 300 ms và B mất 570 ms, nên A dẫn trước 270 ms. Việc trúng bộ nhớ đệm tiết kiệm 450 ms thời gian xử lý nhưng cộng thêm 180 ms thời gian xếp hàng, cho lợi ích ròng đúng bằng 270 ms. Khi thời gian xếp hàng của A tăng lên 470 ms, cả hai dành cùng một khoảng thời gian trước khi việc sinh bắt đầu.
30 lời gọi model mỗi giây từ đầu chương cũng bị giới hạn bởi dung lượng đồng thời. Khi mỗi lời gọi mất 9 giây, trung bình 270 lời gọi đang thực thi cùng lúc; rút ngắn xuống 6 giây giảm còn 180. Nhưng dịch vụ nhanh hơn này đạt được bằng cách thu nhỏ batch của mỗi replica: vì mỗi replica chỉ phục vụ 16 phiên đồng thời, 10 replica chỉ cung cấp 160 slot đồng thời, không chứa nổi 180 lời gọi, đòi hỏi phải tăng lên 12 replica (48 thẻ B200). Thời gian GPU chiếm mỗi lời gọi cũng tăng từ B200-giây lên B200-giây. Trong khi đó, các API trả theo mức sử dụng thường giới hạn riêng số yêu cầu và số token trên một đơn vị thời gian; nếu đầu vào hoặc đầu ra của mỗi lời gọi lớn lên, hạn mức token có thể cạn trước hạn mức số lượng yêu cầu. Khi chọn dịch vụ model, người ta phải so sánh riêng thời gian xếp hàng của yêu cầu, dung lượng lời gọi đồng thời và khả năng xử lý token để tìm ra yếu tố giới hạn tốc độ hoàn thành task.
Ví dụ 11-7: Khi nào việc trúng bộ nhớ đệm và tỷ lệ thành công có thể bù đắp một đơn giá dịch vụ cao hơn? Gửi 1.000 task một lời gọi cho cả Claude Haiku 4.5 (ký hiệu A) và Claude Sonnet 5 (ký hiệu B). Mỗi lời gọi có 20.000 token đầu vào, trong đó 19.000 là tiền tố chung và 1.000 là đầu vào mới. Bộ nhớ đệm tiền tố đã được thiết lập sẵn, không có thêm chi phí tạo bộ nhớ đệm, lưu trữ, công cụ hay làm nóng, và xác suất task được chấp nhận độc lập với việc bộ nhớ đệm có trúng hay không. Đơn giá theo định giá API tiêu chuẩn của hai model, còn số token suy nghĩ và xác suất thành công được cho trước.
| Tham số | A: Haiku 4.5 | B: Sonnet 5 |
|---|---|---|
| Giá đầu vào thông thường / đô la mỗi triệu token | 1 | 2 |
| Giá đọc bộ nhớ đệm / đô la mỗi triệu token | 0,1 | 0,2 |
| Giá sinh / đô la mỗi triệu token | 5 | 10 |
| Token suy nghĩ thực tế | 1.800 | 100 |
| Token đầu ra hiển thị | 200 | 200 |
| Xác suất thành công theo cùng một quy tắc chấp nhận | 0,80 | 0,98 |
Tiền tố của A luôn trúng, với chi phí mỗi lời gọi là 0,0129, cho chi phí trung bình mỗi task thành công là . Chi phí mỗi lời gọi của B khi trúng hết là 0,0088, và 0,0430 khi trượt. Gọi tỷ lệ trúng yêu cầu của B là , ta có
Đặt chi phí trung bình của B bằng chi phí trung bình của A cho ta . Dù mỗi đơn giá token của B gấp đôi của A, B vẫn tiết kiệm hơn ở tỷ lệ trúng cao vì nó sinh ít hơn và thành công thường xuyên hơn. Khi tỷ lệ trúng giảm xuống 50%, chi phí task thành công của B tăng lên khoảng 0,0264, lúc đó A rẻ hơn.
Giờ thêm yêu cầu ít nhất 90% task được gửi đi phải vượt qua chấp nhận trong 6 giây. Giả sử thời lượng yêu cầu hoàn chỉnh là: 10 giây với A; 4 giây với B khi trúng, 12 giây khi trượt, cả hai đều đã gồm xếp hàng và sinh. A không đạt được hạn thời gian; B cần , tức .
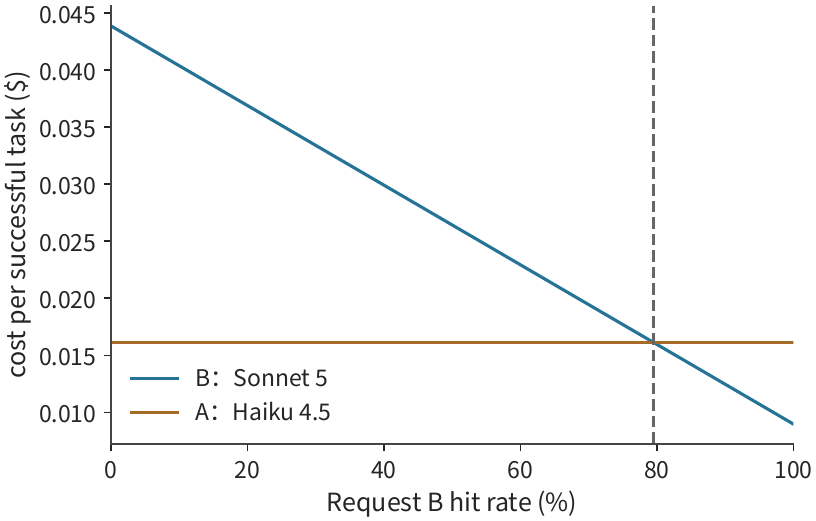
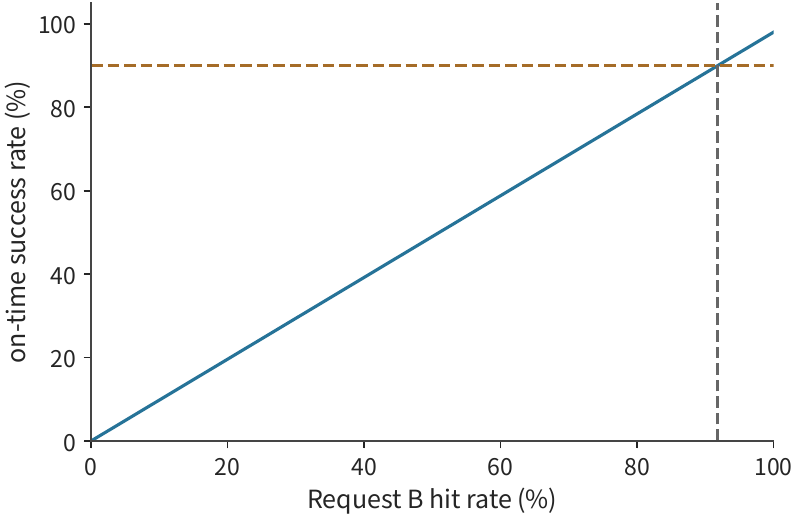
Trong ví dụ này, mỗi tiền tố luôn là 19.000 token, nên tỷ lệ trúng yêu cầu cũng bằng tỷ trọng token trúng bên trong tiền tố; so với toàn bộ 20.000 token đầu vào, phần đọc bộ nhớ đệm là . Điểm giao nhau về chi phí là khoảng 79,5%, còn ngưỡng nghiệp vụ là khoảng 91,8%. Di chuyển sang phải từ tỷ lệ trúng thấp, B trước tiên trở nên rẻ hơn, và chỉ sau đó mới đạt mục tiêu hoàn thành đúng hạn. Đặt mục tiêu dịch vụ lên đường chi phí cho phép ta đọc trực tiếp vùng khả thi cuối cùng.
11.4.4 So sánh chi phí giữa dịch vụ tự lưu trữ, API trả theo mức sử dụng và thuê bao
So sánh định tuyến đã xác định dịch vụ model nào đồng thời thỏa mãn yêu cầu chất lượng, chi phí và hạn thời gian. Một khi dịch vụ được chọn, ta vẫn cần quyết định tự lưu trữ, trả theo từng lời gọi, hay mua thuê bao. Lựa chọn model quyết định mỗi task cần dịch vụ gì; phương thức mua sắm quyết định cách trả tiền cho dịch vụ đó. Dung lượng tự lưu trữ trả chi phí thiết bị và dành riêng trước, sau đó phân bổ đều cho các task; API trả theo mức sử dụng tính phí từng lời gọi; thuê bao tính phí cố định mỗi tháng hoặc kỳ khác, trao quyền sử dụng sản phẩm tương ứng. Câu hỏi chung của cả ba là: một khi cùng một khối lượng task phải được đáp ứng, tổng chi tiêu biến đổi thế nào theo khối lượng sử dụng?
Giả sử trong một cửa sổ thống kê cố định, chi phí dành riêng và cố định của việc tự lưu trữ là , chi phí biên mỗi task được gửi đi là ; chi phí trung bình mỗi task của API là . Nếu xác suất thành công của cả hai như nhau và dung lượng xử lý của cả hai đều đáp ứng nhu cầu, điều kiện để tự lưu trữ tiết kiệm hơn với task là
Nếu , chi phí mỗi task của API đã không cao hơn chi phí biên tự lưu trữ, và vì khoản đầu tư cố định là dương, API rẻ hơn ở mọi mức sử dụng. Nếu tỷ lệ thành công khác nhau, các mẫu số trở thành và tương ứng, và phép so sánh trở thành chi phí trên mỗi task thành công.
Dưới đây, ta so sánh hai phương thức thanh toán dùng cùng model và cùng loại GPU, với kích thước batch và chất lượng task giống hệt nhau ở cả hai bên — khác biệt duy nhất là phương thức tính phí. Phương án dành riêng thuê 4 thẻ trong một tháng (720 giờ) theo mức giá công bố của nền tảng GPU đám mây Runpod cho B200 Pod của nó (tính phí theo giờ, phiên bản GPU chuyên dụng) — 6,79 đô la mỗi GPU-giờ — cho đô la; vì GPU được trả tiền cho cả tháng, chi phí biên mỗi task bằng 0. Phương án trả theo mức sử dụng dùng worker B200 Serverless của cùng nền tảng (8,64 đô la mỗi GPU-giờ) tính phí theo giây, trả theo mức sử dụng giống như một API trả theo mức sử dụng, và cũng chạy với batch 32 phiên. Theo task ở đầu chương, mỗi task gồm ba lời gọi, mỗi lời gọi chiếm 1,125 B200-giây, cho chi phí trả theo mức sử dụng là đô la.
Khối lượng task tại đó hai chi phí bằng nhau là triệu task. Vì mỗi task chiếm một phiên trong 27 giây, 4 thẻ B200 này có thể xử lý nhiều nhất triệu task trong một tháng, và điểm giao nhau tương ứng với khoảng 78,6% mức tận dụng — chính xác là tỷ lệ của hai đơn giá, . Ở 1 triệu task, dành riêng vẫn tốn 19.555,2 trong khi trả theo mức sử dụng chỉ cần 8.100; ở 3 triệu task, trả theo mức sử dụng cần 24.300 và dành riêng tiết kiệm hơn. Khoản đầu tư cố định khó phân bổ ở mức sử dụng thấp, nhưng ở mức sử dụng cao nó được bù lại bởi chi phí biên thấp hơn.
Trong Hình 11-33, chi phí dành riêng là một đường nằm ngang, chiều cao đến từ tiền thuê cả tháng, kết thúc ở bên phải tại trần xử lý của nhóm GPU này; chi phí trả theo mức sử dụng bắt đầu từ không, với độ dốc được quyết định bởi thời gian GPU chiếm mỗi task. Một khi hiệu quả thực thi được cải thiện, cùng 4 thẻ B200 có thể xử lý nhiều task hơn mỗi tháng, kéo dài đường dành riêng sang phải và hạ độ dốc của đường trả theo mức sử dụng; điểm giao nhau vẫn tương ứng với cùng mức tận dụng, tức là tỷ lệ của hai đơn giá.
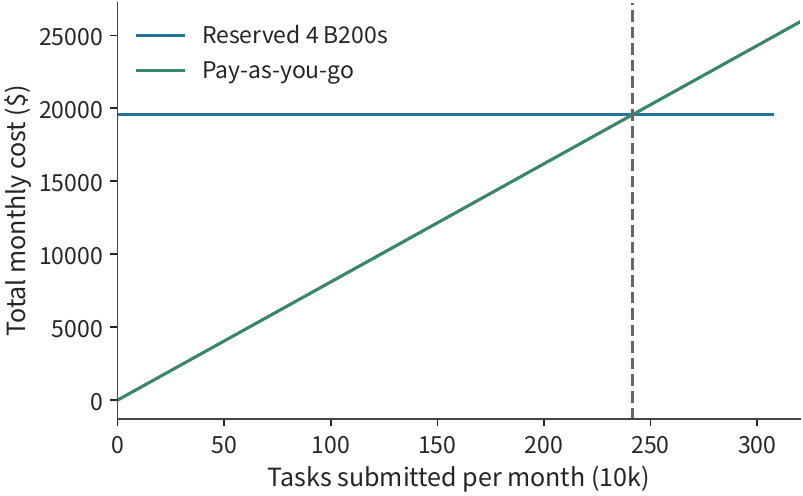
Hiệu quả thực thi có thể cải thiện được bao nhiêu phụ thuộc vào thời gian được tiêu ở đâu. Vẫn lấy triển khai chạy DeepSeek V4-Flash trên 4 thẻ B200 làm ví dụ, phục vụ 32 phiên đồng thời, mỗi phiên giữ ngữ cảnh 200K token, với số phiên và giá thuê GPU được giữ cố định. Mỗi token đầu ra mất khoảng 25,3 ms, trong đó giải mã (decode) mỗi token chiếm 15,9 ms, còn 9,4 ms còn lại dành cho xử lý đầu vào và tái cấu trúc ngữ cảnh. Một khi tốc độ thực tế của giải mã tăng gấp đôi, thời gian cần cho mỗi token đầu ra giảm xuống ms, mức tăng tốc tổng thể khoảng 1,46×, hạ chi phí GPU mỗi triệu token đầu ra từ khoảng 6,0 xuống 4,1.
Trong thời gian ban đầu mỗi token đầu ra, khoảng 63% dành cho giải mã và 37% còn lại không bị ảnh hưởng, nên việc tăng tốc giải mã gấp đôi chỉ có thể rút ngắn tổng thời gian khoảng 31%. Ngay cả khi đưa thời gian giải mã về không, phần xử lý còn lại vẫn cần 9,4 ms. 9,4 ms này phải được tách tiếp theo tiêu chí ở Mục 1.3.4: đọc bộ đệm KV và tái cấu trúc ngữ cảnh là công việc bắt buộc, và thời gian tính từ băng thông tạo thành một cận dưới mới; lập lịch, sao chép và chuyển định dạng là chi phí phần mềm có thể loại bỏ — và đó chính là nơi còn khoảng trống tối ưu hóa. Vượt qua giới hạn này đòi hỏi tối ưu hóa thêm việc xử lý đầu vào và tái cấu trúc ngữ cảnh; chỉ khi cùng một tập bộ tăng tốc sinh ra nhiều token hơn trên một đơn vị thời gian, giá thuê cố định mới có thể được phân bổ cho nhiều đầu ra hơn.
Nền tảng sửa mã nguồn ở đầu chương gọi model 30 lần mỗi giây. Dịch vụ nhanh hơn chiếm thêm 0,375 B200-giây mỗi lời gọi, tốn thêm khoảng 0,00071 ở mức giá Pod, nên nền tảng chi thêm 0,021 mỗi giây; chi phí thêm này đưa thời lượng task từ 30 giây xuống 21 giây, thỏa hạn 24 giây. Ở cuối chương, chúng ta sẽ cùng tính chi phí model thêm vào và chi phí chiếm môi trường tiết kiệm được, so sánh tổng chi phí task của từng sơ đồ.
11.5 Phục hồi task đầy đủ, tính chi phí và mở rộng quy mô
11.5.1 Phục hồi sau lỗi công cụ và lựa chọn model
Trong Mục 11.4, việc chọn model chủ yếu xét trường hợp các lời gọi hoàn thành bình thường. Trong vận hành thực tế, ta cũng cần xử lý lời gọi thất bại, kết quả bị mất và bất thường của công cụ. Nếu controller không nhận được thông điệp xác nhận rằng một bài kiểm thử đã hoàn thành, nó không thể phân biệt hai tình huống: bài kiểm thử chưa hoàn thành, hoặc bài kiểm thử đã hoàn thành nhưng thông điệp xác nhận bị mất.
Trong lúc phục hồi, controller trước tiên truy vấn các kết quả đã được lưu bền vững, kiểm tra mã định danh thao tác và phiên bản tệp đầu vào. Nếu kết quả tồn tại, nó có thể tiếp tục; nếu không, nó xác định liệu việc thử lại có được phép hay không. Một thao tác idempotent (lũy đẳng) là thao tác mà việc gọi lặp lại với cùng mã định danh thao tác tạo ra hiệu ứng nghiệp vụ cuối cùng giống như một lần gọi đơn. Lặp lại một truy vấn chỉ đọc hoặc thao tác idempotent thường không vấn đề gì; tuy nhiên, lặp lại một khoản thanh toán ngoài, tạo tài nguyên hoặc gửi thông điệp có thể khiến cùng một thao tác thực sự xảy ra hai lần, đòi hỏi hệ thống đích phải hỗ trợ mã định danh thao tác, giao dịch hoặc bồi thường.
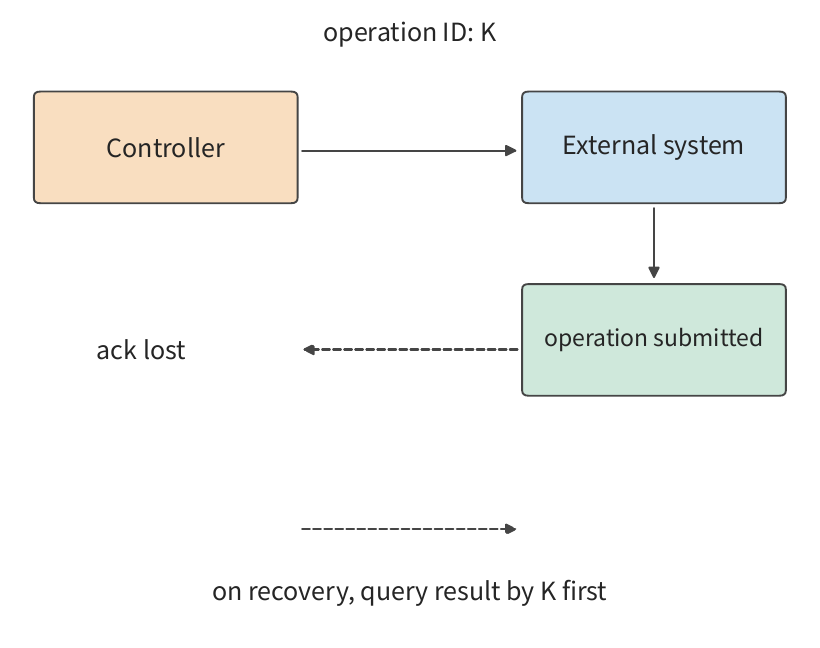
Giả sử thực thi một công cụ một lần mất 3 CPU-giây, và kết quả được gửi hai lần. Nếu phía nhận khử trùng lặp bằng mã định danh thao tác, thời gian CPU tích lũy vẫn là 3 giây; nếu controller thực thi lại vì xác nhận bị mất, thời gian CPU tích lũy tăng lên 6 giây. Cả hai trường hợp có thể đều kết thúc với chỉ một kết quả, thế mà chúng tiêu thụ tài nguyên khác nhau. Khử trùng lặp thông điệp giải quyết loại trùng lặp trước; loại sau phải được tránh qua các kết quả lưu bền vững và giao thức idempotency của hệ thống đích. Các thao tác đã được cam kết bên ngoài môi trường vẫn tồn tại sau khi phục hồi snapshot, nên quá trình phục hồi phải trước tiên truy vấn trạng thái cam kết của chúng.
Tuy nhiên, một yêu cầu trả về bình thường không có nghĩa bản ghi của nó chắc chắn có thể được tìm thấy khi phục hồi. Các hệ điều hành truyền thống cũng phân biệt “đã ghi xong” với “đã được lưu bền vững”. Lấy việc ghi có bộ đệm vào một tệp thông thường làm ví dụ: khi write() trả về, dữ liệu có thể vẫn nằm trong bộ đệm trang của nhân, và chương trình có thể tiếp tục tính toán trong khi hệ điều hành ghi nó ra ở nền. Nếu chương trình phải chờ tới khi dữ liệu được lưu an toàn mới tiếp tục, nó cần gọi fsync(), chờ dữ liệu tệp và siêu dữ liệu cần thiết được ghi vào thiết bị lưu trữ, và kiểm tra xem việc đó có thành công không.
Runtime của agent cũng cần chỉ rõ: khi báo cáo hoàn thành cho người gọi, nó chỉ đảm bảo câu trả lời đã được sinh ra, hay đảm bảo các thông điệp, kết quả công cụ và vị trí phục hồi đều đã được lưu? Các quy ước này tạo thành ngữ nghĩa bền vững (persistence semantics). Chỉ gọi fsync() trên nhật ký trò chuyện là chưa đủ, vì thông tin cần cho việc phục hồi có thể được lưu riêng rẽ trong nhật ký, thư mục làm việc và một cơ sở dữ liệu ngoài; controller cũng phải kiểm tra rằng thao tác trong thông điệp, tệp trong thư mục và kết quả trong cơ sở dữ liệu đều nhất quán.
Ở đây ta lưu theo vòng của vòng lặp ReAct: mỗi vòng gồm một đầu ra model, lời gọi công cụ nó kích hoạt và kết quả trả về, có thể gồm nhiều thông điệp. Controller nối bản ghi của vòng này vào một tệp JSONL cục bộ, và chỉ chuyển sang vòng sau sau khi xác nhận toàn bộ vòng đã lưu thành công; nếu lưu thất bại, nó dừng ngay lập tức. Vậy ở phía cục bộ, việc thực thi không bao giờ tiếp tục sang các vòng sau và lưu chúng nếu việc lưu của một vòng đã thất bại. “Đã lưu thành công” ở đây vẫn phải chỉ rõ nó chịu được kiểu lỗi nào: ghi vào bộ đệm trang cục bộ, hoàn thành fsync() cục bộ, hay nhận được xác nhận lưu bền vững của đám mây — các mức này cho những đảm bảo khác nhau. Một tệp cục bộ có thể hỗ trợ phục hồi sau khi tiến trình khởi động lại, nhưng có thể không xử lý được tình huống toàn bộ máy cùng đĩa của nó trở nên không khả dụng.
Để giảm chờ đợi, người ta cũng có thể mỗi vòng trước tiên lưu vào bộ lưu trữ cục bộ, rồi tải các bản ghi mới của vòng đó lên đám mây ở nền. Giả sử một lần tải lên thất bại không được thử lại ngay, cũng không dừng việc thực thi cục bộ: vòng 1 chạy một bài kiểm thử và nhận kết quả thất bại, vòng 2 sửa mã và nhận xác nhận công cụ, vòng 3 chạy lại kiểm thử và nhận kết quả mới. Bản ghi của cả ba vòng đều được ghi cục bộ vào JSONL, nhưng việc tải lên của vòng 2 thất bại trong khi tải lên của vòng 3 thành công (Hình 11-35). Lúc này lịch sử cục bộ là đầy đủ, nhưng đám mây đang thiếu đầu ra model và kết quả công cụ của vòng 2. Nếu sau đó máy cục bộ không khả dụng, và việc phục hồi chỉ dựa vào bản ghi đám mây, khoảng trống này sẽ gặp phải. Nếu thay vào đó mỗi lần tải lên là một snapshot đầy đủ gồm mọi vòng trước đó, hoặc bộ tải lên phải điền các bản ghi đã thất bại trước khi tiếp tục, ví dụ này không còn áp dụng.
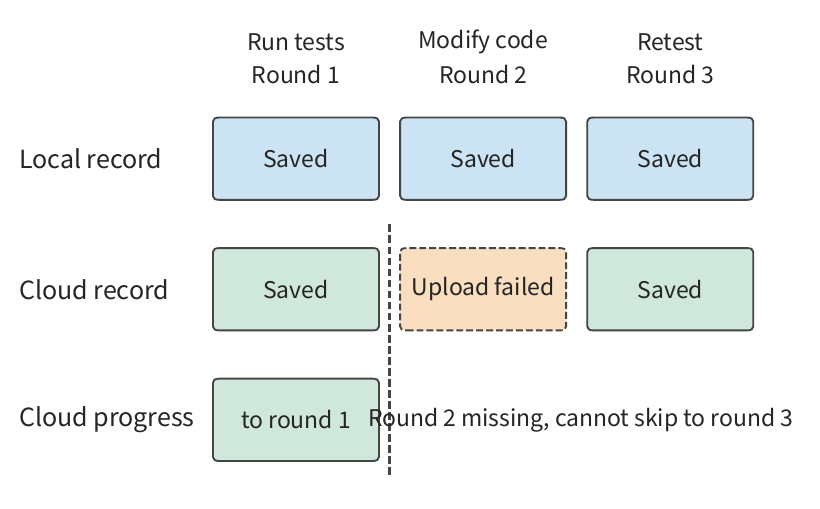
Khi dùng kiểu lưu bất đồng bộ này, controller phải theo dõi riêng tiến độ lưu cục bộ và lưu đám mây. Đám mây phải ghi lại không chỉ vòng cuối cùng nhận được, mà còn mức nó đã được lưu liên tục từ đầu. Việc tải lên của vòng 3 thành công không có nghĩa vị trí lưu liên tục có thể được chuyển từ vòng 1 lên vòng 3; chỉ sau khi điền vòng 2, hoặc dựng lại và kiểm tra dựa trên một bản sao cục bộ đầy đủ, người ta mới có thể xác nhận lịch sử đám mây cũng đầy đủ tới vòng 3.
Điều tương tự áp dụng khi xóa nhật ký cũ. Để xóa bản ghi của hai vòng đầu, người ta phải trước tiên lưu một trạng thái đầy đủ có thể khôi phục tới cuối vòng 2, và gửi trạng thái đó cùng với vòng tương ứng. Trong lúc phục hồi, nếu cả nhật ký đầy đủ sớm hơn lẫn trạng thái này đều không tìm thấy, thì ngay sau khi đọc hết nhật ký còn lại, hệ thống nên trả về incomplete, cho biết không đủ cơ sở để xác nhận lịch sử là đầy đủ. Nếu giao diện cho phép phục hồi tới một vị trí thông điệp cụ thể, nó cũng phải xác nhận vị trí đó có tương ứng với một vòng hoàn chỉnh đã lưu hay không, và kiểm tra phiên bản thư mục làm việc; nếu một vị trí nằm giữa vòng không được lưu riêng, không thể hứa hẹn phục hồi tới điểm đó. Các thao tác đã cam kết với một hệ thống ngoài cũng không bị hoàn tác khi cuộn lại các thông điệp.
Với task sửa mã nguồn trong chương này, ta có thể vay mượn cách tiếp cận của giao dịch cơ sở dữ liệu, coi một vòng gồm “quyết định model — thực thi công cụ — lưu kết quả” là một đơn vị cần cam kết. Chỉ sau khi thông điệp model, kết quả công cụ và phiên bản tệp liên quan của vòng này đều lưu thành công, controller mới ghi lại vòng này là đã cam kết; sau khi khởi động lại, việc thực thi tiếp tục từ kết quả của vòng đã cam kết đầy đủ cuối cùng. Đây cũng là chủ đề được nghiên cứu dưới tên giao dịch agent (agent transactions): làm thế nào để đạt tính nguyên tử, nhất quán, cô lập và bền vững — các thuộc tính ACID từ cơ sở dữ liệu — trong thực thi agent. Nếu thao tác của một vòng cũng gọi một dịch vụ ngoài, dịch vụ đó cần hỗ trợ mã định danh thao tác, giao diện idempotent hoặc xử lý bồi thường; chỉ ghi “đã cam kết” ở cục bộ không thể đảm bảo thao tác ngoài cũng hoàn thành đúng một lần.
Lưu càng thường xuyên, công việc làm lại sau sự cố thường càng ít, nhưng chi phí trong quá trình thực thi bình thường càng lớn. So sánh với một ví dụ làm việc nhỏ: 100 yêu cầu được thực thi tuần tự, mỗi yêu cầu mất 200 ms; mỗi lần cam kết bền vững có chi phí cố định 8 ms, cộng 2 ms cho bản ghi của mỗi yêu cầu. Giả định việc xử lý yêu cầu tạm dừng trong lúc cam kết và bỏ qua các chi phí khác, kết quả như sau.
| Cách lưu | Tổng thời gian lưu | Tổng thời gian không có sự cố | Thời gian tính toán lại tối đa sau sự cố |
|---|---|---|---|
| Cam kết sau mỗi yêu cầu | ms | 21 s | 0,2 s |
| Cam kết mỗi 10 yêu cầu | ms | 20,28 s | 2 s |
Cam kết gộp mỗi 10 yêu cầu tiết kiệm 0,72 s trong thực thi bình thường; nhưng nếu một sự cố xảy ra ngay trước một lần cam kết, 10 yêu cầu đó phải được làm lại, tức 2 s tính toán. Điều này giả định mỗi lần cam kết hoặc thành công hoàn toàn hoặc không có tác động gì, mọi yêu cầu chưa cam kết đều phải làm lại, và công cụ cho phép thử lại an toàn; bảng không gồm thời gian dựng lại môi trường hay lưu lại. Nếu thay vào đó dùng lưu bất đồng bộ, controller có thể xử lý các yêu cầu sau trong khi đồng thời ghi ra những kết quả đã sẵn có. Cần bao nhiêu công việc làm lại sau sự cố phụ thuộc vào số bản ghi chưa được lưu tại thời điểm đó. Vậy khi so sánh các cách lưu, ngoài thời gian hoàn thành task, người ta cũng nên ghi lại số yêu cầu đã trả về nhưng chưa lưu, và kiểm tra chính xác việc phục hồi thực sự có thể tiếp tục từ đâu sau khi khởi động lại.
Ta vẫn cần trả lời hai câu hỏi được đặt đi đặt lại trong suốt cuốn sách này: dữ liệu sống ở đâu, và ai phải chờ nó. Mục 11.2 đã giải phóng môi trường công cụ trong lúc gọi model để tiết kiệm bộ nhớ. Điều này chỉ hợp lệ nếu trạng thái cần cho vòng kế tiếp đã được lưu bên ngoài môi trường, hoặc có thể được tính toán lại sau khi bị mất. Nếu bản sao duy nhất của một kết quả vẫn nằm trong bộ nhớ của môi trường, controller phải chờ nó lưu xong mới giải phóng môi trường, nếu không chỉ có thể làm lại công việc sau khi mất. Vì vậy, khi bộ lập lịch cấp phát tài nguyên, nó cũng phải tính cả thời gian chờ lưu trạng thái và chi phí làm lại sau sự cố.
Một khi đã xác nhận việc thực thi có thể tiếp tục từ đâu, controller cũng có thể chọn chuyển sang một model mạnh hơn. Nếu model ban đầu đã hoàn thành hai vòng, và bản vá cùng kết quả kiểm thử cũng đã được lưu đầy đủ, model mới có thể tiếp tục từ đó mà không cần làm lại hai vòng đầu. Việc này chỉ đòi hỏi trả tiền cho lời gọi model kế tiếp và có thể nâng xác suất thành công. Cơ hội để các sửa chữa sau này thành công lớn đến đâu phụ thuộc vào vì sao lần thử trước thất bại. Vậy ở phần dưới, khi tính xác suất của từng nhánh trong cây phục hồi, chúng ta luôn lấy điều kiện trên việc task đã tới nút đó.
11.5.2 Chi phí đầy đủ của một task thành công
Thử lại sau thất bại hay chuyển sang model khác đều tốn thêm, nên giá của một lời gọi đơn lẻ không thể cho ta biết một task đã hoàn thành thực sự tốn bao nhiêu. Ta nên cộng chi tiêu từ cả các lần thử thành công lẫn thất bại, rồi chia cho số task thực sự hoàn thành. Gọi là tổng chi tiêu trong kỳ đo, là số task đạt yêu cầu chất lượng, và là số task trong đó hoàn thành đúng hạn. Chi phí trung bình mỗi task thành công và mỗi task thành công đúng hạn lúc đó là
Các lần thử thất bại cũng tiêu thụ tài nguyên model và công cụ, và không thể được trừ khỏi tổng chi tiêu. Ví dụ, nếu mười task cùng tốn 1 đô la và năm task thành công, nền tảng thực sự trả 0,2 đô la mỗi lần hoàn thành. Nếu ta chỉ tính 0,5 đô la chi cho năm lần thử thành công, được 0,1 đô la — chính xác một nửa chi tiêu thực tế đã bị bỏ sót.
Chi phí trên mỗi đơn vị này cũng có thể được ước tính trước, trước khi triển khai, dùng một cây thử lại hữu hạn. Với đường , gọi là xác suất đường và là tổng chi phí qua các bước của nó; khi đó . Xác suất thành công là tổng xác suất của mọi đường thành công cuối cùng. Xác suất tại mỗi nút nên được tính dựa trên các kết quả thực thi đã trải qua; nếu tỷ lệ thành công tiếp theo khác nhau giữa hai kiểu thất bại, chúng nên được tách thành các nút riêng.
Ví dụ 11-8: Tác động của sửa chữa cục bộ lên tỷ lệ thành công và phần đạt hạn thời gian. Lấy một ví dụ nhỏ trong đó lần thử đầu tiên mất 10 giây, và so sánh chiến lược phục hồi hữu hạn sau. Lần thử đầu dùng Claude Sonnet 5, với 2.500 token đầu vào và 500 token đầu ra, tốn 0,010 đô la theo định giá tiêu chuẩn và mất 10 giây; 80% thành công trực tiếp, 12% tiến hành sửa chữa cục bộ, và 8% leo thang trực tiếp — tức là thử lại bằng một model có khả năng hơn. Sửa chữa cục bộ vẫn dùng Sonnet 5, với 1.500 token đầu vào và 300 token đầu ra, cộng thêm 0,006 đô la và 4 giây, với tỷ lệ thành công có điều kiện 60%; phần còn lại leo thang. Leo thang chuyển sang Claude Opus 5 (5 đô la mỗi triệu token đầu vào, 25 đô la mỗi triệu token đầu ra), với 3.000 token đầu vào và 600 token đầu ra, cộng thêm 0,030 đô la và 8 giây, với tỷ lệ thành công có điều kiện 98%. Hạn 20 giây chỉ được dùng để đánh giá và không chủ động kết thúc task.
Trong Hình 11-36, khi sửa chữa cục bộ thành công, task kết thúc ở giây 14; khi sửa chữa thất bại rồi leo thang, đường này mất thêm 4 giây so với leo thang trực tiếp. Sau khi tỷ lệ thành công tổng thể được cải thiện, vẫn có một số kết quả thành công vượt hạn, chính xác là vì nhánh thêm này.
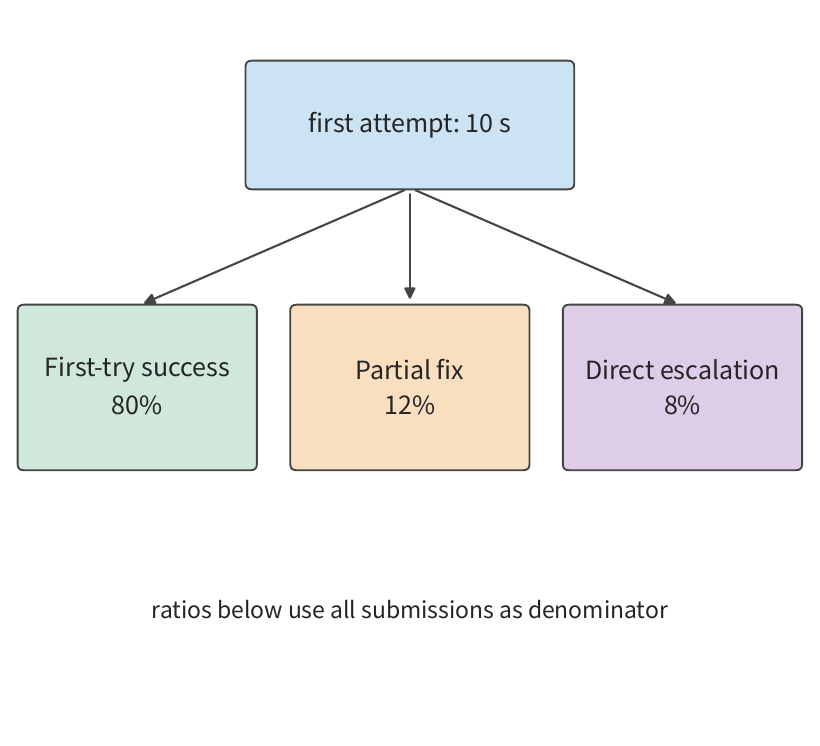
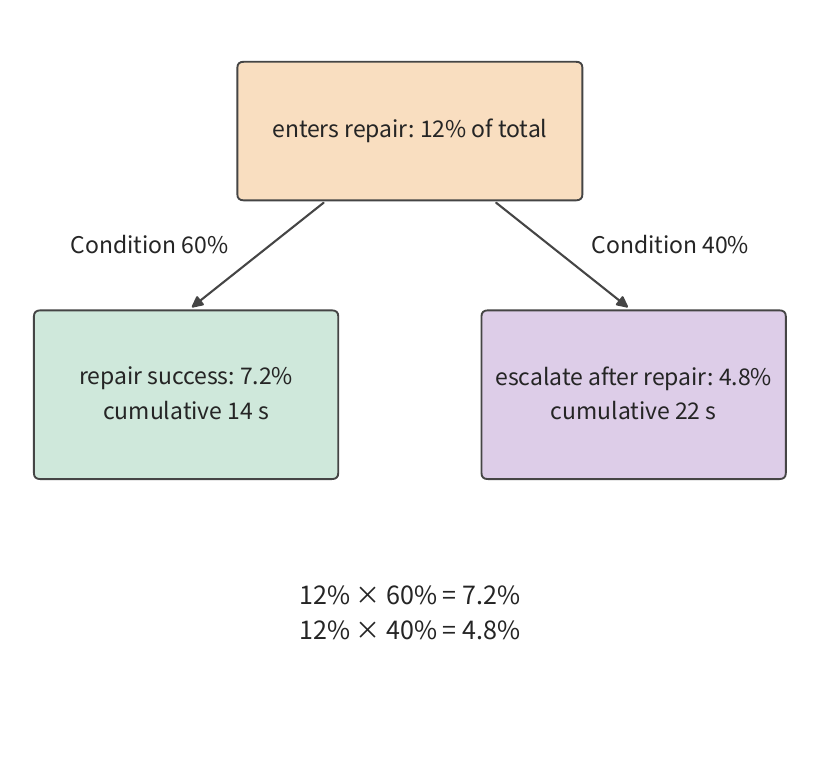
Sáu kết quả thực thi như sau. Chi phí liệt kê trong mỗi hàng là tổng chi phí của toàn bộ quá trình thực thi, gồm chi tiêu từ mọi lần thử trước đó.
| Quá trình và kết quả thực thi | Xác suất | Tổng chi phí / USD | Thời gian / s | Vượt qua kiểm thử và hoàn thành đúng hạn |
|---|---|---|---|---|
| Lần thử đầu thành công | 0,80000 | 0,010 | 10 | Có |
| Lần đầu → sửa chữa thành công | 0,07200 | 0,016 | 14 | Có |
| Lần đầu → sửa chữa → leo thang thành công | 0,04704 | 0,046 | 22 | Không |
| Lần đầu → sửa chữa → leo thang thất bại | 0,00096 | 0,046 | 22 | Không |
| Lần đầu → leo thang thành công | 0,07840 | 0,040 | 18 | Có |
| Lần đầu → leo thang thất bại | 0,00160 | 0,040 | 18 | Không |
Ta có thể tính từng bước trên 1.000 task được gửi đi. Lần thử đầu tốn 10 đô la, và khoảng 800 task thành công trực tiếp. 120 task tiến hành sửa chữa cục bộ, cộng thêm chi phí đô la, trong đó khoảng 72 thành công; khoảng 48 còn lại, cùng với 80 task leo thang trực tiếp, cho 128 lần leo thang, cộng thêm chi phí đô la. Tổng chi phí khoảng 14,6 đô la, với số thành công cuối cùng khoảng 997.
Đường sửa chữa-rồi-leo thang cần giây, vượt hạn 20 giây. Khoảng 47 task vượt qua kiểm thử nhưng vượt hạn, nên số thành công đúng hạn khoảng 950. Chi phí trung bình mỗi task vượt qua kiểm thử khoảng 0,0146 đô la, và mỗi task vượt qua kiểm thử đúng hạn khoảng 0,0153 đô la; chỉ với lần thử đầu tiên, chi phí là đô la, nhưng tỷ lệ thành công chỉ 80%. Phục hồi nâng tỷ lệ hoàn thành và cũng nâng chi phí mỗi lần hoàn thành. Nếu nghiệp vụ yêu cầu ít nhất 95% số lần gửi thành công đúng hạn, khoản đầu tư thêm này là cần thiết; chỉ so sánh chi phí một lần thử sẽ bỏ qua khối lượng hoàn thành mà nó mang lại.
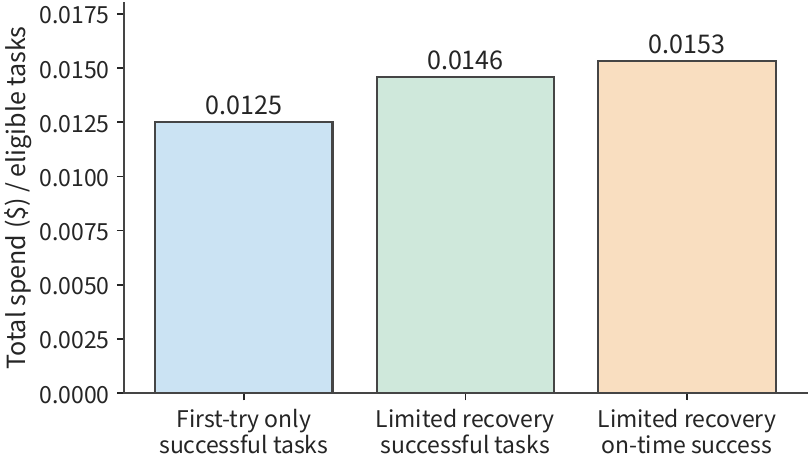
Sau khi áp dụng chiến lược phục hồi trên, tỷ lệ thành công tăng từ 80% lên khoảng 99,7%, nhưng khoảng 4,7% số lần gửi không hoàn thành cho tới giây 22. Khi tính theo hạn 20 giây, các task này tiêu thụ tài nguyên nhưng không thể tính vào số thành công đúng hạn. Nếu ta đơn giản rút ngắn hạn thời gian dùng để đánh giá, quá trình thực thi không đổi — chỉ là ít task được tính là thành công đúng hạn hơn; nếu thay vào đó giới hạn số lần thử lại, controller thực thi ít bước hơn, và cả chi tiêu lẫn tỷ lệ thành công đều thay đổi tương ứng.
Ngoài chiến lược phục hồi, ta cũng phải xét tác động của việc tăng tốc model. Khi model nhanh hơn, việc chuẩn bị môi trường có thể không còn hoàn toàn chồng lấp với lời gọi model, và nó bắt đầu ảnh hưởng tới thời gian hoàn thành task. Giả sử lời gọi công cụ kế tiếp chắc chắn xảy ra: serving nhanh vẫn cần 6 giây để sinh, trong khi tạo môi trường theo đường lạnh — khi template không có ở cục bộ — mất khoảng 2,7 giây; nếu việc tạo môi trường bắt đầu khi model bắt đầu sinh, phần chuẩn bị 2,7 giây này chồng lấp hoàn toàn với việc sinh của model. Nếu giai đoạn model rút ngắn xuống 1 giây, bắt đầu tạo ở cùng thời điểm vẫn để lại khoảng 1,7 giây chờ đợi. Trước tiên chỉ tăng tốc lời gọi model trong khi giữ nguyên chiến lược chuẩn bị; rồi so sánh chi phí của ba cách tiếp cận — chuẩn bị sớm hơn, giữ môi trường đã sẵn sàng, và chờ theo nhu cầu — tính cả tài nguyên bị chiếm bởi việc chuẩn bị sớm lẫn chi phí khi một môi trường chuẩn bị trước cuối cùng không được dùng đến.
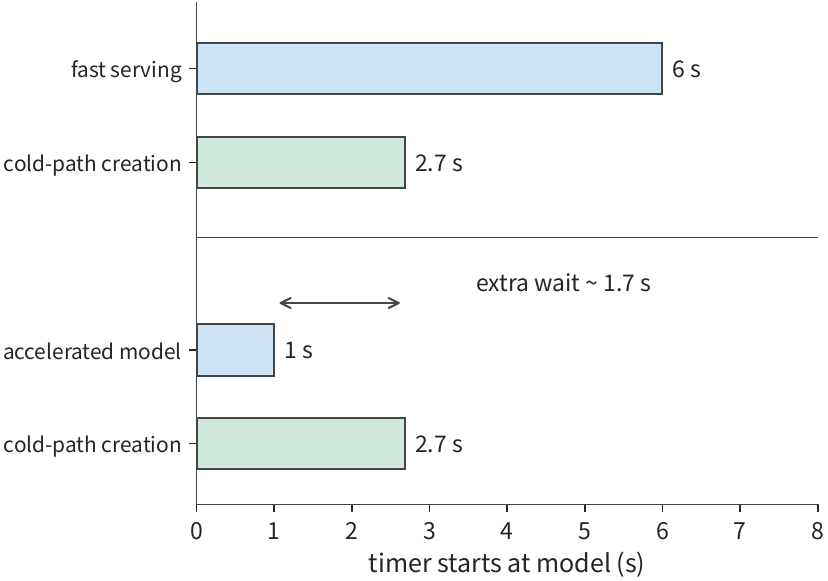
Cái phải được dựng lại trong lúc phục hồi không chỉ là môi trường công cụ mà còn cả trạng thái phía serving model. Ví dụ thiết kế của chương này dùng thời gian và chi phí tính toán của V4-Flash; tuy nhiên, việc phục hồi trạng thái phía model được minh họa bằng phiên V4.1 Flash được theo dõi xuyên suốt cuốn sách, vì KV toàn cục của nó có thể được lấy ra, trong khi trạng thái SWA cục bộ phải được dựng lại bằng cách phát lại các token ở cuối prompt (Mục 3.2.4) — hai phần đi theo các đường phục hồi khác nhau. Một phiên như vậy, trong lúc chờ công cụ, giữ đồng thời hai bộ trạng thái: hệ điều hành quản lý các tiến trình, tệp và môi trường, còn dịch vụ model quản lý KV toàn cục và trạng thái SWA cục bộ. Việc phục hồi task đòi hỏi chuẩn bị riêng hai bộ trạng thái này, rồi hợp nhất chúng khi kết quả công cụ đi vào vòng gọi model kế tiếp; các thao tác ngoài đã thực thi được xác nhận bằng cách truy vấn hệ thống đích. Khi việc chuẩn bị môi trường và việc lấy KV có thể tiến hành song song, bên nào hoàn thành muộn hơn quyết định thời gian chờ cần cho việc phục hồi.
11.5.3 Lựa chọn mở rộng quy mô cho CPU, GPU, bộ nhớ và hạn mức dịch vụ
Dưới đây, dựa trên hạn hoàn thành 24 giây đặt ra ở đầu chương, chúng ta chọn một sơ đồ cho serving model và quản lý môi trường. Ta đã thu được ba kết quả: serving thông thường mất 9 giây mỗi lời gọi, 30 giây cho ba vòng; serving nhanh mất 6 giây mỗi lời gọi, 21 giây cho ba vòng; dựng lại môi trường mỗi vòng giảm dấu chân bộ nhớ môi trường tích lũy mỗi task xuống 18 GiB-giây, với việc chuẩn bị tốn thêm 0,3 giây thời gian CPU.
Ví dụ 11-9: Nên chọn cách serving model và quản lý môi trường nào để hoàn thành đúng hạn với chi phí thấp nhất? Ta tiếp tục với các điều kiện ở đầu chương: một task đến mỗi 0,1 giây, mỗi task thực thi ba vòng; nền tảng công cụ là m5d.metal 48 nhân với khoảng 358 GiB bộ nhớ, và dịch vụ model hiện có 10 replica V4-Flash (40 thẻ B200). Cả hai chế độ serving chạy cùng một model, đều đạt xác suất vượt qua kiểm thử 95%, và việc task có vượt qua kiểm thử hay không độc lập với thời điểm đến của nó. Lời gọi model được tính phí theo thời gian B200 tiêu thụ mỗi lời gọi, ở mức 6,79 đô la mỗi thẻ-giờ: serving thông thường dùng 1,125 B200-giây mỗi lời gọi, khoảng 0,00212 đô la; serving nhanh dùng 1,5 B200-giây mỗi lời gọi, khoảng 0,00283 đô la. CPU và bộ nhớ được tính phí theo mức giá sandbox công bố của E2B — 0,000014 đô la mỗi CPU-giây và 0,0000045 đô la mỗi GiB-giây — đều tính từ mức sử dụng thực tế. Chi phí lưu bền vững tệp đã nằm trong mỗi vòng thực thi công cụ; chi tiêu cố định dùng chung của nền tảng là như nhau ở cả bốn sơ đồ.
Trước tiên, ta loại trừ “chỉ thêm CPU”. Ba vòng công cụ gộp lại mất 3 giây; dù tăng gấp đôi tốc độ công cụ, serving thông thường vẫn cần giây; đưa thời gian công cụ về không vẫn để lại 27 giây lời gọi model. Tăng CPU không thể rút ngắn đường tuần tự này xuống dưới 24 giây.
Kế tiếp, so sánh các chiến lược môi trường. Công việc chuẩn bị để dựng lại môi trường mỗi vòng chồng lấp với các lời gọi model, nên nó không làm thay đổi thời gian hoàn thành: serving thông thường vẫn ở 30 giây, còn chuyển sang serving nhanh giảm tổng thời gian model xuống 18 giây, cộng 3 giây thời gian công cụ, cho tổng cộng 21 giây. Vậy dưới serving nhanh, cả luôn thường trú lẫn dựng lại mỗi vòng đều thỏa hạn thời gian, và ta cần so sánh thêm tài nguyên và chi phí.
Hình 11-40 trước tiên lọc các sơ đồ theo hạn thời gian: vòng cuối của model thông thường kết thúc sau hạn, còn cả ba vòng của model nhanh kết thúc trong hạn. Ta sau đó chỉ cần so sánh chi phí giữa hai chiến lược môi trường dưới model nhanh, đồng thời kiểm tra xem dung lượng nền tảng có bị vượt hay không.
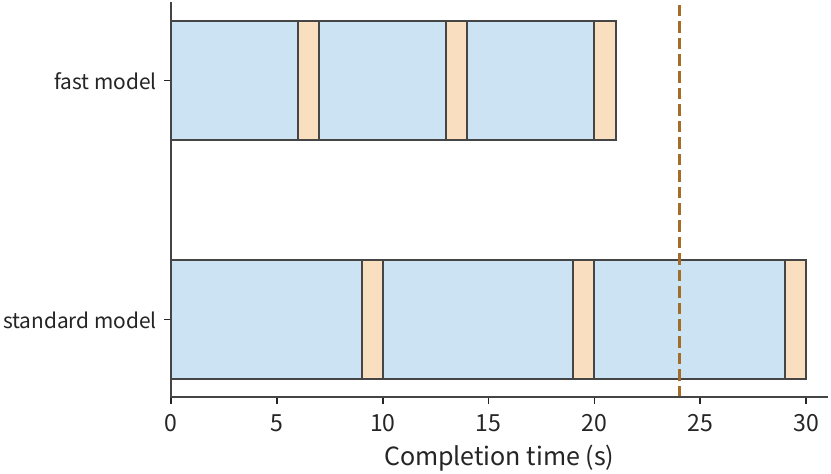
| Sơ đồ | Thời gian hoàn thành / s | Thời gian CPU tích lũy / CPU·s | Dấu chân bộ nhớ tích lũy mỗi task / GiB·s | Bộ nhớ trung bình / GiB | Chi phí mỗi 1.000 lần gửi / USD | Tỷ lệ vượt qua kiểm thử đúng hạn |
|---|---|---|---|---|---|---|
| Serving thông thường + luôn thường trú | 30 | 3 | 60 | 600 | 6,68 | 0 |
| Serving thông thường + dựng lại mỗi vòng | 30 | 3,3 | 18 | 180 | 6,49 | 0 |
| Serving nhanh + luôn thường trú | 21 | 3 | 42 | 420 | 8,72 | 95% |
| Serving nhanh + dựng lại mỗi vòng | 21 | 3,3 | 18 | 180 | 8,61 | 95% |
Lấy hàng cuối làm ví dụ, ba lời gọi model cùng tiêu thụ B200-giây, tốn khoảng 0,0084875 đô la; chi phí CPU là đô la, chi phí bộ nhớ là đô la, tổng cộng khoảng 0,0086147 đô la — tức 8,61 đô la mỗi 1.000 task. Chi phí model chiếm hơn 98%, nên lợi ích chính của việc dựng lại môi trường mỗi vòng không nằm ở chi phí mà ở dung lượng. Với 10 task vào mỗi giây, thực thi công cụ và chuẩn bị môi trường cùng nhau dùng trung bình 33 nhân CPU và 180 GiB bộ nhớ — đều trong dung lượng của m5d.metal; ngược lại, serving nhanh + luôn thường trú sẽ cần 420 GiB, mức máy chủ này không thể chứa. Ở phía serving model, trung bình 180 lời gọi đang được xử lý đồng thời; serving nhanh chỉ cho 16 phiên mỗi replica, đòi hỏi 12 replica — nhiều hơn 2 so với hiện có.
Nhu cầu trung bình của sơ đồ đã chọn thỏa mãn yêu cầu dung lượng, nhưng ta vẫn phải xác nhận từng giai đoạn có thể được lập lịch đúng hạn. Vì task đến đều đặn, ta có thể viết trực tiếp một lịch biểu thỏa mãn ràng buộc dung lượng. Dưới serving nhanh, lấy thời điểm đến của mỗi task làm gốc, việc chuẩn bị môi trường diễn ra trong các giây 4–6, 11–13 và 18–20, còn thực thi công cụ chạy trong các giây 6–7, 13–14 và 20–21; công việc chuẩn bị dùng tích lũy 0,1 CPU-giây, trải đều trong cửa sổ hai giây. Với một task đến mỗi 0,1 giây, khi đã chạy ổn định, thực thi công cụ của mỗi vòng chiếm 10 nhân, và việc chuẩn bị mỗi vòng chiếm một nhân; có nhiều nhất khoảng 90 môi trường đang hoạt động, tổng cộng 180 GiB. Mỗi giai đoạn trong ba giai đoạn gọi model có trung bình 60 lời gọi đang được xử lý đồng thời, gộp lại 180 lời gọi đồng thời, trong khi 12 replica nhanh cung cấp 192 slot đồng thời. Thực thi theo lịch biểu này đồng thời thỏa mãn các phụ thuộc tuần tự giữa các giai đoạn và nằm trong dung lượng nền tảng.
Vì vậy, chúng ta chọn serving nhanh kết hợp dựng lại môi trường mỗi vòng, hoàn thành việc chuẩn bị trong lúc gọi model, và tăng số replica model từ 10 lên 12. Sơ đồ này thỏa mãn yêu cầu 24 giây dùng máy chủ công cụ hiện có, và là sơ đồ duy nhất trong bốn sơ đồ vừa hoàn thành đúng hạn vừa nằm trong dung lượng của máy chủ này. Chi phí trung bình mỗi 1.000 task vượt qua kiểm thử đúng hạn khoảng đô la; serving nhanh + luôn thường trú, dù có cấp thêm bộ nhớ, sẽ tốn khoảng đô la — dựng lại môi trường mỗi vòng hạ chi phí này chỉ khoảng 1,2%. Serving thông thường + dựng lại mỗi vòng rẻ hơn, nhưng ngay cả khi vượt qua kiểm thử, nó đã vượt hạn.
Mục 11.5.2 cũng chỉ ra rằng thêm thử lại làm thay đổi tỷ lệ hoàn thành đúng hạn. Ở đây, task bình thường hoàn thành ở giây 21, chỉ còn lại 3 giây dự phòng; nếu sau khi thất bại cuối cùng, ta thêm một lần sửa chữa cục bộ 4 giây, kết quả sẽ không xuất hiện cho tới giây 25. Vậy ví dụ này kết thúc task sau ba vòng; các task thất bại kiểm thử trực tiếp trả về kết quả thất bại. Nếu nghiệp vụ kéo dài hạn tới 25 giây, sửa chữa cục bộ lúc đó sẽ có chỗ để tăng số thành công đúng hạn, và tại thời điểm đó xác suất thành công có điều kiện cùng tài nguyên thêm vào cần được đưa vào cây phục hồi.
Lựa chọn trên dựa vào điều kiện lời gọi model mất 6 giây mỗi vòng. Khi model tiếp tục được tăng tốc, cửa sổ nhàn rỗi trong đó bộ nhớ môi trường có thể được giải phóng cũng co lại, đòi hỏi phải xem xét lại chiến lược môi trường. Giữ môi trường hay dựng lại nó có thể được đánh giá bằng độ dài chờ đợi tại đó chi phí của hai sơ đồ bằng nhau. Gọi giây là thời gian chờ cần giữa hai lần thực thi công cụ do model gây ra. Giữ một môi trường 2 GiB thường trú tốn đô la; hủy nó và chuẩn bị lại vào cuối lời gọi model kế tiếp tốn đô la bộ nhớ cộng đô la CPU cho việc chuẩn bị, tổng cộng 0,0000194 đô la. Hai bên bằng nhau tại giây. Khi thời gian chờ là 6 giây, dựng lại là đáng chọn; khi nó rút ngắn xuống 2 giây, giữ môi trường trở nên tiết kiệm hơn, với việc chuẩn bị lấp đầy toàn bộ cửa sổ có thể chồng lấp. Khi model tiếp tục được tăng tốc, chiến lược môi trường phù hợp nhất sẽ liên tục thay đổi.
Ta cũng có thể dùng định luật Amdahl từ Chương 1 để tóm tắt tác động của việc tăng tốc cục bộ lên tổng thời gian. Gọi là phần thời gian ban đầu có thể được tăng tốc, và giả sử phần đó được làm nhanh gấp lần trong khi phần còn lại giữ thời lượng ban đầu; mức tăng tốc tổng thể khi đó là
Ở đầu chương, công cụ chỉ chiếm 10% thời gian, nên nhân đôi tốc độ công cụ cho mức tăng tốc tổng thể ; lời gọi model chiếm 90%, nên nhân đôi tốc độ của toàn bộ lời gọi cho . Với cùng mức nhân đôi, tăng tốc lời gọi model tiết kiệm nhiều thời gian task hơn, vì nó chiếm tỷ trọng lớn hơn trong thời gian thực thi.
Chương 12 sẽ so sánh thêm việc thực thi trên thiết bị biên, máy chủ biên và đám mây dưới cùng một mục tiêu task và hoàn thành, phân tích tác động của thời gian truyền lên thời gian hoàn thành task.
Bài tập và thí nghiệm
Các bài tập sau tiếp nối đánh số của các tài liệu 11-1 tới 11-10. Các bài tập cốt lõi 11-1, 11-2 và 11-10 tạo thành một chuỗi hoàn chỉnh từ yêu cầu tới thiết kế; bản ghi thí nghiệm thô và các điểm vào chạy tùy chọn nằm trong tài liệu kèm của chương này.
-
Thí nghiệm 11-1 [Cốt lõi]: Suy ra độ đồng thời model, CPU và bộ nhớ môi trường từ các task nhiều vòng. Nền tảng nhận 8 task mỗi giây, một nửa thực thi hai vòng và một nửa thực thi bốn vòng. Mỗi vòng gọi model mất 6 giây, và công cụ chiếm một nhân CPU trong 1 giây. Tìm tốc độ gọi model, số lời gọi model đồng thời trung bình và số nhân CPU trung bình được dùng. Nếu mỗi môi trường chiếm 2 GiB suốt task, tìm dấu chân bộ nhớ môi trường trung bình của nền tảng. Giờ giả sử môi trường chỉ được giữ trong pha chuẩn bị 2 giây và pha thực thi công cụ 1 giây của mỗi vòng; tính lại dấu chân bộ nhớ trung bình và số môi trường phải được tạo mỗi giây.
-
Thí nghiệm 11-2 [Cốt lõi]: Việc dựng lại môi trường và phục hồi snapshot ảnh hưởng thế nào tới thời gian chờ công cụ và thời lượng chiếm bộ nhớ? Một môi trường chứa các phụ thuộc có thể tải lại, các bộ đệm chỉnh sửa chưa lưu, các bản vá đã lưu bền vững và các ghi ngoài đã cam kết. Với mỗi loại, giải thích thứ gì có thể được phục hồi sau sự cố và thứ gì không thể phục hồi trực tiếp.
Rồi so sánh hai sơ đồ có thể khôi phục trạng thái cần cho vòng kế tiếp: một lần dựng lại môi trường đầy đủ theo đường lạnh mất 2,7 giây; theo tài liệu của E2B, lưu snapshot của một môi trường 2 GiB mất khoảng 8 giây, và khôi phục từ snapshot mất khoảng 1 giây. Lấy thời điểm kết thúc thực thi công cụ của vòng trước làm gốc thời gian. Lời gọi model kế tiếp bắt đầu ngay lập tức, mất 9 giây, theo sau là 1 giây thực thi công cụ. Dưới sơ đồ dựng lại, giải phóng môi trường ban đầu tại gốc thời gian; dưới sơ đồ snapshot, bắt đầu lưu snapshot tại gốc đó và giải phóng môi trường ban đầu một khi việc lưu hoàn tất.
Cả hai sơ đồ nên bắt đầu dựng lại hoặc khôi phục càng muộn càng tốt mà không trì hoãn lần thực thi công cụ kế tiếp. Vẽ một dòng thời gian, và tính thời lượng chiếm bộ nhớ môi trường tích lũy của mỗi sơ đồ từ gốc thời gian tới khi hoàn thành lần thực thi công cụ kế tiếp. Dựng lại, lưu snapshot, khôi phục và thực thi công cụ đều phải được tính vào thời gian trú môi trường.
-
Thí nghiệm 11-3: Chuẩn bị môi trường trước tiết kiệm bao nhiêu thời gian chờ, và tiêu thụ bao nhiêu bộ nhớ? Tạo một môi trường mất 2 giây, và độ chính xác dự đoán cho môi trường cần bởi lời gọi kế tiếp là 0,6. Khi một lời gọi đến, hủy bất kỳ môi trường nào tương ứng với kết quả dự đoán sai; mỗi môi trường chuẩn bị trước chiếm 2 GiB kể từ khi việc chuẩn bị bắt đầu. Bắt đầu chuẩn bị lần lượt 1, 2 và 4 giây trước khi lời gọi đến, và tính thời gian chờ dự kiến sau khi lời gọi đến, cũng như dấu chân bộ nhớ tích lũy dự kiến (tính bằng GiB-giây) do các dự đoán sai gây ra. Khi dự đoán sai, tạo lại môi trường cần thiết sau khi lời gọi đến. Nếu độ chính xác cải thiện lên 0,9, lợi ích nào lớn hơn, và lãng phí nào giảm bớt?
-
Thí nghiệm 11-4: Khi nào di chuyển vượt trội hơn chờ đợi dưới các mục tiêu hoàn thành công việc khác nhau? Các tài nguyên mà một công việc mới cần hiện đang bị một công việc hiện hữu chiếm giữ; chờ giải phóng mất 12 giây. Một khi công việc mới giành được tài nguyên, thực thi cục bộ mất 20 giây. Ngoài ra, công việc hiện hữu có thể được di chuyển sang một nút khác, giải phóng tài nguyên cục bộ khi di chuyển hoàn tất; di chuyển mất một khoảng thời gian chưa biết , làm trễ việc hoàn thành của công việc hiện hữu thêm giây so với việc không di chuyển. Trước tiên, với mục tiêu công việc mới kết thúc sớm nhất, tìm điều kiện để di chuyển thắng chờ đợi; rồi, với mục tiêu cực tiểu hóa tổng thời gian chờ tài nguyên của công việc mới và độ trễ hoàn thành của công việc hiện hữu, giải lại. Giải thích vì sao hai mục tiêu có thể dẫn tới các lựa chọn khác nhau.
-
Thí nghiệm 11-5: Thời gian khởi động ảnh hưởng thế nào tới đầu ra hiệu quả của các thể hiện ngắn hạn? Mỗi thể hiện mới cần tổng cộng 8 giây cho truyền và nạp, sau đó làm việc với tốc độ 100 token hiệu quả mỗi giây. Ba thể hiện có vòng đời, tính từ khi khởi động tới khi bị thu hồi, lần lượt 10, 20 và 40 giây. Tìm đầu ra của mỗi thể hiện và phần vòng đời thực sự dành để làm việc. Nếu thời gian chuẩn bị giảm xuống 4 giây, so sánh mức cải thiện đầu ra của từng thể hiện trong ba thể hiện, và giải thích vì sao các thể hiện có thời gian khả dụng ngắn hơn nhạy cảm hơn.
-
Thí nghiệm 11-6: Số tiến trình xác minh và các mẫu đuôi dài quyết định thời gian hoàn thành đợt như thế nào? Ba mẫu đến ở các giây 0, 6 và 12, cần lần lượt 10, 2 và 8 giây xác minh. Trước tiên tìm thời điểm bắt đầu và hoàn thành của mỗi mẫu khi được xử lý theo thứ tự đến với một tiến trình thực thi duy nhất; rồi tìm thời điểm toàn đợt kết thúc sớm nhất với hai tiến trình thực thi. Đổi thời gian xác minh của mẫu cuối thành 80 giây, và xác định việc thêm tiến trình thực thi có thể rút ngắn tổng thời gian hoàn thành đợt hay không, giải thích mẫu nào quyết định kết quả này.
-
Thí nghiệm 11-7: Tính chi phí và tỷ lệ thành công đúng hạn khi việc trúng bộ nhớ đệm tương quan với độ chính xác. Tiếp tục với chi phí của Dịch vụ B trong Ví dụ 11-7, nhưng đổi tỷ lệ thành công thành 99% khi trúng và 90% khi trượt. Suy ra quan hệ giữa chi phí trung bình mỗi task thành công và tỷ lệ trúng, cũng như phần task vượt qua kiểm thử trong 6 giây. Tìm tỷ lệ trúng tối thiểu cần để ít nhất 90% task vượt qua kiểm thử đúng hạn, và so sánh với mô hình xác suất độc lập ban đầu.
-
Thí nghiệm 11-8: Điểm giao nhau của chi phí task thành công giữa tự lưu trữ và serving API. Cách tự lưu trữ dành riêng 4 thẻ B200 một tháng theo giá Runpod, tổng cộng 19.555,2 đô la, chạy V4-Flash, không có chi phí thêm mỗi task và tỷ lệ thành công task 90%; cách API dùng Claude Sonnet 5, gọi nó ba lần mỗi task, mỗi lời gọi tốn bằng Dịch vụ B khi trúng trong Ví dụ 11-7 — 0,0088 đô la — với tỷ lệ thành công 98%. Dùng một tháng làm kỳ so sánh chi phí, mọi chi tiêu cố định được phân bổ cho tháng đó. Cả hai đều có đủ dung lượng để đáp ứng hạn thời gian và xử lý cùng số task; tìm khối lượng task tại đó chi phí task thành công trung bình của chúng bằng nhau. Rồi đặt trần xử lý của phía tự lưu trữ ở 500.000 task mỗi tháng, và thảo luận điểm giao nhau ảnh hưởng thế nào tới quyết định mua sắm.
-
Thí nghiệm 11-9: Hạn thời gian task và việc dừng sớm thay đổi chi phí thử lại và tỷ lệ thành công như thế nào? Tiếp tục với Ví dụ 11-8, đổi hạn thời gian lần lượt thành 14, 18 và 22 giây, và tìm phần vượt qua kiểm thử đúng hạn cho mỗi mức. Rồi thiết kế một chiến lược dừng khi thời gian còn lại không đủ để hoàn thành nút kế tiếp, tính lại chi phí dự kiến, và giải thích nó khác với việc chỉ thay đổi hạn đánh giá như thế nào.
-
Thí nghiệm 11-10 [Cốt lõi]: Cách mở rộng quy mô và chọn chiến lược trú môi trường sau khi tốc độ đến tăng. Tiếp tục với Ví dụ 11-9, tăng tốc độ đến lên 15 task mỗi giây, với mỗi lời gọi giờ chỉ xuất ra 118 token, giảm thời gian lời gọi của serving nhanh xuống khoảng 2,0 giây; mỗi task vẫn thực thi ba vòng, và thực thi công cụ mỗi vòng vẫn mất 1 giây. Máy chủ công cụ, số phiên mỗi replica và mọi đơn giá vẫn không đổi. So sánh luôn thường trú với việc dựng lại môi trường mỗi vòng, quyết định tài nguyên nào nên được tăng và tăng tối thiểu bao nhiêu, và giải thích chiến lược môi trường có cần thay đổi hay không. Cuối cùng, đổi mô hình đến sao cho 15 task đến đồng thời mỗi giây, vẽ một dòng thời gian thực thi công cụ, và đánh dấu đỉnh chiếm CPU đồng thời.
Chú thích nguồn
- Phép tính cố định tài nguyên môi trường và bản ghi tiến trình con của công cụ trong cuốn sách này. Các thí nghiệm về công cụ gồm chín nhóm và 36 tiến trình; diện tích bộ nhớ tích lũy được tính bằng cách lấy tích phân RSS được lấy mẫu theo thời gian.
- Ngân sách cố định vòng đời môi trường phân biệt dung lượng dành riêng/dùng chung, cận dưới của thời gian truyền nối tiếp và thời gian làm ấm cục bộ đo được. Chương này dùng một ngân sách dung lượng cố định để so sánh bốn cách tiếp cận nạp nội dung.
- Nghiên cứu về lập lịch, định tuyến model và môi trường đám mây, bao gồm ASI, RLBoost, DistRS và SpecBox. Nghiên cứu ASI bao phủ sáu tháng và 155.410 GPU, với tỷ lệ phân bổ của nó đo lường quyền sở hữu thiết bị. Đơn giá token được lấy từ ảnh chụp trang giá API Claude.
- Kiến trúc cố định E2B, tài liệu về duy trì trạng thái (tạm dừng mất khoảng 4 giây mỗi GiB bộ nhớ, tiếp tục mất khoảng 1 giây, và việc tạm dừng chỉ lưu hệ thống tệp), kiểm tra hành vi giao diện tạm dừng/snapshot. E2B dùng Firecracker.
- Ảo hóa thiết bị và các đường phân phối trong Thiết kế tham chiếu Hệ điều hành UB, được dùng làm minh họa triển khai cho QEMU/VFIO; tài liệu này mô tả một cấu hình VM hỗ trợ chuyển thẳng thiết bị.
- Phát lại quá trình làm ấm công cụ cục bộ. Các lời gọi thực tế, các lần trúng dự đoán và ranh giới cửa sổ lấy mẫu được giữ nguyên trong các bản ghi gốc.
- DRF, Gavel và Pollux làm nền tảng về cơ chế lập lịch; việc chia sẻ và bố trí tài nguyên bổ sung sự phân biệt giữa tính sẵn sàng của tài nguyên và việc bàn giao trạng thái.
- Khảo sát về chuẩn bị trọng số và đầu ra hiệu quả, ghi lại các điều kiện của bài báo RLBoost và đường nguồn cố định của PolyRL. Số byte trọng số của Qwen3-8B được lấy từ chỉ mục safetensors; NIC biên 200/50 Gbit/s và giá thể hiện được lấy từ bài báo RLBoost.
- Thí nghiệm khôi phục sau khi bị thu hồi của Qwen3-8B, ghi riêng số token dùng cho việc sinh, nhận từ máy khách và khôi phục.
- Phân tích lập lịch xác minh DistRS và cách triển khai verl.
- Thí nghiệm hết thời gian chờ và giải phóng tài nguyên, bản ghi lập lịch theo lô kép. Các thí nghiệm dùng các tiến trình CPU có kiểm soát.
- Bản ghi ngân sách suy nghĩ và chất lượng, các kiểm tra sau khi tăng ngân sách suy nghĩ. Các bản ghi kiểm tra riêng việc sinh có kết thúc tự nhiên và trạng thái đầu vào có đáp ứng yêu cầu.
- Các kết quả cố định chi phí định tuyến, kết quả điểm giao nhau và phần suy luận đầy đủ. Đơn giá của Haiku 4.5 và Sonnet 5 được lấy từ ảnh chụp trang giá API Claude; phép tính dùng xác suất vượt chấp nhận độc lập với việc trúng bộ nhớ đệm, với số task thành công được tính từ xác suất đã cho.
- Giá B200 Pod là 6,79 đô la mỗi giờ-thẻ và giá Serverless là 8,64 đô la mỗi giờ-thẻ, lấy từ ảnh chụp trang giá Runpod. Kết quả tính được là 25,317 ms, trong đó decode là 15,918 ms và các giai đoạn còn lại gộp lại là 9,399 ms. Ở đây, chi phí chung cố định mỗi lớp và việc xây dựng lại định kỳ toàn phần được coi là các đầu vào đã cho; xem đường cơ sở so sánh serving agent liên tục, đánh giá tối ưu hóa và quy kết thời gian và độ nhạy để biết chi tiết.
- Bản ghi task và phạm vi bằng chứng, chèn lỗi hàng đợi tệp, bản ghi trạng thái thoát của task. Các bản ghi này lần lượt được dùng để minh họa việc duy trì kết quả, chẩn đoán lỗi và hạch toán chi phí.
- Trang hướng dẫn Linux write(2) và fsync(2). Một
write()thành công không đảm bảo dữ liệu đã tới bộ lưu trữ bền vững; người gọi cũng phải kiểm tra số byte thực sự được ghi và mọi lỗi đồng bộ hóa. Khi tạo hoặc đổi tên tệp, việc duy trì mục thư mục cũng có thể cầnfsync()trên chính thư mục; đồng bộ hóa tệp đơn lẻ không mang lại bảo đảm giao dịch đa tệp. - Safe to Resume? (2026, bản in trước) phân tích vấn đề không nhất quán giữa trạng thái khôi phục và các phụ thuộc cần thiết để tiếp tục thực thi. Các con số về khe hở yêu cầu và gửi theo lô trong phần này là một ví dụ giảng dạy, không phải kết quả đo được trong bài báo.
- Agentic Transaction (2026, bản in trước) đề xuất tính nguyên tử, nhất quán, cô lập và bền vững theo ngữ nghĩa hướng đến agent; mục §2.2.4 của nó thảo luận về lưu trữ bền vững của trạng thái đã cam kết, bằng chứng và siêu dữ liệu phục hồi. Phần này dùng việc sửa mã để minh họa thiết kế một đơn vị cam kết, và không suy ra từ đó rằng các lời gọi công cụ tùy ý mang bảo đảm ACID.
- Các kết quả chính xác: xác suất thành công 0,99744, xác suất vượt qua kiểm thử và hoàn thành đúng hạn 0,9504, chi phí dự kiến mỗi task 0,01456 đô la, thời gian CPU tích lũy 3,376 giây, thời gian trú 23,008 GiB-giây. Các kết quả tính liệt kê riêng việc sử dụng tài nguyên và chi phí; chi phí đã cho tại mỗi nút vốn đã là một tổng giá và không bị tính phí lại theo mức sử dụng tài nguyên. Xem đồ thị hữu hạn có điều kiện các đường thử lại. Chi phí tại mỗi nút được tính từ định giá chuẩn của Claude và số token cho trong bài toán; các xác suất như đã cho trong bài toán, và các lần thử lại mở ra dọc theo một cây thực thi hữu hạn; các task vượt quá hạn đánh giá vẫn tiếp tục thực thi cho tới khi hoàn thành.
- Các đầu vào cho nền tảng đang chạy và Ví dụ 11-9, bảng thời gian theo giai đoạn, chi phí, điều kiện chi phí bằng nhau và phép tính lại xuất hiện trong dữ liệu thiết kế đang chạy và chương trình xác minh. Thời gian gọi model lấy từ ước tính của cuốn sách khi chạy DeepSeek V4-Flash trên 4 thẻ B200 với ngữ cảnh 200K mỗi phiên: 25,3 ms mỗi token đầu ra với 32 phiên mỗi replica, 16,9 ms với 16 phiên, cả hai đều gồm xử lý đầu vào trả góp và tái tạo ngữ cảnh (kết quả so sánh, dữ liệu đầy đủ); một lời gọi 355 token mất khoảng 8,99 s và 6,01 s tương ứng, và thiết kế làm tròn các giá trị này thành 9 s và 6 s. Chi phí thẻ B200 là 6,79 đô la mỗi giờ-thẻ, lấy từ ảnh chụp trang giá Runpod. 48 lõi (đã tắt siêu phân luồng) và bộ nhớ 384 GB của m5d.metal lấy từ môi trường đánh giá trong mục 5 của bài báo Firecracker; quy cách 1 vCPU, 2 GiB và đơn giá CPU và bộ nhớ lấy từ ảnh chụp trang giá E2B. 2 giây và 0,1 giây-CPU cho việc chuẩn bị đường nóng cùng tỷ lệ vượt chấp nhận 95% là các giả định đã cho; việc lưu kết quả và dọn dẹp trạng thái làm việc nằm trong 1 giây của công cụ. Ví dụ về dung lượng template bao gồm riêng việc nạp nội dung.
- Quy cách hệ thống DGX H100 (hai Xeon Platinum 8480C, tổng cộng 112 lõi); quy cách hệ thống DGX A100 (Phụ lục A, Bảng 10, hai EPYC 7742, tổng cộng 128 lõi).
- Agache và cộng sự, AWS, Firecracker: Ảo hóa nhẹ cho các ứng dụng serverless, NSDI 2020.
- Phép tính lại theo từng khoản mục và chương trình tính toán cho các so sánh có điều kiện trong chương này.
- Báo cáo kỹ thuật chính thức DeepSeek V4.1, các phần 1, 2, 3 và 6; các điều kiện cố định và phép tính lại cho phiên chạy xuyên chương.
Tóm tắt chương
Nền tảng ở đầu chương chỉ dùng trung bình 30 lõi CPU, vậy mà môi trường cần 600 GiB bộ nhớ, vượt quá 358 GiB của m5d.metal. Nguyên nhân là 27 giây trong task ba vòng được dành để chờ model, trong khi môi trường công cụ chiếm bộ nhớ suốt thời gian đó. Chuẩn bị môi trường trong lúc gọi model giảm diện tích bộ nhớ tích lũy mỗi task từ 60 xuống 18 GiB-giây, giải phóng một lượng lớn bộ nhớ; cái giá chỉ là thêm 0,3 giây CPU để chuẩn bị.
Sự cải thiện này khai thác các quan hệ thực thi của toàn bộ task. Một khi bộ quản lý môi trường xác định được còn bao nhiêu thời gian dành cho việc chuẩn bị trong lúc gọi model, nó có thể tạo môi trường từ trước, để tiến trình chỉ tồn tại trong lúc chuẩn bị và thực thi công cụ; các tệp bền vững giữ lại trạng thái phải được giữ giữa các vòng. Dịch vụ model và nền tảng môi trường cùng lập lịch thời điểm chuẩn bị, biến việc chiếm tài nguyên từng trải suốt cả task thành phân bổ theo giai đoạn.
Sau khi giải phóng bộ nhớ, task vẫn mất 30 giây, và việc gọi model trở thành yếu tố quyết định trong việc đạt hạn 24 giây. Giảm số phiên mỗi replica V4-Flash từ 32 xuống 16 hạ thời gian gọi từ 9 giây xuống 6 giây, kéo task ba vòng từ 30 giây xuống 21 giây, trong khi số lời gọi model đồng thời trung bình giảm từ 270 xuống 180; cái giá là thêm 0,375 B200-giây mỗi lời gọi, khiến số replica tăng từ 10 lên 12. Kết hợp với việc dựng lại môi trường mỗi vòng, một m5d.metal duy nhất với 48 lõi và 358 GiB bộ nhớ có thể đáp ứng luồng task đã cho. Cuối cùng, chi phí được so sánh giữa các phương án thỏa mãn cả ràng buộc chất lượng lẫn ràng buộc hạn thời gian.
Cách tiếp cận tương tự cũng giải thích việc tổ chức tài nguyên trong RL: một công việc theo nhóm trước tiên giành các tài nguyên khớp của nó, một thể hiện rollout tạm thời trước tiên hoàn tất truyền và nạp trọng số, và việc xác minh được gửi ngay sau khi sinh mẫu, cho phép xác minh tiến hành song song với việc sinh tiếp theo; nếu một lần thử lại theo sau một lần thất bại, khối lượng công việc của mỗi lần thử phải được cộng dồn. Phân tích yêu cầu tài nguyên nghĩa là tính xem task thực hiện tổng cộng bao nhiêu công việc; phân tích thời gian hoàn thành còn cần xem thứ tự công việc phải thực thi và phần nào có thể tiến hành song song. Chỉ kết hợp cả hai góc nhìn mới có thể đánh giá liệu một cải thiện cục bộ có mang lại lợi ích cho toàn hệ thống hay không.