Chương 4 · Kiến trúc Accelerator
Khảo sát các khối của một accelerator: đơn vị tính toán, phân cấp bộ nhớ, interconnect và nguồn điện — và các đánh đổi tính toán, lưu trữ, băng thông, điện năng, chi phí.
~116 phút đọc · Thuật ngữ
Kiến trúc Accelerator
Một phép tính chiếm 100 μs, trong đó phép nhân ma trận chiếm 60 μs và phần việc còn lại chiếm 40 μs. Gấp đôi tốc độ của ma trận unit làm giảm tổng thời gian còn 70 μs, tức mức tăng tốc khoảng 1.4. Nếu phép nhân ma trận chỉ chiếm 10 μs, thay đổi tương tự chỉ giảm tổng thời gian xuống 95 μs. Khả năng tính toán bổ sung là như nhau, nhưng lợi ích thu được lại khác biệt rất lớn. Kiến trúc thiết kế phải giải chính xác vấn đề này: dưới những ràng buộc về diện tích chip, điện năng và dung lượng lưu trữ, chọn phương án rút ngắn thời gian thực thi nhiều nhất.
Chương 2 và 3 đã giới thiệu đồ thị tính toán của model và yêu cầu tính toán của request ở từng giai đoạn. Trong chương này, lấy projection truy vấn (Q projection) của Qwen3-8B làm ví dụ — phép nhân ma trận biến vector ẩn của token hiện tại thành một truy vấn attention — để giải thích một accelerator thực hiện phép tính này như thế nào. Trước hết ta tính số lượng phép tính và khối lượng dữ liệu đọc/ghi, sau đó dần đưa vào tiling ma trận, phân cấp bộ nhớ (memory hierarchy) và phụ thuộc dữ liệu để giải thích tại sao thời gian thực thi thực tế khác với ước lượng lý tưởng. Tiếp theo ta bổ sung tính toán attention và expert, phân tích cách các operator phức tạp hơn dùng cùng phần cứng; cuối cùng so sánh sự tiến hóa thế hệ giữa NVIDIA, Ascend và Apple song song, cho thấy nhu cầu của model đã buộc những thành phần này thay đổi cùng nhau.
Chương này được tổ chức quanh ba câu hỏi: một tác vụ cần bao nhiêu tính toán, lưu trữ và truyền dữ liệu; tại sao compute unit phải chờ dữ liệu hoặc chờ kết quả của bước trước; và khi một phần nào đó được cải thiện, phần nào trở thành nút thắt mới. Hiểu được ba câu hỏi này thì việc phân tích GPU, Ascend, chip Apple và các thiết kế chuyên biệt hơn sẽ dùng chung một phương pháp.
4.1 Hiểu accelerator qua tính toán của model
Để phân tích một operator, trước hết cần xác định nó thực hiện những phép tính nào và đọc/ghi dữ liệu gì. Mục này bắt đầu từ hai yêu cầu đó để hiểu thành phần của một accelerator, đồng thời đưa ra phân tích ban đầu về các đánh đổi giữa compute unit, bộ nhớ và giao diện.
4.1.1 Yêu cầu tính toán và dữ liệu của phép nhân ma trận
Qwen3-8B có chiều ẩn (hidden dimension) 4.096; 32 query head của model mỗi head có 128 thành phần, nên độ rộng đầu ra của Q projection cũng là 4.096. Khi xử lý vị trí token cùng lúc, projection là
Trong projection , là tổng số token được xử lý trong lần này, mỗi vector đặc trưng của token chiếm một hàng của ; là số đặc trưng của mỗi vector đầu vào, cũng là số hàng của ma trận trọng lượng ; là số đặc trưng của mỗi vector đầu ra, cũng là số cột của ; trong ví dụ này . Các chữ hoa này mô tả hình dạng ma trận, nằm trong ngữ cảnh khác với ký hiệu dung lượng ở Chương 1. Nếu ta xử lý request cùng độ dài cùng lúc, mỗi request có token đầu vào mới, thì đối với prefill ; đối với decode từng bước, mỗi request xử lý một token nên . Hai giai đoạn dùng cùng trọng lượng và thực hiện cùng phép biến đổi tuyến tính; điểm khác biệt nằm ở số hàng đầu vào dùng chung trong mỗi lần.
Mỗi phần tử đầu ra yêu cầu tính một tích trong (inner product) chiều dài 4.096. Nếu tính một lần nhân và một lần cộng là hai phép toán dấu chấm động (floating-point operation), độ phức tạp tính toán của phép nhân ma trận là
Giờ xét dữ liệu. Đầu vào, trọng lượng và đầu ra đều là BF16, hai byte mỗi phần tử; bộ cộng dồn (accumulator) bắt đầu từ số 0 và giữ các tổng trung gian ở FP32, bốn byte mỗi phần tử. Đầu vào và trọng lượng mỗi thứ được đọc một lần từ bộ nhớ ngoài chip, kết quả cuối cùng được ghi lại một lần, tổng khối lượng đọc–ghi là
Thuật ngữ đầu tiên là 32 MiB trọng lượng cố định; thuật ngữ thứ hai tăng theo số hàng của đầu vào và đầu ra. Ở đây MiB nghĩa là bytes, trong khi GB/s trong thông số băng thông dùng bytes/s. Chia độ phức tạp tính toán cho khối lượng truy cập ta được độ đậm tính toán (arithmetic intensity) .
| Một Q projection | ||
|---|---|---|
| FLOPs của phép nhân ma trận | khoảng 33,6 MFLOPs | khoảng 8,59 GFLOPs |
| Đọc trọng lượng | 32 MiB | 32 MiB |
| Tổng đọc đầu vào và ghi đầu ra | 16 KiB | 4 MiB |
| Tổng khối lượng truy cập | khoảng 32 MiB | 36 MiB |
| Độ đậm tính toán | khoảng 1 FLOP/byte | khoảng 228 FLOPs/byte |
Hình 4-1 amortize phần đọc trọng lượng ra theo các hàng đầu vào: một mình một hàng gánh 32 MiB, còn 256 hàng amortize xuống còn 128 KiB mỗi hàng.
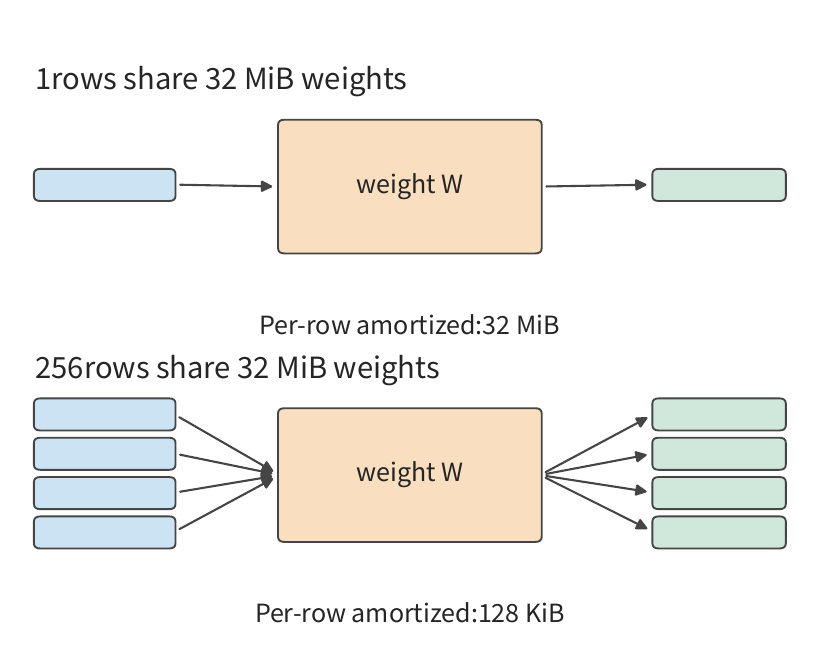
Khi số hàng tăng gấp 256 lần, số phép tính cũng tăng 256 lần, nhưng khối lượng truy cập chỉ tăng khoảng một phần tám. Việc tái sử dụng trọng lượng khiến độ phức tạp tính toán tăng nhanh hơn khối lượng truy cập, nên độ đậm tính toán tăng theo.
Chia cả tử và mẫu của độ đậm tính toán cho , ta tính được giới hạn của sự tái sử dụng:
Khi tăng, thuật ngữ trọng lượng amortize mỗi hàng ngày càng nhỏ, trong khi thuật ngữ đầu vào–đầu ra giữ nguyên. Với ví dụ này, cuối cùng tiệm cận 2.048 FLOPs/byte. Vì vậy lợi ích của việc tiếp tục tăng batch ngày càng giảm: dù lượng đọc trọng lượng amortize mỗi hàng ngày càng thấp, thì đầu vào và đầu ra của các token bổ sung vẫn cần được đọc và ghi.
Tính toán ở trên giả định trọng lượng chỉ được đọc một lần; trên phần cứng, điều này đòi hỏi giữ operand và kết quả trung gian cư trú (resident) trong suốt quá trình sử dụng.
4.1.2 Thành phần và sự phân công của một accelerator
Host thường là phía CPU chạy framework, chuẩn bị đầu vào và phát hành tác vụ, còn accelerator chịu trách nhiệm thực thi tính toán của model; trong giao diện lập trình host–device, phía accelerator thường được gọi là device. Với GPU có bộ nhớ GPU chuyên dụng, bộ nhớ host và bộ nhớ GPU là hai vị trí lưu trữ riêng biệt. Trước khi chạy một projection, đầu vào và trọng lượng được đưa vào chỗ mà accelerator có thể truy cập; sau đó CPU gửi lệnh chỉ định operator, địa chỉ dữ liệu và tham số thực thi. Khi dữ liệu đã cư trú, các lần gọi sau có thể tham chiếu lại cùng địa chỉ.
Hình 4-2 cho thấy các thành phần bên trong một accelerator phối hợp thực hiện một phép nhân ma trận như thế nào. Bộ nhớ ngoài chip giữ đầu vào và trọng lượng (những phần lớn hơn); cache chung là bộ nhớ mà nhiều nhóm compute unit cùng truy cập và tự động giữ lại dữ liệu dùng gần đây; local buffer là bộ nhớ được cấp cho nhóm tính toán hiện tại để staging đầu vào; ma trận unit liên tục cập nhật các tổng trung gian; bộ nhớ accumulator giữ các tổng trung gian cho đến khi phép tính của khối hiện tại hoàn tất. Vector unit và các compute unit tổng quát xử lý biến đổi kết quả, tính địa chỉ và luồng điều khiển.
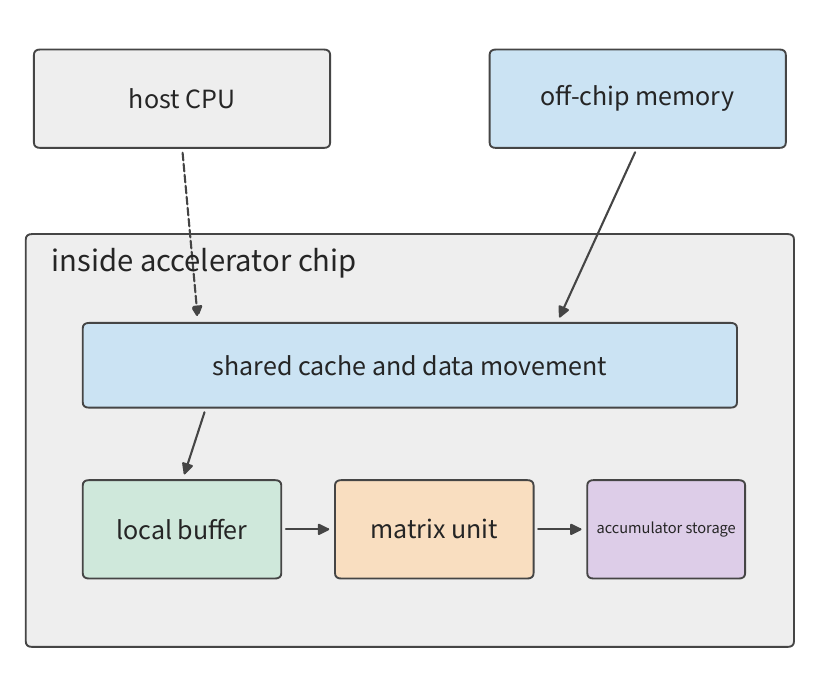
Để tính một khối đầu ra, nhiều khối đầu vào và trọng lượng phải được đọc lần lượt theo chiều K. Sau mỗi lần nhân–cộng, tổng trung gian nằm trong bộ nhớ accumulator, và khối tiếp tục cập nhật nó. Nếu mỗi lần cập nhật đều ghi ra ngoài chip, kết quả trung gian sẽ phải liên tục được ghi ra rồi đọc vào lại; giữ tổng trung gian trên chip thì chỉ còn một lần ghi cuối cùng. Dữ liệu được tái sử dụng bao nhiêu lần thì việc giữ trên chip càng có giá trị.
NVIDIA tổ chức một nhóm thread hợp tác thực thi, các compute unit tổng quát, ma trận unit và bộ nhớ cục bộ thành một Streaming Multiprocessor (SM), trong đó đơn vị nhân–cộng ma trận gọi là Tensor Core. Buffer do phần mềm quản lý bên trong SM, dùng chung bởi các thread, gọi là shared memory. Thread là đơn vị công việc trong chương trình, thực thi lệnh độc lập; một hàm được gửi chạy trên accelerator một lần gọi là kernel, và một kernel có thể được nhiều thread thực thi hợp tác. Trong kiến trúc DaVinci của Ascend, Scalar, Vector, Cube và MTE lần lượt chỉ đơn vị điều khiển, đơn vị tính toán vector, đơn vị tính toán ma trận và đơn vị di chuyển dữ liệu. Metal của Apple là giao diện lập trình để gửi tác vụ lên GPU, tổ chức các thread có thể dùng chung bộ nhớ cục bộ và đồng bộ thành thread group. Dù tên gọi khác nhau, những thành phần này đều giải quyết vài vấn đề chung: operand đến đơn vị thực thi như thế nào, kết quả được giữ ra sao, và khi nào công việc tiếp theo có thể bắt đầu.
Theo các mũi tên trong Hình 4-2, ta phân biệt được hai loại chờ. Một là dữ liệu chưa đến — ví dụ một khối đầu vào vẫn đang trên đường truyền; loại kia là phép tính trước chưa xong — ví dụ softmax chờ phép tích vô hướng truy vấn–khóa (QK) hoàn tất. Tăng băng thông rút ngắn loại chờ thứ nhất; đổi cách tiling hoặc thứ tự thực thi làm đổi loại thứ hai. Các mục sau sẽ lần lượt mở rộng từng cơ chế này.
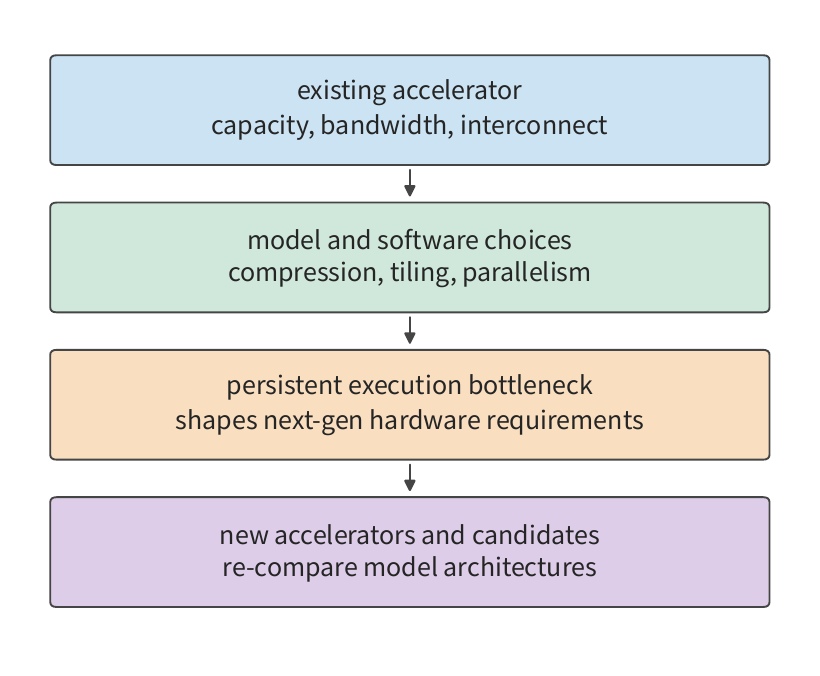
Bao nhiêu tài nguyên được cấp cho từng thành phần không được quyết định một lần và mãi mãi. Model và chip ảnh hưởng lẫn nhau qua hết thế hệ thiết kế này đến thế hệ khác. Khả năng của các accelerator hiện có ảnh hưởng đến kích thước trạng thái, hình dạng ma trận và phương thức giao tiếp của model; phần mềm nâng hiệu quả thực thi qua nén, fusion và song song; khi một tải công việc nào đó chiếm tỷ lệ đủ lớn trong thời gian đủ dài, nhà thiết kế chip bắt đầu cân nhắc bổ sung khả năng chuyên dụng cho nó. Khi thế hệ chip mới đi vào sử dụng, chi phí vận hành của các model lại thay đổi. Thiết kế và sản xuất đều tốn thời gian, nên phần cứng đáp ứng những nhu cầu đã được quan sát và dự kiến sẽ còn tiếp tục. Mục 4.6 sẽ mở rộng từng mắt xích trong Hình 4-3 theo những thay đổi thế hệ của ba kiến trúc.
Vòng phản hồi này đã có những ví dụ được ghi công khai. Báo cáo DeepSeek V3, khi đề cập đến nút thắt thực thi trên H800, đã đề xuất các yêu cầu phần cứng gồm offload giao tiếp, thao tác nhất quán giữa các interconnect, tích lũy ở độ chính xác thấp và hỗ trợ lượng tử hóa; trong đó, offload giao tiếp ra đời vì một số SM bị chiếm bởi giao tiếp.
4.1.3 Các ràng buộc về diện tích chip, điện năng và đóng gói
Compute unit, bộ nhớ và giao diện đều chiếm diện tích chip và đều tiêu thụ điện. Cấp càng nhiều tài nguyên cho một phần, ngân sách còn lại cho các phần khác càng ít. Vì vậy, để đánh giá một cải tiến cục bộ, phải xem xét toàn bộ tác vụ tiết kiệm được bao nhiêu thời gian.
Hãy khái quát hóa ví dụ mở đầu: đặt là tỷ lệ thời gian trong một tác vụ tuần tự có thể tăng tốc, và là hệ số tăng tốc của nó; theo định luật Amdahl ở Mục 1.2.1, mức tăng tốc tổng thể là:
Tiếp tục nâng tốc độ ma trận lên gấp bốn lần, tổng thời gian giảm còn μs. Lần nhân đôi đầu tiên tiết kiệm 30 μs; lần thứ hai chỉ tiết kiệm 15 μs. Ngay cả khi thời gian tính ma trận tiến về 0, phần việc còn lại vẫn cần 40 μs. Trần mức tăng tốc tổng thể là 2,5 lần. Khi phần việc còn lại chiếm tỷ lệ ngày càng lớn trong tổng thời gian mới, nơi đầu tư tài nguyên cũng thay đổi theo.
Cách phân bổ diện tích của những TPU sớm phản ánh sự đánh đổi thực tế giữa tính toán và lưu trữ. TPU là tensor processor của Google. TPU v1 thế hệ đầu tiên có mảng đơn vị nhân–cộng 8-bit, Unified Buffer 24 MiB và 4 MiB bộ nhớ accumulator. Trong bảng phân tích diện tích chip được đưa trong bài báo TPU v1, data buffer chiếm khoảng 37%, compute unit khoảng 30%, mạch điều khiển khoảng 2%. Buffer còn chiếm nhiều diện tích hơn compute unit, vì mảng cần tái sử dụng đầu vào, trọng lượng và tổng trung gian nhiều lần. Nếu mỗi lần truy cập đều phải ra ngoài chip, các bộ nhân–cộng sẽ phải chờ dữ liệu trong thời gian dài.
Giả sử một nhà thiết kế thu nhỏ dung lượng buffer để thêm nhiều bộ nhân–cộng hơn. Một khối đầu vào trước đây cư trú trong buffer giờ bị loại bỏ sớm hơn và phải được nạp lại ở lần dùng kế tiếp; thời gian thêm do việc đọc lặp có thể bù đắp lợi ích thu được từ các bộ nhân–cộng bổ sung. Ngược lại, cấp một buffer quá lớn cho dữ liệu hiếm khi tái sử dụng cũng lãng phí diện tích có thể dùng cho tính toán. Khi so sánh các phương án thiết kế, cần tính tổng thời gian của cùng một tác vụ trước và sau thay đổi, cân nhắc cả hiệu ứng tính nhanh hơn lẫn hiệu ứng đọc lặp tăng thêm.
Cân nhắc: tiếp tục tăng tốc tính ma trận, hay tăng tốc phần việc còn lại? Trong tác vụ 60 μs cộng 40 μs ở trên, lấy tốc độ phép tính ma trận ban đầu làm mốc, thay đổi nào tiết kiệm nhiều thời gian hơn: nâng hệ số tăng tốc từ hai lần lên bốn lần, hay giảm phần việc còn lại từ 40 μs xuống 25 μs? Nếu hai thay đổi có chi phí diện tích khác nhau, ta nên chọn theo cách nào?
Ngoài diện tích, điện năng là một ngân sách khác; chip càng lớn và càng nhiều card liên quan, điện năng càng dễ trở thành ràng buộc quyết định. Dưới đây, bốn suy luận biến điện năng thành đại lượng tính được: tại sao di chuyển dữ liệu tiêu tốn điện, mỗi cấp bộ nhớ tiêu bao nhiêu điện cho mỗi byte di chuyển, chip có thể làm lớn đến đâu và kết nối được bao nhiêu bộ nhớ, và trần điện năng hạ tần số thực tế chip chạy ra sao.
Tại sao di chuyển dữ liệu tiêu tốn điện. Chi phí năng lượng của việc di chuyển dữ liệu đến từ việc nạp và xả dây dẫn. Công suất tiêu thụ của mạch số chia thành phần tĩnh và phần động: điện năng tĩnh là dòng rò không liên quan đến việc chuyển mạch, điện năng động phát sinh khi tín hiệu dao động giữa 0 và 1. Theo bài báo LogicFolding của He Tingbo, điện năng động chiếm khoảng 90% trong các tải công việc điện thoại thông minh điển hình. Một đường tín hiệu cùng cửa logic điều khiển nó có thể xem như một tụ điện ; nạp nó từ 0 lên điện áp yêu cầu nguồn cung cấp năng lượng . Gọi là tỷ lệ tín hiệu dao động mỗi chu kỳ đồng hồ và là tần số đồng hồ (ở đây chỉ tần số, không phải tỷ lệ đã dùng trước đó trong định luật Amdahl); điện năng động là
Ở các nút công nghệ tiên tiến, thành phần chủ đạo của không phải cửa logic transistor mà là dây dẫn: điện dung của một dây kim loại phân bố dọc theo độ dài của nó, nên tín hiệu càng đi xa thì càng phải nạp và xả nhiều điện dung phân bố hơn. Nửa trên của Hình 4-4 minh họa cơ chế này: cùng một cửa logic điều khiển một dây ngang dài hàng trăm micromet, nạp điện dung phân bố dọc toàn bộ quãng đường; sau khi gấp mạch thành lớp trên và lớp dưới, quãng đường ngang đó trở thành một kết nối dọc chỉ dài vài micromet. Bài báo cho biết việc gấp rút ngắn độ dài dây lõi điển hình đi 20%, rút ngắn một số đường quan trọng (critical path) 70%, và giảm số bộ đệm đồng hồ của một module xử lý từ 43.600 xuống 19.000.
Hai ví dụ trong bài báo có thể tính trực tiếp bằng công thức này. Ví dụ đầu là so sánh cùng hiệu năng cho một NPU: cùng đạt 29 TOPS (29 nghìn tỷ phép toán mỗi giây), việc gấp làm giảm điện áp từ 0,85 V xuống 0,55 V. Chỉ xét thành phần điện áp,
Chỉ xét thành phần tần số, tần số giảm 63%, nên còn 0,37 giá trị ban đầu. Nhân thành phần điện áp với thành phần tần số cho , thấp hơn nhiều so với tỷ lệ công suất tổng thể 0,34 (tức giảm 66%) mà bài báo công bố. Khoảng cách này đến từ tính song song: NPU thế hệ trước là một lõi lớn cộng hai lõi nhỏ, trong khi bản gấp là bốn lõi lớn (bài báo §V), dựa vào nhiều lõi song song hơn ở tần số thấp hơn để vẫn đạt 29 TOPS. Với nhiều lõi hơn, điện dung chuyển mạch mỗi chu kỳ tăng lên, bù một phần cho lượng giảm đi do dây ngắn hơn. Điện áp, tần số và tính song song cùng nhau cho ra 0,34, trong đó thành phần điện áp đóng góp nhiều nhất — đó là lý do bài báo kết luận việc giảm điện áp đóng góp nhiều hơn việc rút ngắn dây.
Ví dụ thứ hai là một DSP (bộ xử lý tín hiệu số): thế hệ gấp đầu tiên làm giảm công suất xuống 0,75 giá trị ban đầu và làm giảm diện tích dự kiến (tức diện tích chip chiếm trên mặt phẳng) xuống 0,60, nên công suất mỗi đơn vị diện tích, tức mật độ công suất, trở thành
cao hơn 25% so với trước, khớp với 24% mà bài báo công bố. Nhiệt phải được tản ra trên toàn bộ diện tích chip, nên tổng công suất giảm không nhất định làm giảm gánh nặng tản nhiệt. Nửa dưới của Hình 4-4 sắp xếp các con số của cả hai ví dụ cạnh nhau.
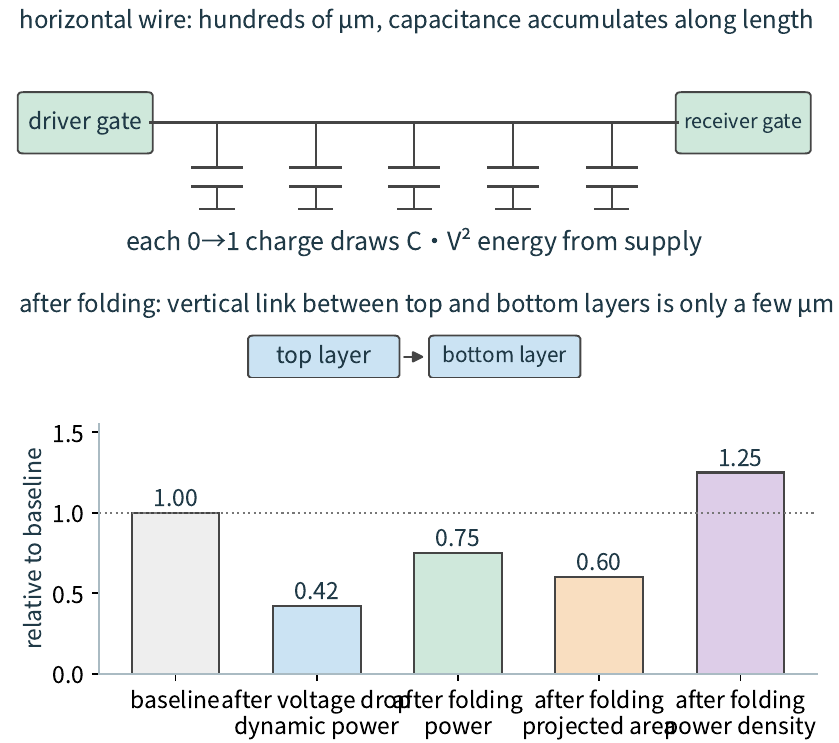
Điều kiện đảo ngược (điều kiện quan trọng làm kết luận đảo chiều): mật độ công suất không tăng chỉ khi tỷ lệ diện tích không nhỏ hơn tỷ lệ công suất; trong ví dụ này tỷ lệ diện tích 0,60 nhỏ hơn tỷ lệ công suất 0,75, nên mật độ công suất tăng.
Thang năng lượng: bao nhiêu năng lượng để di chuyển một byte. Chi phí năng lượng phụ thuộc vào điện dung phải nạp và xả, và điện dung đó tăng theo khoảng cách, nên cùng một byte lấy từ các cấp bộ nhớ ở khoảng cách khác nhau tốn năng lượng khác nhau rất nhiều. Bảng dưới liệt kê năng lượng mỗi byte cho các cấp bộ nhớ và liên kết khác nhau: SRAM (bộ nhớ truy cập ngẫu nhiên tĩnh) được chế tạo trên chip; HBM và LPDDR (DRAM công suất thấp) đều là DRAM ngoài chip (bộ nhớ truy cập ngẫu nhiên động); NVLink-C2C là liên kết chip-to-chip nối CPU và GPU trong siêu chip Grace Hopper. Đơn vị pJ là picojoule ( J). Các con số đến từ bốn nguồn; bảng cũng liệt kê nút công nghệ và năm của từng nguồn.
| Cấp | Số liệu nguồn | Năng lượng mỗi byte | Công nghệ và năm |
|---|---|---|---|
| SRAM cục bộ quy mô KB | 5 pJ mỗi từ 32-bit | 1,25 pJ | 45 nm, Horowitz ISSCC 2014, trích trong Dally Hot Chips 2023 |
| SRAM trên chip quy mô MB | 50 pJ mỗi từ 32-bit | 12,5 pJ | Dally Hot Chips 2023, trang 52, không nêu công nghệ |
| Liên kết NVLink-C2C | 1,3 pJ/bit | 10,4 pJ | Siêu chip Grace Hopper, blog kỹ thuật NVIDIA, tháng 11 năm 2022 |
| HBM2 | 3,97 pJ/bit | 31,76 pJ | Mô hình năng lượng DRAM 28 nm, MICRO 2017 |
| DRAM LPDDR | 640 pJ mỗi từ 32-bit | 160 pJ | 45 nm, Horowitz ISSCC 2014 |
| Phép nhân–cộng dấu chấm động 16-bit (2 FLOPs) | 1,5 pJ mỗi phép toán | 0,75 pJ/FLOP | 45 nm, Dally Hot Chips 2023 |
Hầu hết năng lượng mỗi bit của HBM2 bị tiêu thụ bên trong chính DRAM, không phải trên dây dẫn tới GPU. Die là miếng silicon cắt từ đĩa wafer. Theo bảng phân tích trong bài báo MICRO 2017, đường dữ liệu bên trong DRAM die từ mảng nhớ (memory array) đến base die (die dưới cùng của chồng HBM) chiếm 2,24 pJ/bit, kích hoạt hàng (row activation — mở một hàng trong mảng nhớ) chiếm 1,21 pJ/bit, và I/O đưa dữ liệu qua interposer (một miếng silicon mang interconnect giữa các chip) đến GPU chỉ chiếm 0,3 pJ/bit. Ba thuật ngữ này cộng lại 3,75 pJ/bit; cộng thêm chi phí như ECC (mã sửa lỗi) lên 3,92 pJ/bit; phần thân bài báo cho tổng là 3,97 pJ/bit như trong bảng. Con số 1,3 pJ/bit của NVLink-C2C chỉ tính riêng liên kết; dữ liệu lấy qua đó trước tiên phải được đọc từ bộ nhớ ở phía bên kia.
Hãy áp bảng này cho tác vụ sinh ở Mục 4.8.3: Qwen3-8B, BF16, một request, ngữ cảnh 8K. Một bước decode đọc 15,137 GB trọng lượng và 1,208 GB KV, tổng cộng 16,345 GB, với khối lượng phép tính ma trận 19,97 GFLOPs. Dùng hàng HBM và hàng nhân–cộng từ bảng,
tổng cộng 0,534 J, trong đó đọc trọng lượng chiếm 90%: gần như toàn bộ năng lượng trong một bước decode một request đều dùng cho di chuyển dữ liệu. Hàng HBM lấy từ mô hình năng lượng HBM2 28 nm, trong khi hàng tính toán lấy từ năng lượng nhân–cộng của tiến trình logic 45 nm — hai hàng dùng nút công nghệ khác nhau, nên phép cộng này chỉ cho so sánh bậc độ lớn giữa hai loại năng lượng: di chuyển và tính toán. Thời gian của bước này, mặt khác, bị giới hạn bởi băng thông: đọc 16,345 GB này ở 3,35 TB/s mất 4,9 ms, nên trải 0,534 J ra khoảng thời gian này chỉ tương đương khoảng 110 W. Nửa dưới của Hình 4-5 giả định cùng 16,345 GB đều đến từ một cấp duy nhất: chỉ 0,020 J cho SRAM quy mô KB, 0,204 J cho SRAM quy mô MB, 0,170 J cho liên kết NVLink-C2C, 0,519 J cho HBM và 2,62 J cho LPDDR.
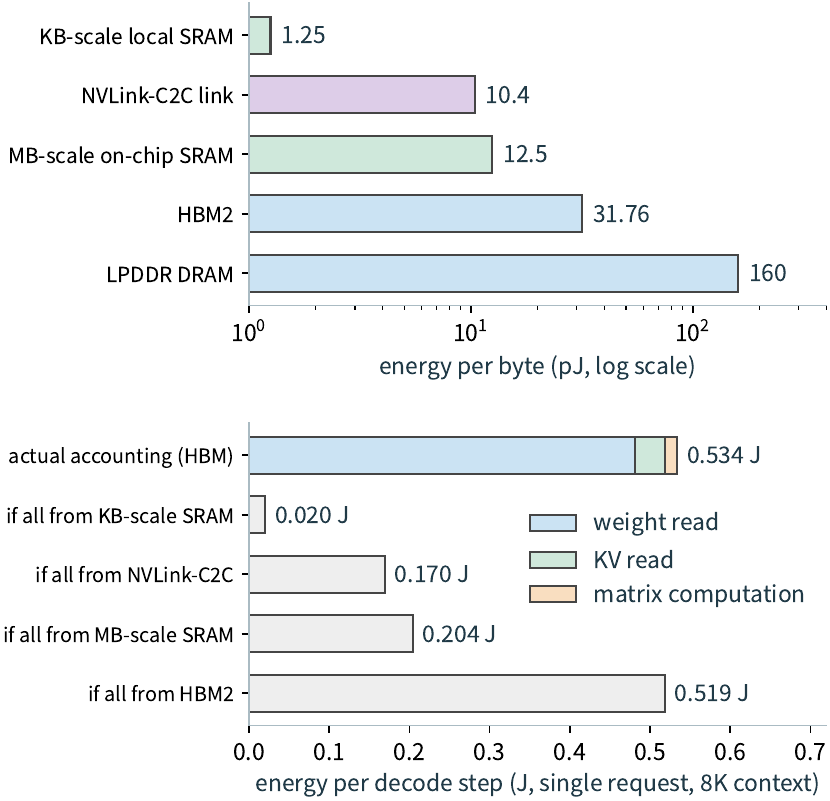
Băng thông chỉ quyết định một bước chạy nhanh bao nhiêu, không quyết định tốn bao nhiêu năng lượng: nhân đôi băng thông HBM làm bước này ngắn đi một nửa, nhưng 0,534 J vẫn không đổi. Chỉ có hai cách giảm năng lượng: lấy các byte từ cấp gần hơn, hoặc làm cho cùng các byte phục vụ nhiều token hơn. Với batch size , trọng lượng đọc một lần phục vụ token, nên năng lượng mỗi token là J; tại con số này khoảng 0,068 J, bằng một phần tám của một request. Vì vậy tái sử dụng dữ liệu trước hết là một vấn đề năng lượng, và chỉ thứ hai mới là vấn đề băng thông. Điểm chuyển đổi do thời gian xác định ở Mục 4.8.1 được quyết định bởi tỷ số băng thông trên thông lượng tính toán; điểm chuyển đổi ở đây được quyết định bởi tỷ số năng lượng-mỗi-byte trên năng lượng-mỗi-FLOP, và hai điểm này không trùng nhau.
Điều kiện đảo ngược: , nghĩa là chỉ khi batch size vượt 32 thì năng lượng di chuyển trọng lượng mỗi token mới rơi xuống dưới năng lượng tính toán.
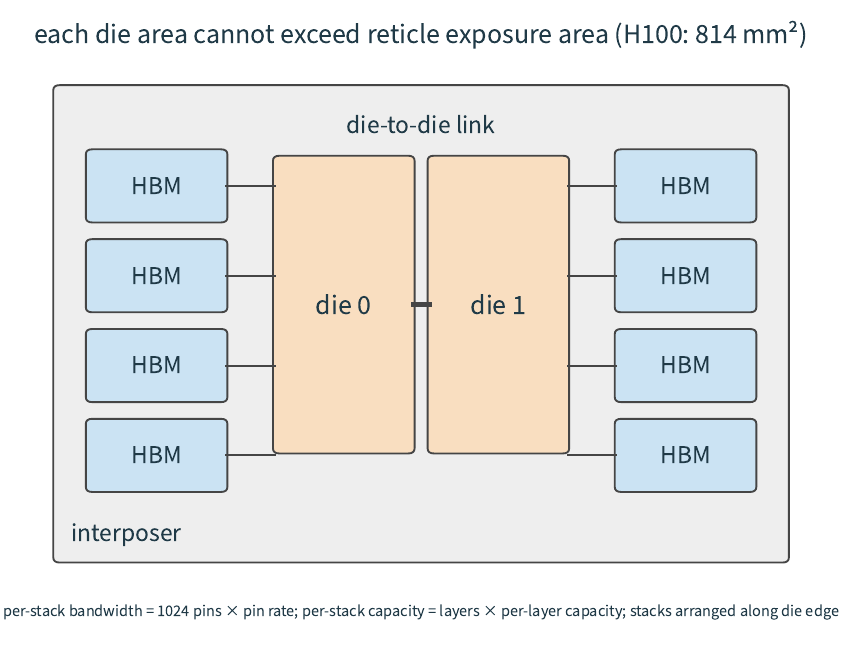
Reticle và đóng gói: chip có thể lớn đến đâu, và kết nối được bao nhiêu bộ nhớ. Một máy quang khắc, mỗi lần phơi chỉ phủ được vùng hoạ tiết của một reticle (khuôn dùng để phơi); vùng này gọi là giới hạn reticle (reticle limit), và một die không được vượt nó. Die của H100 là 814 mm², của A100 là 826 mm², cả hai đều gần giới hạn này; GPU datacenter Blackwell có hai die, mỗi die được chế tạo đúng tới giới hạn reticle, rồi nối thành một chip duy nhất bằng liên kết NV-HBI 10 TB/s. Khi một chip chia thành hai die, phía nào giữ phép tính nào sẽ quyết định bao nhiêu lần truy cập phải đi qua liên kết này — Mục 4.5.1 sẽ tính cụ thể.
HBM xếp chồng nhiều lớp DRAM die lên một base die, nối các lớp bằng TSV (through-silicon vias — dây dẫn dọc đi xuyên qua silicon), và toàn bộ chồng kết nối với GPU qua dây dẫn trên interposer. Mỗi chồng có 1.024 chân dữ liệu; với tốc độ chân , băng thông và dung lượng mỗi chồng là
Lấy HBM3E làm ví dụ: chồng 8 lớp của Micron chứa 24 GB, chồng 12 lớp chứa 36 GB; tốc độ chân 9,6 Gbit/s do SK hynix công bố, thay vào công thức trên cho GB/s, khớp với 1,23 TB/s ghi trên trang sản phẩm của hãng. Hình 4-6 vẽ kiểu đóng gói này: die ở giữa, các chồng HBM xếp dọc mép die, và interposer mang các kết nối giữa chúng. Dùng cùng công thức, ta suy ngược được cấu hình HBM của ba thế hệ GPU:
| GPU | Dung lượng | Băng thông | Số chồng | Dung lượng mỗi chồng | Băng thông mỗi chồng | Tốc độ chân |
|---|---|---|---|---|---|---|
| H100 SXM5 | 80 GB | 3.350 GB/s | 5, theo white paper | 16 GB | 670 GB/s | 5,24 Gbit/s, white paper ghi 2619 MHz DDR (double data rate, truyền hai lần mỗi chu kỳ đồng hồ) |
| H200 SXM | 141 GB | 4.800 GB/s | 6 chồng tổng 144 GB, sản phẩm bật 141 GB | 24 GB | 800 GB/s | 6,25 Gbit/s, suy ra |
| B200 (HGX) | 180 GB | 8.000 GB/s | 8 chồng tổng 192 GB, sản phẩm bật 180 GB | 24 GB | 1.000 GB/s | 7,81 Gbit/s, suy ra |
Sự tăng trưởng qua các thế hệ trong bảng, mỗi bước đều có thể tách thành số chồng, dung lượng mỗi chồng và tốc độ chân. 5 chồng của H100 tạo thành giao diện 5.120-bit; 5.120 bit nhân 5,24 Gbit/s chia cho 8 cho khoảng 3.350 GB/s. Từ H100 đến H200, dung lượng tăng 76%, đến từ việc mỗi chồng tăng từ 16 GB lên 24 GB và số chồng tăng từ 5 lên 6; băng thông tăng 43%, đến từ lượng chồng cộng thêm cộng tốc độ chân tăng từ 5,24 lên 6,25 Gbit/s. Từ H200 đến B200, thêm hai chồng nữa: cả H100 và H200 đều chỉ có một die, lần lượt gắn 5 và 6 chồng; 8 chồng của B200 xếp dọc mép ngoài của hai die giới hạn reticle (Hình 4-6). Số chồng được suy ra từ cấu hình 192 GB và 7,7 TB/s trong bản brief kỹ thuật Blackwell, giả định 24 GB mỗi chồng; phần còn lại của cuốn sách dùng thông số nền tảng HGX B200 là 180 GB và 8 TB/s mỗi GPU.
Điều kiện đảo ngược: khi số chồng cần (dung lượng mục tiêu chia dung lượng mỗi chồng) vượt số chồng mà một die có thể gắn, hoặc phải tăng số lớp mỗi chồng, hoặc thêm một die; chuyển sang chồng 12 lớp 36 GB thì chỉ 6 chồng cũng đạt 216 GB, không cần thêm chồng.
Trần điện năng: tại sao đỉnh tính toán không duy trì được. Công suất thiết kế nhiệt (TDP) là công suất tối đa được phép duy trì liên tục của một mô-đun: 700 W cho H100 SXM, 1.000 W cho B200. Ngân sách điện này được chia sẻ giữa bộ nhớ và tính toán. Lấy H100 làm ví dụ: dùng năng lượng mỗi byte từ hàng HBM2 trong bảng trên, công suất ở đầy băng thông HBM là W; sau khi trừ đi, còn 594 W cho tính toán; chia cho đỉnh BF16 đặc (dense) 989,4 TFLOP/s cho ra ngân sách năng lượng mỗi FLOP ở tốc độ đỉnh:
Ngân sách 0,60 pJ/FLOP chỉ có thể đạt được qua các lệnh ma trận và tiến trình công nghệ — các con số tham chiếu 45 nm cho thấy điều đó. Một lệnh nhân–cộng số thực chuẩn scalar (HFMA) làm 2 FLOPs tốn 1,5 pJ, tức 0,75 pJ/FLOP, đã vượt ngân sách ngay một mình; việc fetch, decode và lấy operand cộng thêm khoảng 30 pJ chi phí, gấp 20 lần năng lượng của chính phép toán. Một lệnh nhân–cộng ma trận HMMA tốn 110 pJ nhưng hoàn thành nhiều hơn 2 FLOPs rất nhiều, nên cùng một chi phí lệnh khi amortize chỉ chiếm 22%. H100 dùng tiến trình TSMC 4N; từ 45 nm đến 4N, điện dung và điện áp mỗi lần chuyển mạch giảm qua từng thế hệ.
Gọi năng lượng thực tế mỗi FLOP là . Khi , có thể duy trì tần số đỉnh; khi , bộ điều khiển điện năng hạ tần số, mức hạ bao nhiêu phụ thuộc : nếu điện áp giữ cố định, công suất giảm tuyến tính theo tần số, và tần số duy trì được là của đỉnh; nếu điện áp giảm cùng tần số, , và tần số duy trì được là của đỉnh. Hình 4-7 vẽ hai đường cong này: khi gấp 1,5 lần ngân sách, đường thứ nhất rơi xuống 0,67 trong khi đường thứ hai chỉ rơi xuống 0,87. Thông lượng tính toán duy trì giảm tỷ lệ với tần số, nên ước lượng thời gian dựa trên thông lượng tính toán đỉnh cho ra thời gian ngắn hơn thời gian thực tế. Thông lượng tính toán đỉnh là giới hạn vật lý của phần cứng, nhưng không phải lúc nào cũng đạt được: một khi chạm trần điện năng, chính giới hạn đó dịch xuống cùng tần số duy trì, và khi đó cần đo mức sử dụng (utilization) với mẫu số là thông lượng tính toán duy trì.
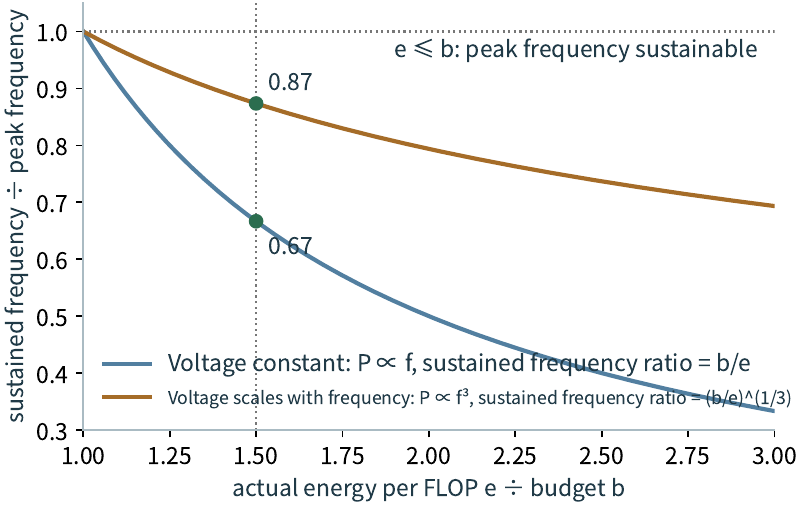
Điều kiện đảo ngược: có thể duy trì tần số đỉnh khi năng lượng mỗi FLOP nằm dưới , trong đó là công suất bộ nhớ và là thông lượng tính toán đỉnh; trong ví dụ này ngưỡng là 0,60 pJ/FLOP. Với mỗi thế hệ công nghệ, năng lượng mỗi FLOP giảm; TDP cũng tăng qua từng thế hệ; hai yếu tố này cùng xác định khi nào điều kiện này được thỏa mãn.
4.2 Compute unit
Mục 4.1 biểu diễn hiệu năng của ma trận unit theo một tốc độ tính toán. Mục này giải thích tốc độ đó đến từ đâu: một lệnh xử lý ma trận lớn bao nhiêu, tại sao ma trận nhỏ khó tận dụng đầy đủ compute unit, và kết quả ma trận còn phải đi qua những phép vector và điều khiển nào.
4.2.1 Tại sao ma trận unit phù hợp với mạng nơ-ron
Ma trận lớn phải chia thành nhiều khối nhỏ để tính, và ma trận unit chính là phần cứng thực thi các khối nhỏ đó. Các hình dạng lệnh ma trận mà chúng hỗ trợ bị giới hạn, nên phần mềm phải tổ chức một tác vụ lớn thành các bước nhỏ tương ứng; nhiều compute unit trên một thẻ accelerator có thể xử lý các khối khác nhau cùng lúc.
Khi tính một khối đầu ra , cùng một hàng đầu vào tham gia vào việc tính phần tử đầu ra, và cùng một cột trọng lượng tham gia vào việc tính phần tử đầu ra. Ma trận unit cho nhiều đơn vị tích lũy (multiply-accumulate unit) dùng chung các operand này: dữ liệu truyền giữa các compute unit liền kề, còn tổng trung gian nằm cục bộ và được cập nhật ngay tại chỗ. Một lệnh mô tả trọn một khối công việc, nên chi phí điều khiển cũng được amortize trên một lượng tính toán lớn. Chương 5 sẽ giải thích thêm cách phần mềm tổ chức kích thước khối và thứ tự duyệt để các bước nhỏ này luôn nhận được dữ liệu cần.
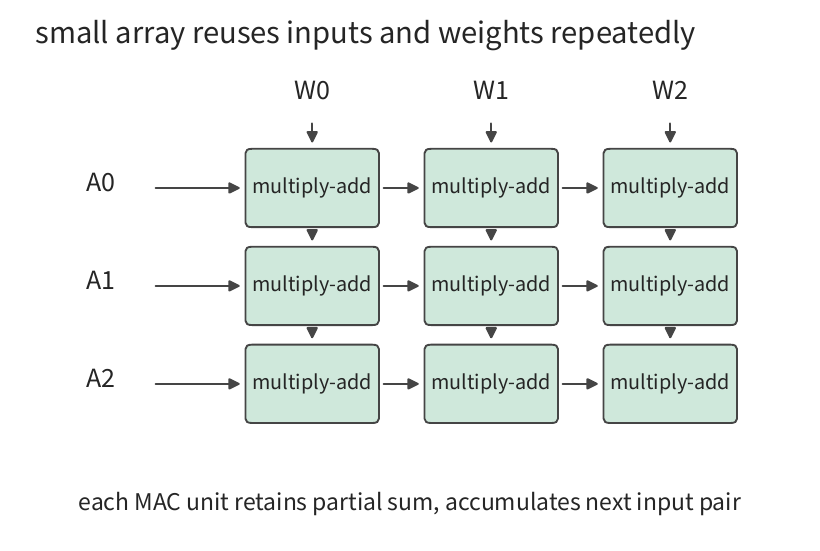
Lấy một phép tính ma trận làm ví dụ: hai khối đầu vào mỗi cái có 256 phần tử, và hoàn thành phép tính thực hiện phép toán dấu chấm động. Mỗi phần tử đầu vào tham gia 16 phép nhân trong khối. So với việc lấy toàn bộ bộ operand riêng lẻ cho từng đầu ra, cách này làm giảm dữ liệu di chuyển thừa và chi phí lệnh.
Các lệnh ma trận thường thực thi theo các khối cỡ cố định. Giả sử khối tính tối thiểu của một cài đặt là ; các chiều ma trận nhỏ hơn một khối đầy đủ được thêm số 0. Tỷ lệ phép toán hiệu quả so với phép toán thực thi thực tế là
Nếu chiều tối thiểu theo hướng hàng là 16 và ma trận thực chỉ có một hàng, các chiều còn lại đã canh chỉnh, thì chỉ một trong 16 hàng chứa đầu vào hợp lệ. Nhân đôi số ma trận unit tăng tốc cả phép tính hiệu quả lẫn phép tính thêm số 0 cùng một lúc; chuyển sang cài đặt phép nhân ma trận–vector (GEMV) phù hợp với một hàng có thể giảm phép tính lãng phí do padding. Mục 4.8 xem xét thực nghiệm cách các thư viện chọn cài đặt.
Các model chuyên gia (expert) làm vấn đề số hàng trở nên rõ rệt hơn. Giả sử 64 token, mỗi token chọn tám expert, tổng cộng 512 lần điều phối (dispatch), mỗi expert có ma trận cùng kích thước. Nếu các lần điều phối tình cờ phủ đều 256 expert, mỗi expert chỉ xử lý vector đặc trưng của hai token; nếu mọi token chọn cùng tám expert, mỗi expert xử lý vector đặc trưng của 64 token. Trong cả hai trường hợp, 64 token ban đầu tạo ra 512 lần điều phối expert, đóng góp tổng cộng 512 hàng hiệu quả vào các ma trận đầu vào của các expert.
Tiếp tục dùng cài đặt thêm số 0 tới 16 theo hướng hàng. Kiểu điều phối thứ nhất thực thi hàng, trong đó 512 hàng là hiệu quả; kiểu thứ hai thực thi hàng, tất cả đều hiệu quả. Hai kiểu điều phối có lượng tính toán hiệu quả như nhau, nhưng sau khi padding, khối lượng thực thi của kiểu thứ nhất gấp tám lần kiểu thứ hai. Việc một batch token chọn expert nào không chỉ xác định phải đọc trọng lượng nào, mà còn xác định mỗi expert xử lý bao nhiêu hàng, qua đó ảnh hưởng đến mức sử dụng của ma trận unit.
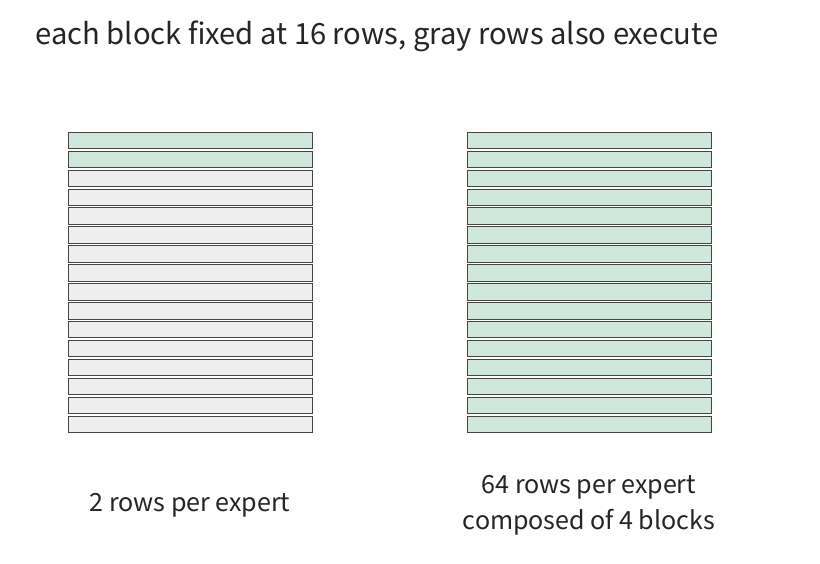
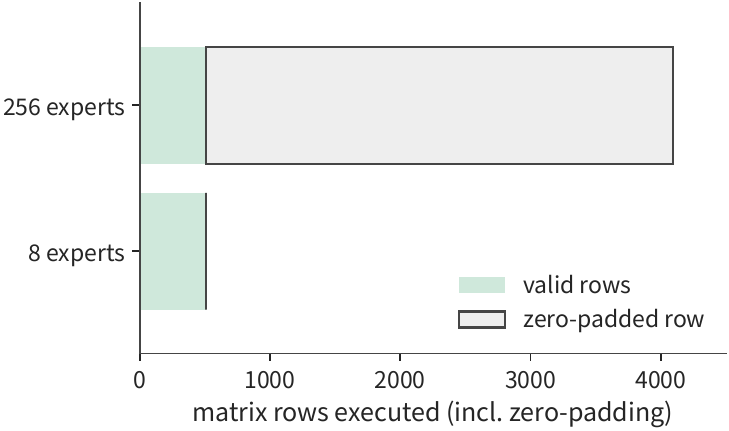
Phần màu xám nhạt trong Hình 4-9 và Hình 4-10 là tính toán do thêm số 0; thêm nhiều đơn vị tích lũy cũng làm tăng tốc phần tính toán lãng phí này. Giảm phần màu xám nhạt đòi hỏi đổi số hàng đầu vào mỗi expert hoặc chọn một khối tính nhỏ hơn.
Điều này giải thích tại sao các thư viện chuẩn bị nhiều kernel cho các hình dạng khác nhau: ma trận lớn tận dụng sự tái sử dụng của mảng, ma trận nhỏ cần độ hạt thực thi phù hợp hơn, và nhiều tác vụ nhỏ cũng có thể gộp lại để giảm khoảng trống lập lịch. Tensor Core và Cube unit của Ascend chuyên thực thi các phép tính ma trận đều đặn, trong khi các đơn vị thực thi tổng quát giữ khả năng xử lý những hình dạng khác; hai phối hợp với nhau để xử lý sự hỗn hợp cỡ ma trận trong tải công việc thực tế.
4.2.2 Những gì vector unit và đơn vị điều khiển xử lý
Ngoài nhân ma trận, một lớp Transformer còn gồm chuẩn hóa (normalization), mã hóa vị trí và hàm kích hoạt; các model chuyên gia còn cần định tuyến (routing). Những bước này gồm cả phép từng phần tử lẫn phụ thuộc giữa nhiều phần tử.
Lấy Softmax trên một hàng điểm số làm ví dụ. Vì yêu cầu ổn định số học, trước hết tìm giá trị lớn nhất, sau đó tính các hàm mũ dịch chuyển, cuối cùng cộng và chuẩn hóa:
Khi , phải tính 128 giá trị hàm mũ, và phải chuẩn hóa 128 kết quả; việc tìm cực đại và tìm tổng mỗi cái đều cần kết hợp 128 đầu vào. Phép từng phần tử có thể phân tán ra nhiều compute unit để thực thi song song; một phép toán kết hợp nhiều phần tử thành ít kết quả hơn gọi là reduction, ví dụ như cộng dồn hoặc tìm cực đại. Một reduction đòi hỏi dần dần hợp nhất kết quả từ từng đơn vị. Một reduction nhị phân lý tưởng cần vòng, mỗi vòng chờ kết quả của vòng trước. Thêm nhiều compute unit song song có thể rút ngắn thời gian xử lý mỗi vòng, nhưng các vòng vẫn nối tiếp nhau.
Vector unit xử lý loại công việc từng phần tử và reduction này, special function unit xử lý những phép như lũy thừa, và logic điều khiển quản lý vòng lặp, địa chỉ, rẽ nhánh và đồng bộ. Ba yếu tố này cùng nhau xác định khi nào một kết quả ma trận sẵn sàng cho phần tính toán sau dùng. Cách Ascend đặt tên các đơn vị Cube, Vector và Scalar phản ánh trực tiếp sự phân công này; theo white paper Ascend 950, một subsystem AI gồm một Cube Core và hai Vector Core, và phần vector chủ yếu dùng single instruction, multiple data (SIMD — một lệnh thực hiện cùng phép toán trên một nhóm dữ liệu), bổ sung bởi single instruction, multiple threads (SIMT — cùng một lệnh được gửi tới một nhóm thread, mỗi thread có trạng thái thực thi riêng).
Điểm số của Softmax thay đổi theo đầu vào và phải tính lại hàm mũ mỗi lần; những phép phi ma trận khác dùng hệ số chỉ thay đổi theo vị trí nên có thể tính trước và tái sử dụng nhiều lần. RoPE dùng hệ số sin và cos cố định cho mỗi vị trí, áp lên một cặp thành phần
Với 32 Q head và 8 K head của Qwen3-8B trong một layer, mỗi head xoay 128 chiều, có cặp thành phần. Mỗi cặp cần bốn phép nhân và hai phép cộng/trừ, tổng 15.360 FLOPs mỗi token. Mọi head dùng cùng hệ số tại một vị trí nhất định, nên một bảng có thể dùng chung: việc lưu 64 cosin và 64 sin cho mỗi vị trí trong 1.024 vị trí chỉ tốn KiB ở BF16.
Việc tính trước biến việc đánh giá lượng giác lặp thành tra cứu hệ số; chính phép xoay vẫn được thực thi theo từng token. Áp lực do đó chuyển từ tính toán hàm đặc biệt sang truy cập bảng và các phép vector.
4.2.3 NVIDIA, Ascend và Apple thực thi tính toán attention như thế nào
Attention kết nối phần tính toán ma trận và phần tính toán vector của hai mục trước: tạo điểm số, tạo xác suất, và tạo đầu ra. Cùng một khối dữ liệu phải lần lượt đi qua ba bước này; tuy nhiên, nhiều khối có thể tiến triển đan xen trên những tài nguyên khác nhau.
| Công việc | NVIDIA GPU | Ascend | Apple GPU |
|---|---|---|---|
| Tích vô hướng truy vấn–khóa QK, tích xác suất–giá trị PV | Tensor Core; ma trận nhỏ có thể dùng compute unit tổng quát | Ma trận core Cube (AIC) | Phép tính ma trận Metal GPU |
| Lũy thừa, reduction, co giãn | Tài nguyên tổng quát và tài nguyên hàm đặc biệt của SM | Vector core Vector (AIV) | Thread GPU và cài đặt thư viện tương ứng |
| Trạng thái trung gian | Thanh ghi, shared memory, bộ nhớ accumulator | Buffer cấp-0 (L0) gần compute unit, unified buffer và đường truyền | Buffer GPU và threadgroup storage |
Sự phân công này xác định phép toán nào có thể thực thi đồng thời. Ví dụ, trong khi một khối đang được xử lý hàm mũ, ma trận unit có thể xử lý một khối khác; nhưng nếu cả hai cùng cần lấy operand từ cùng một giao diện trên chip, giao diện đó vẫn phải cung cấp các byte theo thứ tự. Đơn vị nào có thể làm việc song song và phép toán nào dùng chung giao diện, tất cả cùng nhau xác định thông lượng một khi pipeline đã chạy ổn định. Hàng Apple trong bảng chỉ đường Metal GPU. Khối lập trình Neural Engine độc lập và các đơn vị chuyên dụng trong GPU được đề cập riêng ở Mục 4.6.3.
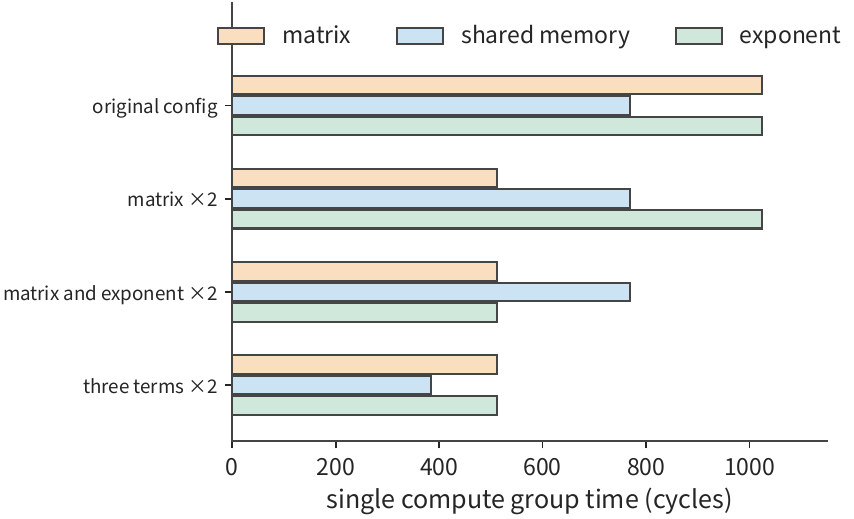
Dòng FlashAttention giảm số lần truy cập bộ nhớ vào kết quả attention trung gian nhờ tiling; phiên bản thứ tư còn nghiên cứu sâu hơn cách tính toán nên chia như thế nào khi ma trận unit mạnh hơn. Dưới đây, chúng ta dùng một phân tích về FlashAttention-4 trên một SM của B200 kiến trúc Blackwell để tính tác động của sự phân công này tới thông lượng. Lấy một khối attention chữ nhật với chiều head 128, QK và PV cộng lại khoảng 8,39 MFLOPs, với 16.384 kết quả hàm mũ. Với tốc độ ma trận 8.192 FLOPs mỗi chu kỳ mỗi SM và tốc độ hàm mũ 16 kết quả mỗi chu kỳ, mỗi thứ cần 1.024 chu kỳ. Lượt đọc shared memory cho các operand ma trận là 96 KiB, ở 128 byte mỗi chu kỳ, việc này cần 768 chu kỳ.
Khi xử lý nhiều khối liên tiếp, ma trận unit, giao diện shared memory và đơn vị hàm mũ có thể tạo thành một pipeline; việc xử lý mỗi khối chiếm ba thứ này lần lượt 1.024, 768 và 1.024 chu kỳ. Nếu các khối mới đến nhanh hơn khả năng xử lý của bất kỳ đơn vị nào trong số này, hàng đợi chờ sẽ ngày càng dài. Vì vậy, một khi pipeline đã chạy ổn định, khoảng cách tối thiểu giữa hai lần hoàn thành của hai khối liền kề ít nhất là
Ví dụ 4-1: Tại sao thông lượng pipeline của attention lại bị giới hạn bởi hàm mũ và shared memory?
Sau khi nhân đôi thông lượng của ma trận và hàm mũ, thông lượng pipeline cải thiện được bao nhiêu? Nhiều khối tạo thành pipeline trên những tài nguyên độc lập. So sánh hai cấu hình: chỉ nhân đôi thông lượng ma trận; và, trên cơ sở đó, thêm cả việc nhân đôi thông lượng hàm mũ. Với mỗi cấu hình, một khi pipeline đã chạy ổn định, khoảng cách tối thiểu giữa hai lần hoàn thành của hai khối liền kề là bao nhiêu?
Đơn vị chậm nhất quyết định khoảng cách hoàn thành giữa các khối dữ liệu liền kề. Cấu hình gốc cho chu kỳ. Chỉ cải thiện khả năng ma trận cho chu kỳ; cải thiện thêm khả năng hàm mũ cho chu kỳ.
Sau khi tăng tốc ma trận unit, nút thắt chuyển sang hàm mũ và shared memory. Thay đổi đầu tiên cho ma trận unit hoàn thành sớm hơn, nhưng thông lượng hàm mũ vẫn không đổi, nên cận dưới của khoảng cách hoàn thành vẫn giữ nguyên. Thay đổi thứ hai gỡ giới hạn hàm mũ, làm shared memory trở thành đơn vị chiếm thời gian dài nhất, và thông lượng lý tưởng tương ứng cải thiện lên lần.
Sau khi nhân đôi băng thông shared memory, nút thắt chuyển sang những đơn vị nào? Nếu băng thông shared memory cũng được nhân đôi, ba giá trị thành 512, 384 và 512 chu kỳ, và cận dưới giảm xuống 512. Điểm cân bằng mới được xác định bởi ma trận unit và đơn vị hàm mũ cùng nhau.
Cải thiện khả năng xử lý của một tài nguyên làm giảm thời gian chờ cho đến khi một tài nguyên khác trở thành nút thắt. Với một khối duy nhất, QK, Softmax và PV vẫn có phụ thuộc tuần tự; để đạt được khoảng cách hoàn thành ở trên, cần đồng thời giữ nhiều khối ở những giai đoạn tiến triển khác nhau. Mục 4.4 sẽ tính phần đệm và timing này.
Thí nghiệm 4-1 · Cốt lõi: Cách tiling của attention thay đổi tính toán và khối lượng đọc shared memory như thế nào
Đổi khối chữ nhật thành và , và tính cho từng trường hợp thời gian cần cho tính toán ma trận, hàm mũ và đọc shared memory. Sau đó lần lượt nâng thông lượng tính toán ma trận, thông lượng hàm mũ và băng thông shared memory, nêu rõ mức cải thiện được áp dụng, và xác định mục chiếm thời gian dài nhất sau mỗi thay đổi. Giải thích hình dạng khối thay đổi việc tái sử dụng dữ liệu như thế nào. Cuối cùng, chọn một phần cứng và đánh dấu ba loại công việc cùng vị trí lưu trữ của chúng trên một sơ đồ thực thi.
4.2.4 Độ chính xác thấp thay đổi tính toán, khối lượng dữ liệu và chi phí chuyển đổi như thế nào
Hình dạng ma trận xác định bao nhiêu phép tích lũy được thực hiện; định dạng số xác định mỗi phép tích lũy dùng biểu diễn gì. Phân tích độ chính xác thấp cần trả lời ba câu hỏi theo thứ tự: dữ liệu chiếm bao nhiêu không gian, nó trải qua những biến đổi nào trong khi thực thi, và những biến đổi nào mà yêu cầu về lỗi cho phép.
Bắt đầu với biểu diễn. Nếu trọng lượng mỗi cái được lưu ở bit, với một thang chia (scale) byte dùng chung cho mỗi nhóm giá trị, và tổng số phần tử chia hết cho cỡ nhóm, thì khối lượng lưu trữ là
Với trọng lượng từ Mục 4.1.1, mỗi giá trị lưu 4 bit với một thang chia một byte dùng chung cho mỗi 32 giá trị: dữ liệu trọng lượng là 8 MiB, các thang chia 0,5 MiB, tổng cộng 8,5 MiB — khoảng 1/3,8 so với 32 MiB cần cho BF16. Nếu dùng một thang chia cho mỗi 16 giá trị, tổng tăng lên 9 MiB. Nhóm càng nhỏ thì thang chia càng dễ nằm trong khoảng giá trị của nhóm đó, nhưng cũng phải lưu nhiều thang chia hơn.
Tiếp theo, thực thi. Một giá trị nén cùng một thang chia biểu diễn giá trị xấp xỉ . Có thể mở rộng nó ra BF16 trước rồi thực hiện nhân ma trận, hoặc để một lệnh ma trận độ chính xác thấp xử lý trực tiếp rồi điều chỉnh kết quả bằng thang chia sau đó. Hình 4-12 hiển thị hai cài đặt này cạnh nhau: cài trước tốn thời gian mở rộng trọng lượng từ đầu và giữ một bản sao độ chính xác cao, trong khi cài sau gộp phép nhân thang và việc kết hợp ngay vào chính quá trình thực thi.
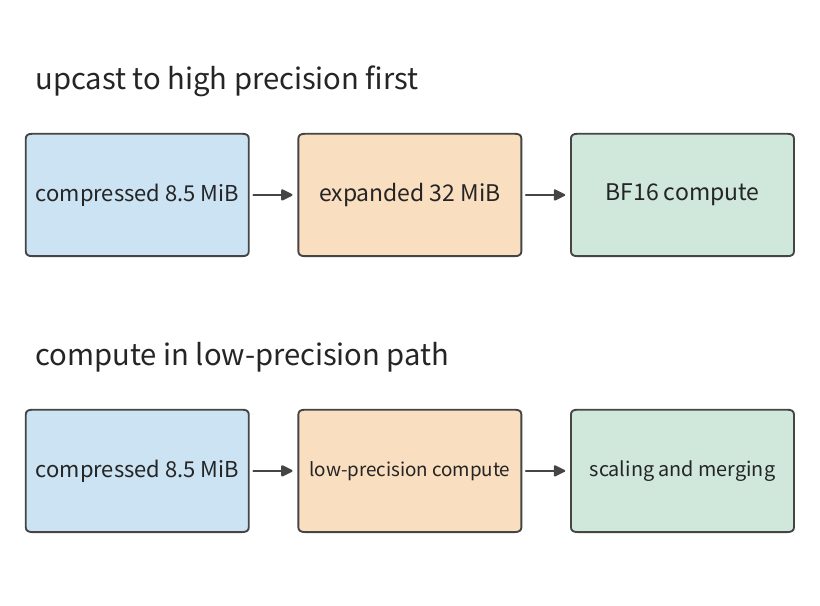
FP4, FP8 và định dạng số nguyên 8-bit INT8 đã bước vào các kernel trong model thực tế: một cài đặt expert được định tuyến trong DeepSeek V4-Flash trước chuyển các trọng lượng FP4 sang FP8 rồi thực hiện một GEMM. Trọng lượng được lưu và đọc ở FP4, giảm số byte được truyền; sau khi chuyển đổi, ma trận unit tính ở định dạng FP8. Nếu các trọng lượng đã mở rộng được dùng nhiều lần, chi phí của một lần chuyển có thể amortize trên nhiều lần gọi; nếu việc mở rộng được làm lại mỗi lần gọi, thời gian chuyển đổi trở thành một phần cố định của mỗi tác vụ. Độ chính xác thấp tiết kiệm được bao nhiêu thời gian phụ thuộc vào sự khác biệt giữa thời gian đọc tiết kiệm được và thời gian chuyển đổi tăng thêm.
Thí nghiệm kèm theo đo cả lỗi lẫn chi phí thực thi, dùng một ma trận expert từ Qwen3-VL-30B-A3B, so sánh hai phương pháp: tính trực tiếp với tiling INT8, versus trước mở rộng ra BF16 rồi thực hiện một phép nhân ma trận. Thí nghiệm chạy trên RTX PRO 6000, với đầu vào lấy từ định tuyến expert thực tế. Norm L2 của một vector là căn bậc hai của tổng bình phương các phần tử của nó; lỗi tương đối cục bộ được đo bằng cách chia norm L2 của vector lỗi đầu ra cho norm L2 của đầu ra tham chiếu, với ngưỡng đặt ở 2%. Việc co giãn kích hoạt theo hàng cho lỗi khoảng 2,3%–3,5%; tách thang kích hoạt riêng mỗi 128 phần tử dọc theo chiều K giảm lỗi xuống khoảng 1,5%–1,9%.
Nhóm lượng tử hóa càng nhỏ thì việc tích lũy tích vô hướng càng thay đổi. Với một hàng đầu vào và một cột trọng lượng, gọi thang kích hoạt mỗi nhóm là và thang cột trọng lượng là ; tích vô hướng có thể viết thành
Vì khác nhau giữa các nhóm, phép tính trước cộng các tích trung gian nguyên trong từng nhóm, sau đó nhân với thang chia, cuối cùng cộng các kết quả lại. Cài đặt này do đó cần 16 lần gọi ma trận, với việc chuyển đổi, co giãn và kết hợp hoàn thành giữa các lần gọi. Khi số hàng đầu vào nhỏ, chúng cũng phải được padding tới yêu cầu hàng tối thiểu của kernel. Phương án thay thế là mở rộng từng nhóm ra BF16 trước, rồi thực hiện toàn bộ việc tích lũy chiều K trong một GEMM duy nhất.
Lấy đầu vào decode một token thực tế làm ví dụ, tổng thời gian thực thi của hai phương pháp lần lượt khoảng 2,81 ms và 2,52 ms — phương pháp mở rộng trước rồi tính nhanh hơn. Dung lượng bộ nhớ GPU lại cho mẫu hình ngược lại: mức tiêu thụ GPU memory đỉnh do bộ nhớ phân bổ ghi lại qua các lần gọi lần lượt khoảng 11,4 MiB và 35,2 MiB, trong đó phương pháp tính trực tiếp tiết kiệm khoảng hai phần ba. Nhóm lượng tử hóa càng nhỏ thì lỗi càng thấp, các nhóm gọi làm tăng thời gian, và việc bỏ bản sao độ chính xác cao làm giảm dung lượng GPU memory; định dạng số và phương pháp tính cùng nhau xác định lỗi, thời gian thực thi và dung lượng GPU memory.
Cải thiện cài đặt này do đó nghĩa là gộp việc tính trong nhóm, co giãn và tích lũy lại với nhau, vừa giảm lỗi lượng tử hóa vừa giảm chi phí khởi động kernel cùng một lúc.
Thí nghiệm 4-2 · Mở rộng: Khi nào việc mở rộng trọng lượng đã lượng tử hóa làm giảm chi phí thực thi lặp lại?
Bắt đầu từ công thức tích vô hướng theo nhóm ở trên, so sánh “mở rộng trước rồi tính” với “tính trực tiếp theo nhóm”, liệt kê dữ liệu mà mỗi phương pháp phải giữ, gồm trọng lượng, thang chia, bản sao trọng lượng đã mở rộng, tổng trung gian và đầu ra. Tính tổng thời gian của ba chiến lược — mở rộng một lần khi nạp, mở rộng mỗi lần gọi, và tính trực tiếp theo nhóm — sau khi sử dụng lặp lại lần. Sau đó dùng lỗi và mức tiêu thụ bộ nhớ đỉnh được ghi từ các thí nghiệm với đầu vào thực tế để giải thích khi nào đáng dùng thêm bộ nhớ để giữ các trọng lượng đã mở rộng, nhằm giảm chi phí mở rộng lặp lại.
4.3 Phân cấp bộ nhớ (memory hierarchy)
Mục 4.2.4 giải thích định dạng số thay đổi kích thước dữ liệu như thế nào. Mục này phân tích các lượt đọc/ghi dữ liệu của Q projection, tách thành ba câu hỏi: dữ liệu này có vừa không, khi tái sử dụng nó được đọc từ cấp nào, và liệu các truy cập độc lập riêng lẻ có đủ để duy trì băng thông mục tiêu hay không.
4.3.1 Bộ nhớ GPU và bộ nhớ hợp nhất (unified memory)
Trong khi model chạy, trọng lượng, KV cache và vùng làm việc tạm thời cùng chiếm bộ nhớ. Mức chiếm của trọng lượng tương đối cố định, KV cache tăng theo số request và độ dài ngữ cảnh, còn vùng làm việc giữ các kết quả trung gian trong lúc thực thi. Chỉ sau khi xác định ba đại lượng này, mới có thể quyết định một accelerator có nhận thêm một request nữa hay không.
Trọng lượng BF16 của Qwen3-8B chiếm khoảng 16,4 GB. Model có 36 layer, mỗi layer có 8 KV head, mỗi head 128 chiều; K và V mỗi cái được lưu riêng, với hai byte mỗi phần tử. Nên mức chiếm KV cho mỗi token ngữ cảnh là
Khi mỗi request giữ vị trí và request được phục vụ đồng thời, điều kiện dung lượng là
Giải theo ta được số request tối đa ở một độ dài cố định:
Lấy 24 GB bộ nhớ GPU của RTX 4090 làm dung lượng khả dụng và dành 2 GiB cho vùng làm việc: sau khi trừ trọng lượng, còn khoảng 5,47 GB cho KV. Ở , mỗi request cần 1,125 GiB, tức khoảng 1,21 GB; KV của bốn request cộng lại cần khoảng 4,83 GB, vừa đủ; request thứ năm nâng tổng lên khoảng 6,04 GB, vượt dung lượng còn lại. Nhân đôi ngữ cảnh làm nhân đôi KV của mỗi request, và số request tối đa giảm xuống hai.
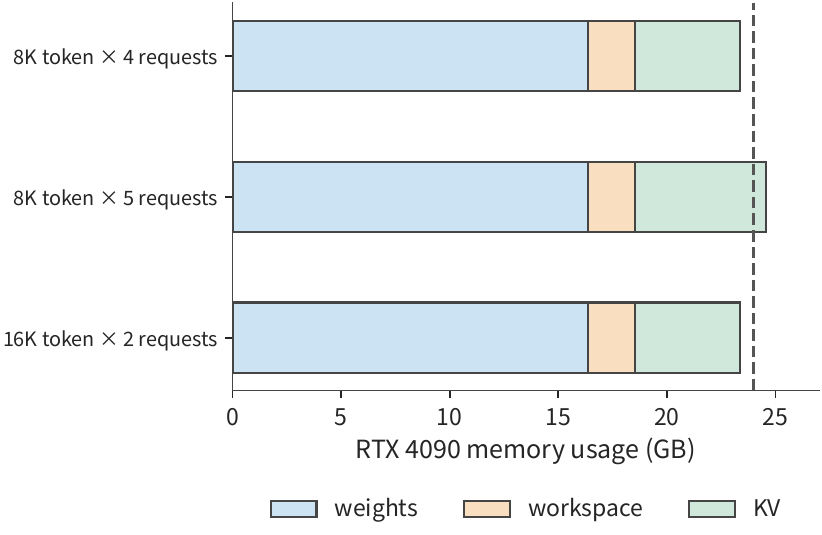
Trong Hình 4-13, độ rộng của trọng lượng và vùng làm việc giữ cố định, thay đổi diễn ra ở vùng KV bên phải. Ngữ cảnh dài làm mỗi khối KV rộng hơn, còn mức đồng thời tăng làm tăng số khối; hai yếu tố này tranh nhau cùng một khoảng trống còn lại.
Phép làm tròn trong công thức số request tối đa bộc lộ một hiệu ứng bậc thang của dung lượng. Thêm một lượng nhỏ bộ nhớ có thể khiến không đổi; chỉ khi khoảng trống còn lại đủ chứa trọn KV của thêm một request, số request tối đa mới tăng. Nén trọng lượng làm tăng khoảng trống còn lại ở tử số của công thức, nên cũng giúp chứa thêm request. Với model có trọng lượng lớn, giảm phần chiếm cố định nâng rõ rệt mức độ đồng thời; với tác vụ ngữ cảnh dài, nơi KV đã chiếm tỷ lệ lớn, việc nén tiếp trọng lượng cho lợi ích giảm dần.
Giảm độ rộng bit của KV cũng giải phóng dung lượng. DeepSeek V4.1-Flash ở Chương 2 dùng cả lịch sử toàn cục lẫn cửa sổ cục bộ SWA. Một bản ghi main-KV với 512 giá trị ở FP4, cùng thang chia theo nhóm của nó, chiếm 288 byte; một bản ghi cửa sổ cục bộ ở FP8 cùng thang chia chiếm 528 byte. Main KV được dequant hóa — tức được khôi phục về định dạng số dùng cho tính toán thông qua thang chia — trước khi tham gia phép nhân attention. Lưu trữ nén trạng thái cư trú, còn giá trị được khôi phục về định dạng làm việc tại thời điểm thực thi.
Phần trên chỉ tính trạng thái suy luận. Huấn luyện còn dùng gradient, trạng thái optimizer và kích hoạt được lưu cho backpropagation. Theo vòng đời tensor được giới thiệu ở Chương 3, ta tính mức chiếm của các trạng thái này: mọi tensor vẫn cần giữ tại một thời điểm cùng nhau xác định mức tiêu thụ bộ nhớ đỉnh, còn các kết quả trung gian đã giải phóng giúp dọn chỗ cho công việc sau. Lập kế hoạch dung lượng do đó phụ thuộc cả vào kích thước từng tensor lẫn thứ tự thực thi.
Dung lượng bộ nhớ GPU suy cho cùng do các thiết bị và giao diện bộ nhớ cung cấp. HBM mang lại băng thông qua các die nhớ xếp chồng và một giao diện rộng; bộ nhớ đồ họa double data rate (GDDR) thường cấp bộ nhớ GPU qua nhiều chip nhớ ghép với một giao diện tốc độ cao. Cả hai đều là công nghệ thiết bị và giao diện bộ nhớ, còn unified memory là một sơ đồ tổ chức để một bộ xử lý dùng chung bộ nhớ. CPU và GPU của Apple truy cập cùng một bộ nhớ vật lý dùng chung, nên hai bên có thể lần lượt dùng cùng một buffer, giảm các bản sao độc lập; tương ứng, CPU, GPU và các ứng dụng khác cùng khai thác dung lượng và băng thông dùng chung này. Mục 4.5 phân tích tác động của cách tổ chức này tới thời gian truyền dọc đường host-đến-accelerator.
Suy ngẫm: KV nén có chứa thêm được một request không? Nếu yêu cầu KV của mỗi request giảm 10% so với 1,21 GB, RTX 4090 có thể nhận thêm request thứ năm không? Trước hết tìm tổng yêu cầu của năm request, rồi so với khoảng trống còn lại.
4.3.2 Cache, buffer trên chip và thanh ghi
Khi tính một khối đầu ra, cùng một giá trị đầu vào thường tham gia vào việc tính các đầu ra lân cận, và các tổng trung gian chưa đầy đủ phải tiếp tục được tích lũy. Nếu mỗi phép nhân–cộng đều quay ra ngoài chip để lấy operand và ghi kết quả, sẽ phát sinh lượng khứ hồi khổng lồ. Giữ dữ liệu được dùng thường xuyên gần compute unit — như đặt những vật liệu đang dùng lên bàn làm việc trong tầm tay — làm giảm sự di chuyển này, nhưng không gian gần đó có hạn.
Thanh ghi giữ các giá trị mà một thread và các lệnh của nó đang dùng; cache tự động giữ lại dữ liệu truy cập gần đây; buffer do phần mềm quản lý được chương trình lập lịch nạp và giải phóng một cách tường minh. Cả ba đều giữ dữ liệu để dùng lặp lại, nhưng khác nhau về dung lượng, cách truy cập và người quản lý. Bộ nhớ trên chip cũng chiếm diện tích chip, nên dung lượng của nó thường nhỏ hơn nhiều so với bộ nhớ ngoài chip. Dưới đây ta lần theo hai khối đầu vào và một khối tổng trung gian để tính không gian cần thiết.
Xét một khối nhân–cộng với . Các khối đầu vào và trọng lượng BF16 mỗi cái 16 KiB, tổng 32 KiB; bộ cộng dồn đầu ra FP32 là KiB. Một SM của V100 có thể cấu hình nhiều nhất 96 KB (tức 96 KiB) shared memory mỗi SM; nếu cả operand lẫn bộ cộng dồn đều đặt ở đó, sẽ dùng đúng hết khả năng. Chuẩn bị đồng thời cặp operand kế tiếp sẽ cần KiB.
Nếu bộ cộng dồn dùng kho lưu trữ riêng, cùng 96 KiB đó có thể chứa ba bộ cặp khối đầu vào và trọng lượng. Tổng dung lượng đệm cục bộ không tăng, nhưng sự phân chia nhiệm vụ lưu trữ làm thay đổi số khối đầu vào có thể chuẩn bị trước. Mục 4.6.1 sẽ dùng kho lưu trữ accumulator chuyên dụng của Blackwell để minh họa sự phân công này.
Ví dụ trước giữ các tổng trung gian của một khối tính trên chip, loại bỏ các lần ghi lại lặp đi lặp lại. Ý tưởng tương tự áp dụng cho đầu vào dùng chung bởi nhiều khối tính. Giả sử bốn khối đầu ra đều cần đọc cùng 32 KiB đầu vào; cộng lại chúng gửi 128 KiB yêu cầu đọc logic. L2 là cache cấp hai được dùng chung giữa các compute unit. Nếu lượt đọc đầu tiên để dữ liệu lại trong L2 và ba lượt đọc sau trúng cache thì bộ nhớ ngoài chip chỉ cần cung cấp 32 KiB, nhưng L2 vẫn phải phục vụ cả 128 KiB cho các khối khác nhau. Nếu cùng một nhóm tính xử lý tuần tự bốn khối đầu ra và giữ đầu vào trong một buffer cục bộ, các lượt truy cập sau có thể được phục vụ trực tiếp từ buffer cục bộ.
Vì vậy, phân tích cùng một dữ liệu cần phân biệt ba đại lượng: không gian chính dữ liệu chiếm giữ, số byte mỗi khối tính yêu cầu, và số byte thực tế được truyền ở một cấp giao diện nhất định. Độ đậm tính toán cũng thay đổi theo cấp quan sát. Độ đậm tính từ khối lượng yêu cầu L2 nên ghép với băng thông L2; độ đậm tính từ lưu lượng DRAM nên ghép với băng thông ngoài chip. Mục 4.8 sẽ minh họa sự khác biệt này bằng các con số đo được thực tế.
Mở rộng khối tính thường làm tăng tái sử dụng dữ liệu, nhưng cũng đòi hỏi buffer lớn hơn. RTX 5090 và RTX PRO 6000 dùng kiến trúc SM120, trong đó cache dữ liệu L1 và shared memory của mỗi SM cùng tổng 128 KB, và nhiều nhất 100 KB có thể được cấu hình làm shared memory, dùng chung giữa các nhóm tính cư trú trên SM đó: khi mỗi nhóm tính cần 32 KiB, có ba nhóm cư trú; một khi mỗi nhóm tăng lên 64 KiB, chỉ còn một nhóm có thể cư trú. Trong lúc một nhóm chờ dữ liệu, nhóm khác có thể tiếp tục tính. Nên khi số nhóm chạy đồng thời giảm, compute unit càng dễ ngồi không. Chọn kích thước khối đòi hỏi cân nhắc giữa lượng việc đọc lặp mà mỗi nhóm tránh được với số nhóm tính độc lập lẫn nhau vẫn có thể chứa được.
Dung lượng buffer trên chip cũng tăng qua các thế hệ. Giới hạn shared memory mỗi SM của A100 là 164 KB, còn của H100 là 228 KB. Nhiều nhóm compute cư trú trên chip hơn cũng có thể gửi nhiều yêu cầu đọc độc lập lẫn nhau hơn.
4.3.3 Dung lượng, băng thông và độ trễ mỗi thứ giới hạn cái gì
Dung lượng là lượng dữ liệu có thể chứa tại một thời điểm; băng thông là lượng dữ liệu được truyền mỗi đơn vị thời gian; độ trễ là thời gian một yêu cầu từ lúc bắt đầu đến lúc hoàn thành. Gửi đủ yêu cầu độc lập cùng lúc cho phép các lần truy cập khác tiến triển trong khi chờ một lần truy cập trở về.
Việc model cư trú và thực thi từng bước đặt những nhu cầu khác nhau lên bộ nhớ. Theo bảng cấu hình HBM ở Mục 4.1.3, H100 SXM cung cấp 80 GB ở 3,35 TB/s, còn H200 SXM cung cấp 141 GB ở 4,8 TB/s — dung lượng và băng thông không tăng theo cùng một hệ số. Trong một cấu hình 4-bit của Qwen3-235B-A22B, trọng lượng và thang chia tổng cộng khoảng 123,1 GB; tám request mỗi cái giữ 8.192 token KV tổng khoảng 12,6 GB, cộng vùng làm việc 2 GiB, tổng khoảng 137,9 GB. Mức thiếu dung lượng của H100 gần 58 GB, trong khi H200 có khoảng 3,1 GB dư địa. Dung lượng tăng trước hết cho phép khối dữ liệu này cư trú đồng thời.
Trọng lượng của mọi expert được giữ trong bộ nhớ, còn trọng lượng nào cần đọc ở mỗi bước do kết quả định tuyến quyết định. Khi việc chọn expert của tám request bị phân tán, lượt truy cập mỗi bước vào trọng lượng, thang chia và KV tổng khoảng 75,967 GB; khi các expert được chọn giống nhau tập trung lại, con số giảm xuống khoảng 24,737 GB. Trên một H200, chỉ riêng việc truyền các byte này mất khoảng 15,8 ms và 5,2 ms; chuyển sang HGX B200 8 TB/s đưa các con số về khoảng 9,5 ms và 3,1 ms. Việc tái sử dụng expert cắt lưu lượng xuống còn khoảng một phần ba, trong khi nâng cấp accelerator giảm thời gian cần để truyền một byte xuống còn khoảng sáu phần mười — hai thay đổi tác động lên các thuật ngữ khác nhau của công thức .
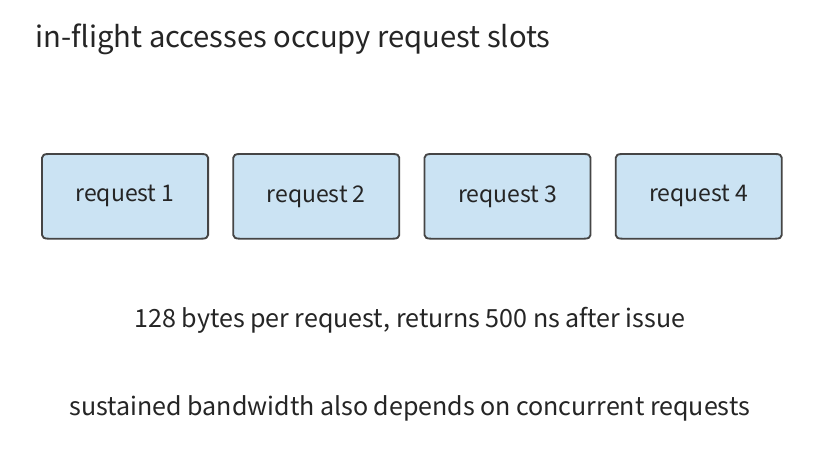
Tính toán ở trên giả định giao diện có thể duy trì một băng thông nhất định liên tục. Duy trì tốc độ đó đòi hỏi tiếp tục gửi các yêu cầu khác trong khi một lần truy cập đang chờ trở về. Gọi đơn vị cơ bản của một lần truyền đơn lẻ qua giao diện bộ nhớ là một giao dịch bộ nhớ (memory transaction). Giả sử giao diện có nhiều nhất giao dịch trong quá trình tại một thời điểm, mỗi giao dịch trả về byte, và độ trễ hoàn thành trung bình là . Một giao dịch chiếm một khe từ lúc phát ra cho đến khi nó trở về; mỗi giây có nhiều nhất khoảng giao dịch hoàn thành, nên
Giải theo , để duy trì một thông lượng mục tiêu cần
Đây là định luật Little: số yêu cầu trong quá trình trung bình bằng tốc độ hoàn thành yêu cầu nhân độ trễ yêu cầu trung bình. Các hàng đợi phần cứng quyết định có thể giữ bao nhiêu giao dịch trong quá trình, còn các truy cập độc lập lẫn nhau trong chương trình quyết định hàng đợi đó có thực sự được lấp đầy hay không. Nếu địa chỉ tiếp theo phụ thuộc vào kết quả của lần đọc trước, thì dù hàng đợi sâu đến đâu cũng không lấp đầy được; ngược lại, nhiều khối tính độc lập có thể cung cấp các lượt đọc không chờ nhau.
Ví dụ 4-2: Một GPU có băng thông cao hơn có tăng tốc đọc KV theo tỷ lệ không?
So sánh giới hạn mà số giao dịch trong quá trình và băng thông giao diện đặt lên việc đọc KV. Đọc KV tương ứng với 8.192 token ngữ cảnh của một request tổng cộng 1,125 GiB. Lấy giao diện bộ nhớ GPU là 1.008 GB/s của RTX 4090, 128 byte mỗi giao dịch, với độ trễ hoàn thành 500 ns: công cụ đo bộ nhớ Mess đo được độ trễ bộ nhớ GPU H100 khi rảnh là 363 ns, tăng lên 699–1.433 ns ở vùng gần băng thông bão hòa, nên 500 ns nằm giữa khoảng đó. Tính băng thông đọc hiệu quả và thời gian khi có nhiều nhất lần lượt 128 và 4.096 giao dịch trong quá trình, rồi so sánh với kết quả sau khi chuyển sang RTX 5090 ở 1.792 GB/s.
Suy ra băng thông đọc hiệu quả từ số byte trong quá trình và độ trễ truy cập. Duy trì 1.008 GB/s cần giao dịch. Với chỉ 128 giao dịch, băng thông đạt được chỉ khoảng 32,8 GB/s, và lượt đọc mất ít nhất 36,9 ms; 4.096 giao dịch đủ để duy trì 1.008 GB/s, đưa thời gian về khoảng 1,20 ms.
Khi số giao dịch trong quá trình không đủ, băng thông giao diện cao hơn mang lại lợi ích hạn chế. Sau khi chuyển sang RTX 5090, 4.096 giao dịch vẫn chỉ hỗ trợ khoảng TB/s, mất khoảng 1,15 ms. Băng thông giao diện tăng khoảng 78%, vậy mà thông lượng — bị giới hạn bởi số giao dịch trong quá trình — chỉ cải thiện khoảng 4%.
Cần bao nhiêu giao dịch trong quá trình để dùng hết băng thông cao hơn hoặc đối phó với độ trễ dài hơn? Cần nâng số giao dịch trong quá trình lên ít nhất 7.000 để duy trì 1.792 GB/s; nếu độ trễ tăng lên 800 ns, yêu cầu này còn tăng lên 11.200.
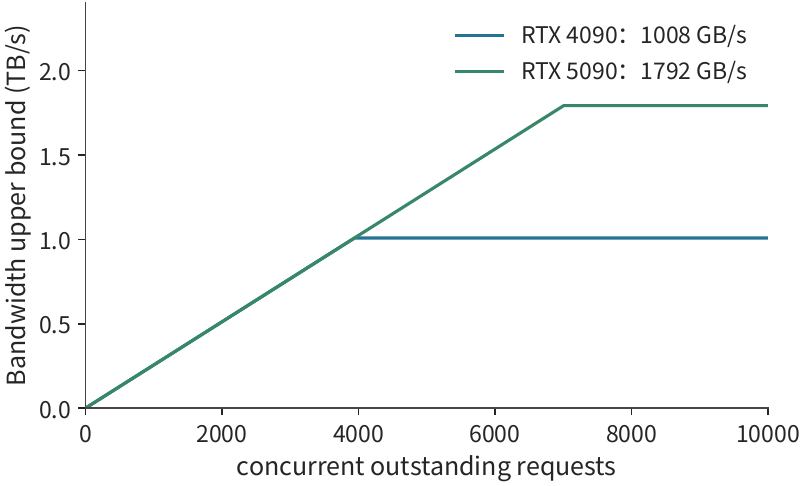
Hai đường cong trong Hình 4-15 trùng nhau ở mức đồng thời thấp vì ràng buộc khi đó đến từ số byte trong quá trình. Quá khúc cong (knee) của mỗi đường, băng thông giao diện trở thành nút thắt mới. Trong các hệ thống thực tế, tăng truy cập đồng thời cũng kéo dài hàng đợi, và độ trễ thay đổi theo tải; Mess dùng các phép dò độ trễ cùng lưu lượng nền có thể điều chỉnh để quan sát cả hai đại lượng một lúc, tạo ra một đường cong băng thông–độ trễ. Đường cong này đặt “việc gửi các yêu cầu độc lập đồng thời làm giảm thời gian rảnh khi chờ” và “quá nhiều yêu cầu làm tăng thời gian xếp hàng” lên cùng một biểu đồ.
Khi phân tích hiệu năng lưu trữ, trước tiên xác định từ dung lượng xem dữ liệu có thể cư trú trên chip, sau đó tính lưu lượng ở mỗi cấp giao diện theo mẫu hình tái sử dụng, cuối cùng xác định — kết hợp mức đồng thời và độ trễ — liệu giao diện có duy trì được truyền liên tục hay không.
Thí nghiệm 4-3 · Mở rộng: Tăng dung lượng bộ nhớ và tăng băng thông lần lượt giải quyết những nút thắt decode nào?
Dùng các kết quả lưu trữ của Qwen3-8B và Qwen3-235B-A22B, chỉ tăng dung lượng, rồi chỉ tăng băng thông, và riêng rẽ thay đổi batch size và phân bố expert. Trước hết tìm số request tối đa có thể cư trú, sau đó tính thời gian đọc mỗi bước, cuối cùng tìm số giao dịch trong quá trình cần để duy trì băng thông mục tiêu. Giải thích phương án nào bị giới hạn trước bởi dung lượng, bởi thời gian truyền, hay bởi mức độ đồng thời truy cập.
4.4 Di chuyển dữ liệu
Các mục 4.1–4.3 đã tính kích thước và số lần tái sử dụng của dữ liệu, đồng thời giải thích mức độ đồng thời cần để duy trì băng thông. Mục này tiếp tục sắp xếp khi nào dữ liệu được lấy về, khi nào được dùng và khi nào được giải phóng. Cốt lõi của việc di chuyển dữ liệu là đảm bảo khối tiếp theo đến trước khi compute unit cần nó, đồng thời giữ khối hiện tại cho đến khi lượt dùng cuối của nó hoàn tất.
4.4.1 Cấu trúc dữ liệu và tính địa chỉ
Vẽ một khối nhỏ trên một ma trận chỉ xác định cần lấy những phần tử nào. Những phần tử này không nhất thiết liền kề trong bộ nhớ: nếu ma trận gốc được lưu theo hàng (row-major), sau khi đọc một hàng của khối nhỏ, lượt đọc phải nhảy qua các phần tử không được chọn để tới vị trí tương ứng ở hàng kế tiếp của ma trận gốc. Tiling toán học chỉ có thể thay đổi các chỉ số và phạm vi truy cập, chưa chắc đã phải sao chép trước ra một ma trận nhỏ độc lập. Phần cứng cần định vị những phần tử này bằng stride. Với một view 2D trong đó mỗi phần tử chiếm byte, stride hàng là byte và stride cột là byte, địa chỉ của phần tử là
Khi một ma trận được lưu liền mạch theo hàng, , và stride hàng được xác định bởi độ rộng đầy đủ của hàng. Khi lấy một ma trận con, mỗi hàng của ma trận con chỉ chiếm một phần của một hàng ma trận gốc, nhưng khoảng cách giữa điểm đầu của hai hàng liền kề vẫn bằng stride hàng của ma trận gốc. Điều này quyết định loại truy cập phần cứng phải phát ra.
Ví dụ, lấy 128 hàng, mỗi hàng 128 phần tử liền nhau, từ một ma trận BF16 có độ rộng hàng 4.096. Dữ liệu hiệu quả là KiB, nhưng mỗi hàng chỉ chiếm 256 byte, trong khi điểm đầu của hai hàng liền kề cách nhau 8.192 byte. Khoảng cách từ đầu hàng đầu tiên đến cuối hàng cuối cùng phủ byte. Việc đọc lần lượt các hàng chỉ truyền những khoảng hiệu quả của mỗi hàng; nếu các thread liền kề truy cập các phần tử liền kề, các yêu cầu của chúng cũng có thể gộp thành ít giao dịch hơn.
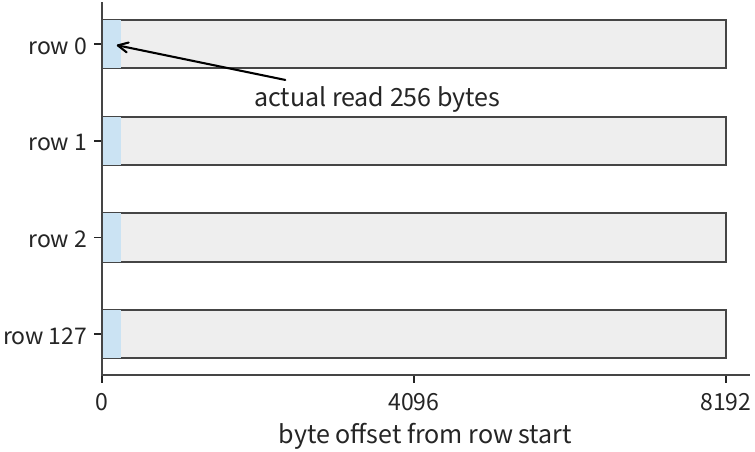
Vùng màu xanh của mỗi hàng chỉ 256 byte, nhưng vùng xanh của hàng kế tiếp mãi sau 8.192 byte mới bắt đầu. Việc đọc toàn bộ khoảng địa chỉ cũng sẽ mang theo cả các khoảng trống màu xám; trong khi đọc lần lượt từng hàng chỉ thu được các phần màu xanh. Điều này cho thấy vai trò của stride hàng: nó báo cho đơn vị di chuyển biết đoạn dữ liệu hiệu quả tiếp theo bắt đầu ở đâu.
Cấu trúc dữ liệu ảnh hưởng đến chi phí truy cập theo hai cách: stride ảnh hưởng đến việc tính địa chỉ, và độ liền mạch của địa chỉ ảnh hưởng đến việc nhiều lần truy cập có thể gộp thành một giao dịch hay không. Cùng 32 KiB đó, tùy cách bố trí, có thể được lấy về bằng các yêu cầu liên tục đều đặn, hoặc đòi hỏi phát ra một số lượng lớn các yêu cầu ngắn. Số byte mỗi giao dịch ở Mục 4.3 phụ thuộc vào cách các truy cập này được gộp lại.
Tiling cũng quyết định cùng một địa chỉ được yêu cầu bao nhiêu lần. Với expert dùng chung của DeepSeek V4-Flash, một lần tính w1 là , và đầu vào FP8 chỉ 128 KiB. Độ rộng đầu ra được chia thành 16 khối, mỗi khối 128 cột, và mỗi khối đầu ra phải duyệt toàn bộ đầu vào, nên tổng yêu cầu đầu vào ở mức khối là KiB, tức 2 MiB. Trọng lượng được phân chia theo cột đầu ra, mỗi khối đọc phần của riêng nó, tổng cộng 8 MiB dữ liệu trọng lượng.
Kích thước thực tế của đầu vào vẫn là 128 KiB; số yêu cầu dư thừa đến từ việc tiling dọc theo hướng cột đầu ra. Nếu các khối đầu ra này dùng chung một cache, các yêu cầu lặp có thể được phục vụ trực tiếp từ cache trên chip; nếu cùng một nhóm tính giữ đầu vào và liên tục tính nhiều khối đầu ra, việc tái sử dụng có thể chuyển vào một buffer cục bộ. Tính địa chỉ, tiling và phân cấp bộ nhớ nối với nhau tại đây: phương án tiling quyết định những yêu cầu đọc nào được phát ra, còn nơi dữ liệu cư trú quyết định những yêu cầu đó đi qua cấp giao diện nào.
Các lệnh tải thông thường tính địa chỉ từng bước và phát ra các lượt truy cập; một đơn vị di chuyển chuyên dụng thay vào đó nhận hình dạng, stride và điểm bắt đầu của một tensor, rồi liên tục sinh ra các địa chỉ này. Tập tham số mô tả tác vụ di chuyển này gọi là một descriptor. Kiến trúc Hopper của NVIDIA (mà H100 thuộc về) cung cấp Tensor Memory Accelerator (TMA), còn Ascend 950 cung cấp đơn vị truy cập bộ nhớ trực tiếp đa chiều (NDDMA); cả hai đều có khả năng di chuyển tensor đa chiều. Với ma trận con ở trên, điểm bắt đầu, 128 hàng, 256 byte mỗi hàng và stride hàng 8.192 byte là đủ để mô tả toàn bộ việc di chuyển đều đặn này. Với một đơn vị chuyên dụng đảm nhận việc tính địa chỉ lặp này, các thread tính toán có thể tiếp tục làm công việc khác.
4.4.2 Di chuyển bất đồng bộ và double buffering
Sau khi định vị và lấy về một khối dữ liệu, khối kế tiếp cũng phải đến đúng lúc: nếu hệ thống luôn chờ khối hiện tại tính xong rồi mới bắt đầu đọc khối tiếp theo, compute unit sẽ liên tục dừng lại. Chuẩn bị hai buffer cho phép vừa dùng dữ liệu trong buffer thứ nhất vừa nạp khối tiếp theo vào buffer thứ hai; khi khối hiện tại xong, hai buffer hoán đổi vai trò. Đây là double buffering: đổi không gian phụ lấy sự chồng lấn giữa nạp và tính trong thời gian.
Giả sử có khối dữ liệu tổng cộng, mỗi khối mất để nạp và để tính. Nếu mỗi khối phải được lấy về đầy đủ và tính xong rồi mới tới khối tiếp theo, tổng thời gian là . Khi việc nạp và tính dùng các tài nguyên độc lập, với double buffering, khối đầu tiên được nạp rồi tính, và các khối sau tiến triển theo nhịp của giai đoạn chậm hơn:
Với tám khối dữ liệu, mỗi khối mất 2 μs để nạp và 1 μs để tính, thực thi tuần tự cần 24 μs, còn pipeline cần μs. 7 μs tiết kiệm được đến từ sự chồng lấn; số byte được truyền và số phép nhân–cộng được thực hiện không đổi. Nhân đôi tốc độ tính nữa chỉ giảm tổng thời gian xuống 16,5 μs, vì việc nạp vẫn chỉ cung cấp một khối mỗi hai micro giây.
Phân tích trên coi việc nạp như một giai đoạn hoàn chỉnh duy nhất. Tiếp theo, ta tách việc nạp thành truyền và chờ trở về, và tính cần bao nhiêu buffer khi nhiều yêu cầu tiến hành đồng thời. Ở đây ta dùng “tick” để chỉ một chu kỳ đồng hồ của một SM B200, và phân biệt giữa khoảng cách phát hành (issue interval) và độ trễ hoàn thành: nếu một yêu cầu đọc được phát hành mỗi 64 tick, trong khi mỗi khối dữ liệu chỉ dùng được sau 192 tick kể từ khi yêu cầu được phát hành, thì nhiều khối sẽ đồng thời chờ trở về. Tính toán không thể bắt đầu trước khi đầu vào đến. Gọi buffer giữ một khối đầu vào là một input slot: từ khi yêu cầu đọc được phát hành cho đến khi phép tính của khối đó hoàn tất, slot vẫn bị chiếm giữ. Thêm slot cho phép các lượt đọc dữ liệu sau được phát hành sớm hơn, nhưng cũng tiêu tốn thêm bộ nhớ cục bộ.
Hãy suy ra điều này một cách cụ thể bằng phép tính QK của attention. Hai đầu vào đều là , được chia dọc theo chiều head thành bốn khối tích lũy . Mỗi khối đầu vào Q/K tổng 16 KiB, cần 1.048.576 FLOPs tính toán; bốn khối lần lượt cập nhật cùng một kết quả FP32, giữ trong một kho accumulator 64 KiB riêng. Tốc độ ma trận lấy từ con số 8.192 FLOPs mỗi chu kỳ mỗi SM cho B200 trong bài báo FlashAttention-4; tốc độ truyền đầu vào lấy là 256 byte/tick, cộng thêm 128 tick chờ sau khi truyền xong trước khi dữ liệu dùng được.
Nên mỗi khối đầu vào mất 64 tick để truyền, trở nên sẵn sàng sau 192 tick kể từ khi được phát hành, rồi cần 128 tick để tính.
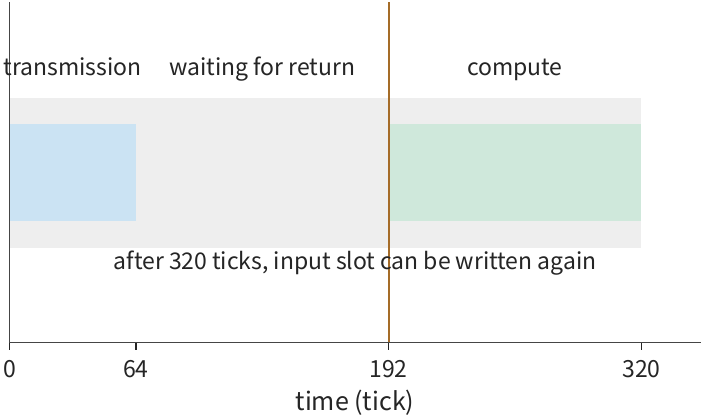
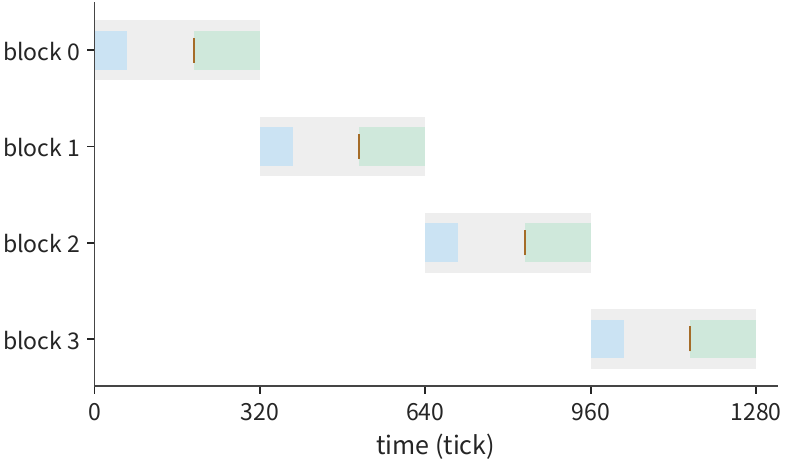
Với chỉ một input slot, slot đó trải qua nạp, chờ và tính, mất tick trước khi dùng lại được, nên cả bốn khối hoàn thành ở tick 1280.
Hình 4-18 đến Hình 4-20 lần lượt mô tả việc thực thi với một, hai và ba slot, giữ cùng một thang thời gian. Quét dọc theo các khoảng tính toán màu xanh lục để tìm khoảng trống rảnh, rồi nhìn lên trên để biết khối đầu vào tiếp theo sẵn sàng khi nào, sẽ lộ ra nguồn gốc của sự chờ đợi.
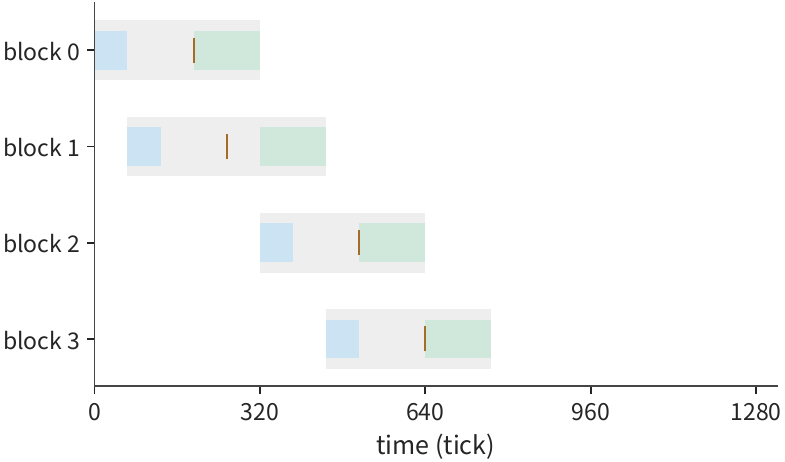
Hai slot cho phép phát hành yêu cầu đọc cho hai khối đầu tiên tại thời điểm 0 và 64. Khối đầu tiên bắt đầu tính ở 192 và xong ở 320; slot được giải phóng được dùng cho khối thứ ba, khối này sẵn sàng ở 512. Khối thứ hai đã tính xong ở 448, để lại một khoảng trống rảnh 64 tick. Tiếp tục theo thứ tự đó, khối thứ tư hoàn thành ở 768. Slot thứ hai cho phép một phần việc nạp chồng lấn với tính toán, nhưng ma trận unit vẫn ngồi không giữa các lần tính hai khối.
Để tính liên tục cả bốn khối, thời điểm hoàn thành sớm nhất là thời gian chờ của khối đầu tiên cộng bốn lần tính, tức
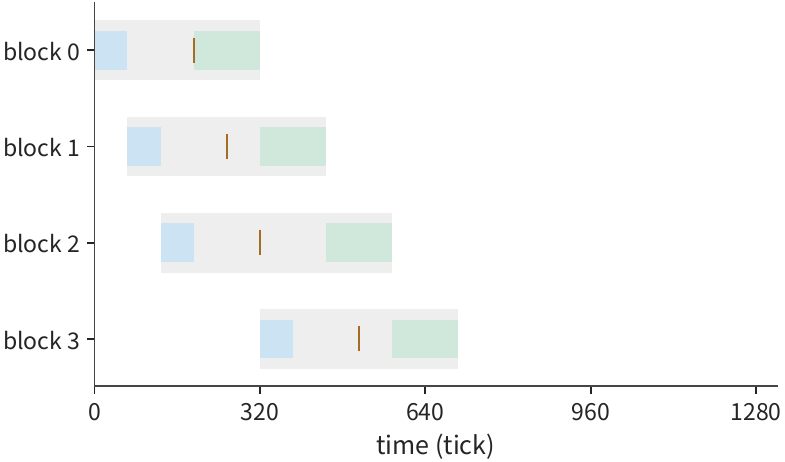
Ba slot đã đủ để đạt thời gian này. Yêu cầu đọc cho ba khối đầu tiên được phát hành lần lượt tại thời điểm 0, 64 và 128, và trở nên sẵn sàng lần lượt ở 192, 256 và 320; tính toán tiến hành tuần tự bắt đầu từ 192. Khối đầu tiên giải phóng slot ở 320, lập tức phát hành yêu cầu đọc cho khối thứ tư, khối này sẵn sàng ở 512 — sớm hơn thời điểm bắt đầu đã định trước là 576 cho phép tính của nó. Ma trận unit vì vậy tính liên tục từ tick 192 đến 704, không có khoảng trống rảnh giữa chừng.
| Input slots | Input buffer | Thời gian hoàn thành | Tiết kiệm so với trước |
|---|---|---|---|
| 1 | 16 KiB | 1280 tick | — |
| 2 | 32 KiB | 768 tick | 512 tick |
| 3 | 48 KiB | 704 tick | 64 tick |
| 4 | 64 KiB | 704 tick | 0 |
Ví dụ này minh họa một phương pháp tìm cấu hình buffer: trước tiên suy ra mục tiêu từ thời điểm đến của khối đầu tiên và thời gian tính liên tục, sau đó kiểm tra từng khối có thể đến đúng giờ không, cuối cùng tìm số slot tối thiểu đạt được mục tiêu. Dù slot thứ tư cho phép khối cuối sẵn sàng sớm hơn, nó không làm phép tính bắt đầu sớm hơn; dữ liệu được lấy về trước chỉ đơn giản nằm chờ lâu hơn trước khi được dùng.
Cấu hình buffer cũng thay đổi theo tốc độ tính toán. Sau khi nhân đôi tốc độ ma trận, phép tính mỗi khối chỉ còn 64 tick, và mục tiêu cho việc tính liên tục thành tick. Với chỉ ba slot, yêu cầu đọc của khối thứ tư sớm nhất có thể phát hành ở tick 256, chỉ dùng được ở tick 448 — muộn hơn thời điểm phép tính được lên lịch ban đầu ở 384 tick — nên thời gian hoàn thành là 512 tick; với bốn slot, tuy nhiên, mọi yêu cầu có thể được phát hành đủ sớm để đạt 448 tick. Một khi tính toán ma trận nhanh hơn, lịch nạp ban đầu không còn đủ nhanh để chuẩn bị khối tiếp theo, và phần đệm đầu vào phải được cấu hình lại.
Với việc di chuyển bất đồng bộ, một thread tính toán có thể tiếp tục làm việc khác sau khi phát hành một lượt tải, và chỉ chờ sự kiện hoàn thành khi thực sự cần dữ liệu. Đơn vị di chuyển ghi dữ liệu vào một slot trống, và một sự kiện hoàn thành đánh dấu dữ liệu đã sẵn sàng; slot chỉ được giải phóng sau khi phép tính hoàn tất. Bản sao bất đồng bộ của NVIDIA, MTE/NDDMA của Ascend và cơ chế phụ thuộc tác vụ của Metal đều được dùng để bố trí kiểu bàn giao này.
Suy nghĩ: Nếu khoảng chờ thêm trước khi đầu vào dùng được tăng gấp đôi, ba buffer slot có còn đủ không? Giữ nguyên tốc độ truyền và tính, tăng khoảng chờ thêm từ lúc truyền xong đến lúc đầu vào sẵn sàng từ 128 lên 256 tick. Ba slot có còn đạt được tính toán không khoảng trống không? Viết riêng thời điểm sẵn sàng của khối thứ tư và thời điểm nó được yêu cầu.
4.4.3 Bàn giao dữ liệu giữa các đơn vị
Việc pipeline đầu vào làm giảm thời gian ma trận unit chờ dữ liệu, nhưng attention còn phải bàn giao kết quả ma trận cho vector unit, rồi gửi xác suất trở lại ma trận unit. Lưu một ma trận điểm số FP32 đầy đủ chiếm 64 KiB; ma trận unit ghi nó một lần và vector unit đọc nó một lần, nên 128 KiB dữ liệu đi qua cùng một giao diện lưu trữ. Nếu ma trận unit chuyển trực tiếp kết quả cho vector unit, có thể bỏ qua lượt ghi rồi đọc lại trung gian này.
Thời điểm vector unit có thể bắt đầu còn phụ thuộc vào những kết quả trọn vẹn nào nó cần. Softmax theo từng hàng thông thường cần toàn bộ điểm số của một hàng trước khi tính được giá trị lớn nhất và mẫu số chuẩn hóa. Việc tính nửa chừng chiều tích trong QK khiến mọi điểm số chỉ là một tổng riêng phần; tuy nhiên, việc gom nhóm theo hàng query cho phép một nhóm hàng trọn vẹn hoàn tất và được bàn giao cho softmax trong khi những hàng còn lại tiếp tục tính toán ma trận. Hướng gom nhóm do đó quyết định vector unit có thể bắt đầu sớm hay không.
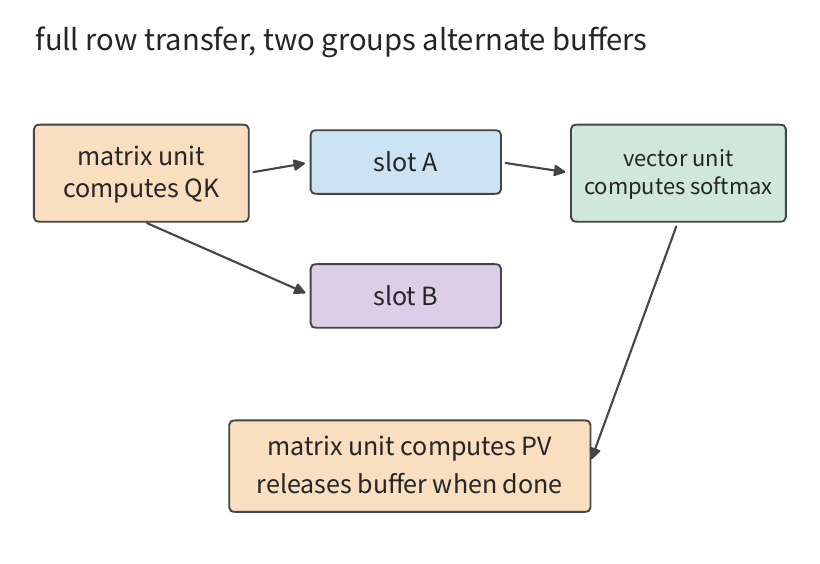
Tách 128 hàng thành bốn nhóm 32 theo hướng query, điểm số FP32 của một nhóm cộng xác suất BF16 cần KiB. Dưới đây ta so sánh các phương án dùng một và hai buffer để giữ dữ liệu bàn giao; mỗi buffer bị chiếm giữ từ bước QK của nhóm đó cho đến khi PV hoàn tất. QK và PV dùng chung ma trận unit, softmax dùng vector unit, và cả hai hướng dùng chung giao diện bàn giao. Với hai buffer, các nhóm khác nhau có thể thực thi những giai đoạn tính toán khác nhau cùng một lúc.
Ví dụ này chạy QK, softmax và PV trên các khối điểm số chữ nhật, lập lịch công việc đã sẵn sàng theo thứ tự nhóm hàng trọn vẹn. Tick vẫn là một chu kỳ đồng hồ của SM B200, với tốc độ ma trận 8.192 FLOPs/tick, giao diện bàn giao 128 byte/tick, và hàm mũ/phép chia 16 mỗi tick — lần lượt lấy từ tốc độ ma trận mỗi SM, băng thông đọc shared memory và tốc độ đơn vị hàm đặc biệt trong bài báo FlashAttention-4. Vector unit thực thi tuần tự các phép co giãn, trừ-cộng, so sánh, hàm mũ và chia, với phép toán thông thường và so sánh tại 128 mỗi tick. Với một nhóm 32 hàng, QK và PV mỗi cái mất 128 tick; các phép toán thông thường của softmax, so sánh, hàm mũ và chia mất lần lượt 96, 32, 256 và 256 tick, tổng cộng 640 tick. Bàn giao trực tiếp 16 KiB điểm số và 8 KiB xác suất mất lần lượt 128 và 64 tick, trong khi đường ghi-rồi-đọc mất lần lượt 256 và 128 tick. Mỗi bước được làm tròn lên đến tick nguyên gần nhất.
| Chế độ bàn giao | Cỡ nhóm hàng | Slot | Vector unit bắt đầu tính | Thời gian hoàn thành |
|---|---|---|---|---|
| Ghi vào lưu trữ rồi đọc | 128 | 1 | 1536 tick | 5118 tick |
| Ghi vào lưu trữ rồi đọc | 32 | 1 | 384 tick | 5120 tick |
| Ghi vào lưu trữ rồi đọc | 32 | 2 | 384 tick | 3200 tick |
| Bàn giao trực tiếp | 32 | 2 | 256 tick | 3008 tick |
| Bàn giao trực tiếp | 32 | 4 | 256 tick | 3008 tick |
Trước tiên, chỉ thay đổi việc gom nhóm. Vector unit bắt đầu tính sớm hơn, chuyển từ 1536 lên 384 tick, nhưng tổng thời gian vẫn khoảng 5120 tick. Lý do là chỉ có một slot: khi nhóm này bước vào softmax, kết quả của nó vẫn chiếm slot, không còn chỗ cho QK của nhóm kế tiếp ghi vào, nên nhóm kế tiếp phải chờ PV của nhóm hiện tại xong. Bắt đầu sớm hơn rút ngắn thời gian chờ của nhóm đầu tiên nhưng không cho các nhóm liền kề chồng lấn nhau.
Thêm slot thứ hai cho phép nhóm kế tiếp tiến triển dùng slot còn lại, đưa tổng thời gian xuống 3200 tick, giảm khoảng 38%. Tiếp theo là chuyển sang bàn giao trực tiếp, giảm số byte đi qua giao diện lưu trữ trong mỗi lần bàn giao, đưa tổng thời gian xuống 3008 tick, tiết kiệm khoảng 6%. Thêm slot nữa không làm đổi nhịp của đơn vị chậm nhất, nên thời gian hoàn thành không đổi.
Gom nhóm tạo ra các kết quả trọn vẹn sớm hơn, slot thứ hai cho các nhóm liền kề chồng lấn nhau, và đường trực tiếp rút ngắn thời gian bàn giao. Ba thay đổi này lần lượt làm đổi các phụ thuộc, số nhóm có thể tiến triển đồng thời, và khối lượng công việc của giao diện; Mục 4.6.2 sẽ gán ba thay đổi này lên quá trình tiến hóa kiến trúc của Ascend.
Thí nghiệm 4-4 · Cốt lõi: Cần bao nhiêu đệm trên chip để duy trì tính toán liên tục
Vẽ thời gian biểu của việc pipeline đầu vào với từ một đến bốn buffer slot, và dựa trên các thời điểm dữ liệu đến, phép tính hoàn thành và buffer giải phóng, xác định số slot tối thiểu để duy trì tính toán liên tục; sau đó nhân đôi tốc độ ma trận và giải thích số slot tối thiểu thay đổi như thế nào. Tiếp theo, vẽ thời gian biểu của mỗi nhóm hàng query đi qua QK, softmax và PV, phân biệt thời gian tiết kiệm được nhờ gom nhóm, nhờ thêm slot, và nhờ bàn giao trực tiếp. Cuối cùng, dưới một dung lượng trên chip cố định, phân tích kích thước buffer của mỗi nhóm giới hạn số nhóm có thể cư trú đồng thời ra sao.
4.5 Đóng gói nhiều chip và interconnect
Khi một accelerator không đáp ứng nổi yêu cầu tính toán hoặc lưu trữ, có thể phân tán tính toán và lưu trữ lên nhiều chip. Mở rộng thêm tài nguyên nhưng cũng làm tăng khoảng cách giữa các đơn vị sinh dữ liệu và các đơn vị tiêu dùng dữ liệu. Mục này đi theo ba loại kết nối — trong một package, giữa host và accelerator, và giữa các accelerator — để phân tích vị trí đặt dữ liệu và độ hạt truyền ảnh hưởng đến thời gian hoàn thành như thế nào.
4.5.1 Chip tính toán, bộ nhớ và kết nối trong một package
Một package có thể chứa nhiều die, cùng nhau cung cấp các compute unit và giao diện bộ nhớ. Cả các sản phẩm datacenter Blackwell lẫn Ascend 910C đều dùng thiết kế hai die: mỗi die cung cấp khả năng tính toán cục bộ và một giao diện lưu trữ, còn liên kết trong package lo việc trao đổi dữ liệu giữa các die. Với dung lượng mở rộng, nhiều model có thể cư trú hơn; phép tính được đặt ở phía nào quyết định bao nhiêu lượt truy cập phải đi qua liên kết.
Hãy tính điều này cho hai sản phẩm hai die. HGX B200 có 180 GB HBM mỗi GPU và 8 TB/s băng thông, với tám chồng HBM chia đều cho hai die, cho mỗi die 90 GB cục bộ ở 4 TB/s, trong khi liên kết NV-HBI giữa hai die là 10 TB/s. Ascend 910C có 64 GB cục bộ mỗi die ở 1,6 TB/s, với liên kết giữa die 270 GB/s mỗi hướng. Mỗi die lưu 32 GiB trọng lượng, và ở một giai đoạn nào đó cả 64 GiB phải được đọc qua một lần, với toàn bộ phép tính đặt lên die 0. Die 0 đọc 32 GiB của chính mình từ HBM cục bộ trong khi đồng thời đọc 32 GiB của die 1 qua liên kết. Dữ liệu liên die trước tiên phải được đọc ra khỏi HBM của die 1, rồi đi qua liên kết, với tốc độ bị giới hạn bởi cái chậm hơn trong hai cái; đường cục bộ và đường liên die dùng các giao diện khác nhau nên có thể tiến hành đồng thời, vì vậy thời gian của giai đoạn này được quyết định bởi đường nào chậm hơn.
NV-HBI của B200 nhanh hơn HBM của mỗi die: bản brief kỹ thuật không nêu rõ con số 10 TB/s có phải là tổng hai chiều hay không, nhưng ngay cả khi tính nó là tổng hai chiều ở 5 TB/s mỗi hướng, con số đó vẫn vượt 4 TB/s của mỗi die. Nên lượt đọc liên die vẫn bị quản bởi 4 TB/s của die 1, và cả đọc cục bộ lẫn đọc liên die đều mất khoảng 8,6 ms, nên cả giai đoạn mất khoảng 8,6 ms — giống hệt trường hợp mỗi die đọc trọng lượng cục bộ của riêng mình: đặt phép tính ở phía nào cũng không làm đổi thời gian đọc. Băng thông liên kết mỗi hướng của 910C chỉ khoảng 17% băng thông HBM cục bộ của nó: đọc cục bộ mất khoảng 21,5 ms, còn đọc liên die mất khoảng 127 ms, nên cả giai đoạn bị quản bởi liên kết. Chuyển phép tính cho trọng lượng của die 1 sang die 1 để mỗi phía đọc trọng lượng cục bộ của riêng mình, chỉ cần khoảng 21,5 ms; thứ đi qua liên kết đổi từ 32 GiB trọng lượng thành đầu vào và kết quả, và nếu chúng tổng cộng 64 MiB, việc truyền chúng qua liên kết 270 GB/s mất khoảng 0,25 ms.
Sự khác biệt giữa hai sản phẩm được quyết định bởi tỷ số giữa băng thông liên kết giữa die và băng thông HBM cục bộ của mỗi die. Với B200 tỷ số này là 2,5, nên đọc liên die nhanh ngang đọc cục bộ, và hai die có thể được dùng như một GPU. Với 910C tỷ số khoảng 0,17, nên đọc liên die mất khoảng 5,9 lần thời gian đọc cục bộ. Supernode CloudMatrix384 của Huawei, xây từ 384 die Ascend 910C, cũng triển khai expert theo die khi decode DeepSeek-R1, đặt đúng một expert mỗi die. Khi tỷ số nhỏ hơn 1, compute unit nên tái sử dụng cục bộ, lặp đi lặp lại, các khối trọng lượng lớn, và chỉ trao đổi giữa các die những đầu vào và kết quả nhỏ hơn.
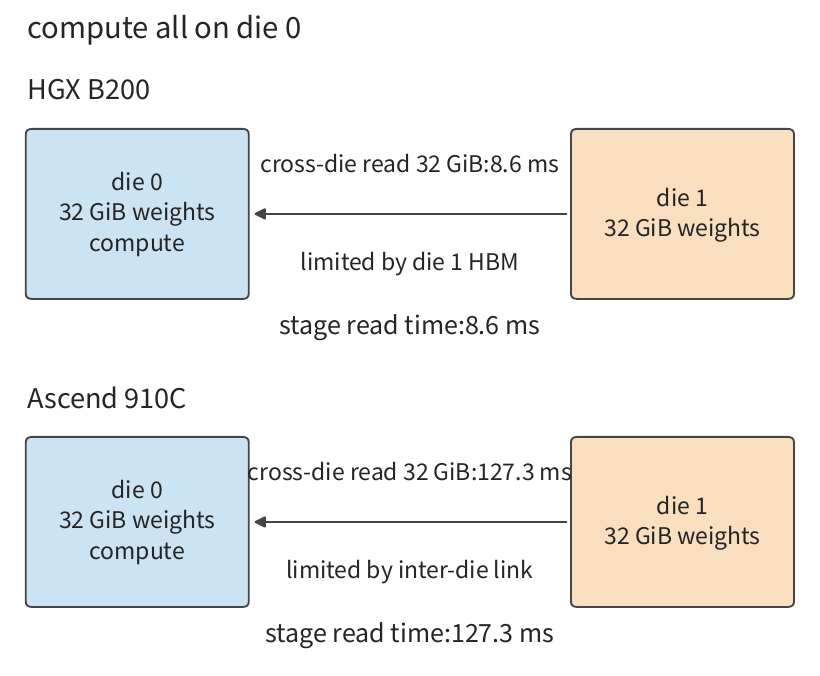
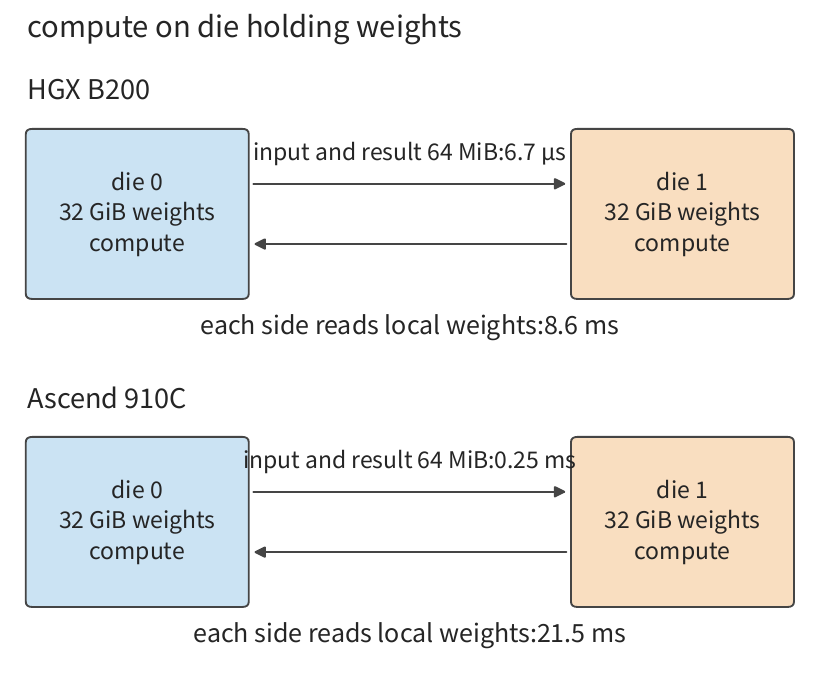
Hình 4-22 và Hình 4-23 so sánh vị trí tương đối của compute unit và trọng lượng: đường tính tập trung di chuyển trọng lượng, còn đường tính ngay tại chỗ di chuyển đầu vào và lấy về kết quả. Khi quyết định cách phân tán các tác vụ tính toán, trước hết phác thảo dữ liệu phải đi qua liên kết theo từng phương án, rồi so sánh tổng.
Cách đặt này cũng tạo ra cơ hội song song: các lượt đọc cục bộ và tính toán ở cả hai phía có thể tiến hành độc lập, với kết quả bàn giao ở cuối. Việc hai phía có phải chờ nhau hoàn tất hay không do đồ thị tính toán của model quyết định; nếu bước kế tiếp phải gộp các tổng riêng phần, một điểm đồng bộ hình thành ở đó. Chương 6 sẽ suy ra những lần bàn giao này từ các phương án phân vùng song song cụ thể.
4.5.2 Truy cập dữ liệu giữa CPU và accelerator
Vị trí dữ liệu trong package quyết định việc truyền liên die; những vấn đề tương tự cũng xuất hiện bên ngoài chip. Hình 4-2 cho thấy lượt bàn giao dữ liệu giữa host và accelerator: dữ liệu do CPU chuẩn bị cần được chuyển cho GPU dùng. Đầu vào do CPU chuẩn bị thường được đặt trước trong bộ nhớ host, và một GPU có bộ nhớ GPU chuyên dụng phải lấy dữ liệu này qua PCIe hoặc kết nối dành riêng cho nền tảng. Host-to-device gọi là H2D, device-to-host gọi là D2H. Một copy engine di chuyển dữ liệu qua truy cập bộ nhớ trực tiếp (DMA) dùng các địa chỉ đã chuẩn bị, và CPU có thể chuyển sang việc khác sau khi gửi lệnh sao chép.
Khi cùng một tensor trước được tải lên qua liên kết host rồi được GPU đọc từ bộ nhớ GPU, thời gian truyền và thời gian đọc phải tính riêng. Lấy RTX 4090 làm ví dụ: card này nối với host qua PCIe 4.0 x16 (16 lane), với băng thông tổng hai chiều danh nghĩa 64 GB/s, tức 32 GB/s mỗi hướng; băng thông bộ nhớ GPU của nó là 1.008 GB/s. Giả sử đầu vào là 64 MiB, và gác lại chi phí khởi động:
Thời gian tải lên gấp 31,5 lần một lượt đọc bộ nhớ GPU, đúng bằng tỷ số băng thông của hai đường. Nếu dữ liệu chỉ dùng một lần, việc truyền qua host chiếm ưu thế trong thời gian; nếu nó được tái sử dụng lần trên accelerator sau khi tải lên, mỗi lần dùng sẽ amortize . Sau 100 lần tái sử dụng, thời gian tải lên amortize trung bình mỗi lần giảm xuống khoảng 21 μs. Mỗi lần gọi sau chỉ cần gửi địa chỉ và tham số thực thi, trong khi toàn bộ dữ liệu vẫn cư trú trong bộ nhớ GPU.
Ta cũng có thể tìm số lần tái sử dụng tối thiểu bắt buộc: khi , thời gian tải lên amortize mỗi lần không còn lớn hơn một lượt đọc của accelerator. Điều này nghĩa là cải thiện băng thông liên kết host quan trọng hơn với đầu vào dùng một lần, còn giữ trọng lượng cư trú có thể loại bỏ các lượt tải lên lặp lại.
Copy engine và compute unit là các tài nguyên thực thi độc lập, nên batch tiếp theo có thể được tải lên trong khi GPU tính batch hiện tại. Để tạo thành pipeline, hai input buffer lần lượt giữ batch hiện tại và batch kế tiếp, và hai buffer hoán đổi vai trò khi phép tính của batch hiện tại hoàn tất; đây chính xác là double buffering của Mục 4.4 áp cho liên kết host. Nếu lượt ghi của bản sao và lượt đọc của phép tính dùng chung một giao diện bộ nhớ, giao diện đó phải mang cả hai luồng lưu lượng.
Không phải nền tảng nào cũng cần lượt sao chép này. CPU và GPU của Apple dùng chung bộ nhớ vật lý, và khi dùng một buffer truy cập được từ cả hai phía, GPU có thể đọc từ cùng một bộ nhớ đó một khi CPU đã ghi dữ liệu và hoàn tất đồng bộ. So với phương án bộ nhớ GPU chuyên dụng, thứ bị loại bỏ là lượt sao chép H2D riêng biệt và thời gian truyền của nó; lượt đọc sau đó của GPU vẫn do hệ thống bộ nhớ phục vụ. Unified memory biến lượt bàn giao dữ liệu từ “sao chép, rồi dùng” thành “đồng bộ, rồi dùng”.
Một không gian địa chỉ hợp nhất cho phép CPU và GPU tham chiếu dữ liệu bằng cùng một tập địa chỉ ảo. CUDA là nền tảng lập trình và runtime GPU của NVIDIA; cơ chế Unified Memory của nó có thể di trú các trang theo quy tắc của nền tảng, nên địa chỉ giữ nguyên trong khi vị trí vật lý có thể thay đổi. Khoảng cách giữa dữ liệu và bộ xử lý dùng nó ảnh hưởng đến thời gian truy cập, còn cơ chế địa chỉ và đồng bộ cho phép bộ xử lý định vị dữ liệu và chỉ đọc sau khi lượt ghi đã hoàn tất.
4.5.3 Trao đổi dữ liệu giữa các accelerator
Ví dụ tải lên từ host nhấn mạnh sự cư trú và tái sử dụng dữ liệu. Các card cũng thường xuyên trao đổi kích hoạt, đầu vào expert hoặc kết quả riêng phần, và khối lượng dữ liệu mỗi lần truyền khác nhau; ngoài số byte, còn phải tính chi phí cố định mỗi lần truyền. Một lần truyền phải gửi yêu cầu, thông báo trạng thái hoàn thành cho bên nhận, và mang dữ liệu qua liên kết. Dùng chi phí cố định , băng thông hiệu quả một chiều , và khối lượng dữ liệu , thời gian điểm-đến-điểm là
Lấy một máy chủ HGX H100 làm ví dụ: trong máy, mỗi H100 nối với các GPU khác qua NVLink, với băng thông tổng hai chiều 900 GB/s, tức GB/s mỗi hướng; NVLink của A100 SXM là 300 GB/s mỗi hướng. Lấy chi phí cố định μs — cùng giá trị dùng cho mỗi lượt khởi động NVLink giữa các máy trong Chương 7 — giả sử ta truyền kích hoạt BF16 có hình dạng , cho khối lượng dữ liệu byte. Ở khối lượng dữ liệu chỉ 8 KiB, mất khoảng 0,02 μs để truyền trên H100, tổng khoảng 2,02 μs; ở khối lượng dữ liệu 2 MiB, mất khoảng 4,66 μs để truyền, tổng khoảng 6,66 μs.
Từ A100 sang H100, băng thông cải thiện lên 1,5 lần, vậy mà thời gian truyền 8 KiB chỉ giảm từ 2,03 xuống 2,02 μs, trong khi với 2 MiB giảm từ 8,99 xuống 6,66 μs, giảm khoảng 26%. Nếu thay vào đó ta giảm một nửa chi phí cố định trên H100, thời gian truyền cho khối lượng dữ liệu nhỏ giảm gần một nửa, còn truyền dữ liệu lớn cũng tiết kiệm khoảng 15%. Hai hướng tối ưu nhắm vào những thuật ngữ chi phối khác nhau của công thức.
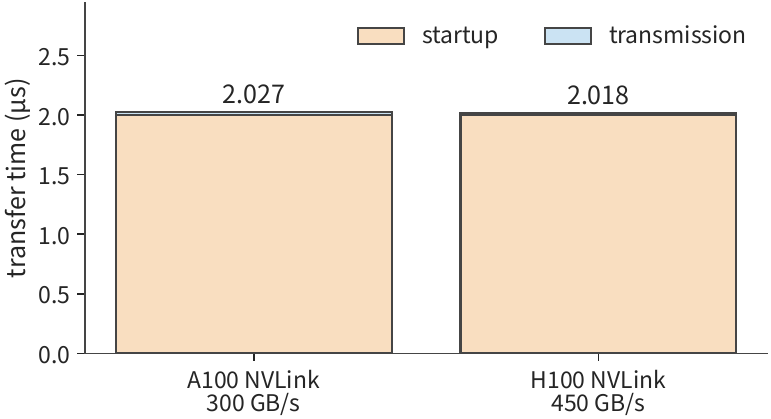
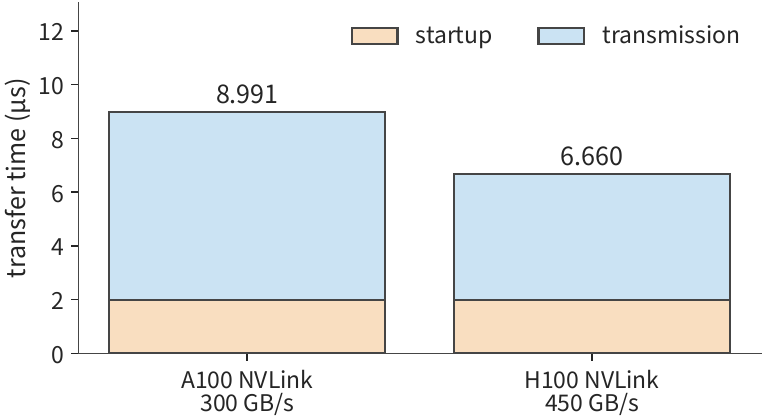
Đặt hai thuật ngữ bằng nhau cho ra điểm giao cắt về khối lượng dữ liệu:
Với ví dụ kích hoạt của ta, con số này tương ứng với , nghĩa là chỉ từ hàng 110 trở đi thời gian truyền mới vượt chi phí cố định. Liên kết càng nhanh, điểm giao cắt càng lớn, và càng nhiều lượt truyền rơi vào phía do chi phí cố định chi phối. Dưới quy mô này, việc gộp nhiều lượt truyền thành một làm giảm chi phí khởi động amortize mỗi đơn vị dữ liệu; trên quy mô này, lợi ích của việc giảm số byte hay tăng băng thông lại rõ rệt hơn. Gộp nhiều mẩu dữ liệu đã sẵn sàng vào một lượt gửi làm giảm số lần khởi động; chờ dữ liệu chưa sẵn sàng để gộp vào một gói lớn hơn lại làm tăng thời gian xếp hàng. Độ hạt truyền do đó cũng chứa đựng một sự đánh đổi giữa thông lượng và thời gian phản hồi.
Nếu một lần thực thi có 100 lượt trao đổi khối lượng dữ liệu nhỏ phải tuần tự hóa, mỗi lượt mất 2 μs, riêng chi phí cố định đã lên tới 200 μs. Chi phí cố định thậm chí còn lớn hơn giữa các máy chủ: một all-reduce 16 byte (AllReduce — gộp đóng góp cục bộ của mỗi card và đưa cho mọi card kết quả hoàn chỉnh) duy nhất giữa hai máy chủ HGX H100 tổng cộng 16 card đã được đo công khai khoảng 25 μs, nên 100 lượt như vậy sẽ mất 2,5 ms. Trong trường hợp này, ngay cả việc giảm một phần dữ liệu được truyền cũng khó làm tổng thời gian giảm đi đáng kể, trong khi giảm số vòng trao đổi trực tiếp rút ngắn chuỗi phụ thuộc. AllReduce nối chuỗi nhiều lượt truyền và reduction; Chương 6 sẽ tính riêng số vòng, số byte truyền mỗi liên kết, và khoảng thời gian mà việc truyền và tính toán có thể chồng lấn.
NVLink, Unified Bus của Huawei và các interconnect tương tự cung cấp các đường truyền giữa các thiết bị, còn các thông báo hoàn thành cho phép bên nhận bắt đầu tính một khi dữ liệu đã đến.
Thí nghiệm tư duy: Việc gộp các lượt gửi thay đổi thời gian hoàn thành và thời điểm phản hồi cho mẩu dữ liệu đầu tiên như thế nào? Bốn mẩu dữ liệu 8 KiB trở nên sẵn sàng lần lượt ở 0, 1, 2 và 3 μs. Vẫn dùng NVLink của H100 ở 450 GB/s mỗi hướng và 2 μs khởi động mỗi lượt gửi, so sánh trên cùng một liên kết giữa việc gửi từng mẩu ngay khi nó sẵn sàng với việc chờ tất cả rồi gửi gộp: khi nào toàn bộ dữ liệu đến? Và khi nào mẩu dữ liệu đầu tiên trở nên dùng được bởi bên nhận?
4.6 Nhu cầu của model thúc đẩy sự tiến hóa kiến trúc
Các mục 4.2–4.5 đã phân tích riêng tính toán, lưu trữ, di chuyển và interconnect. Mục này đặt lại những thành phần đó vào quá trình tiến hóa thế hệ của NVIDIA, Ascend và Apple, tính cụ thể mỗi cơ chế mới thêm vào đã loại bỏ công việc gì và thay đổi yêu cầu tài nguyên nào, rồi giải thích những thay đổi đó đáp ứng tải công việc của model ra sao.
Dưới đây ta so sánh từng hạng mục sự thay đổi của ma trận unit, định dạng số, đường dữ liệu và dung lượng; mỗi phép so sánh giữ cố định cùng một tải công việc model trong khi chỉ thay đổi phần cứng hoặc biểu diễn đang xét. Các tham số phần cứng và việc tính lại đều có trong các bản ghi tính toán kèm theo.
4.6.1 NVIDIA: Ma trận unit, độ chính xác và đường dữ liệu mỗi thứ mang lại lợi ích bao nhiêu
Giá trị của Tensor Core, trước tiên tính bằng hai đường trên cùng một chip. Thông lượng đỉnh FP32 thông thường của Volta V100 SXM2 là 15,7 TFLOP/s, đỉnh Tensor Core với đầu vào FP16 và tích lũy FP32 là 125 TFLOP/s, và băng thông HBM2 của nó là 900 GB/s. Vẫn lấy projection của chương này, với đầu vào và trọng lượng lưu ở FP16 và kết quả cũng được viết thành FP16: đường thông thường chuyển các operand sang FP32 trước khi nhân–cộng, còn đường Tensor Core trực tiếp thực thi phép nhân–cộng ma trận hỗn hợp độ chính xác, tức đầu vào FP16 với tích lũy FP32. Cả hai đường đọc và ghi cùng một lượng dữ liệu.
Xử lý 4.096 hàng một lúc, phép tính ma trận là GFLOPs, với đầu vào, trọng lượng và đầu ra tổng 96 MiB. Phép nhân–cộng FP32 thông thường cần ms, Tensor Core cần ms, và lượt đọc cùng ghi lại cần khoảng 0,112 ms. Thời gian ma trận giảm xuống còn khoảng một phần tám, vì một khối lượng lớn phép nhân–cộng đều đặn được trao cho một đơn vị chuyên dụng.
Giờ giảm đầu vào xuống một hàng. Thời gian ma trận của hai đường thành khoảng 2,14 μs và 0,268 μs, trong khi việc truyền 32 MiB trọng lượng cùng đầu vào và đầu ra mất khoảng 37,3 μs. Cả hai đường giờ đều bị giới hạn bởi việc đọc dữ liệu. Cùng một cải tiến Tensor Core mang lại lợi ích đáng kể cho phép nhân ma trận batch lớn nhưng chẳng giúp được gì cho lượt gọi một hàng này, nơi thứ vẫn cần tăng tốc là lượt đọc trọng lượng.
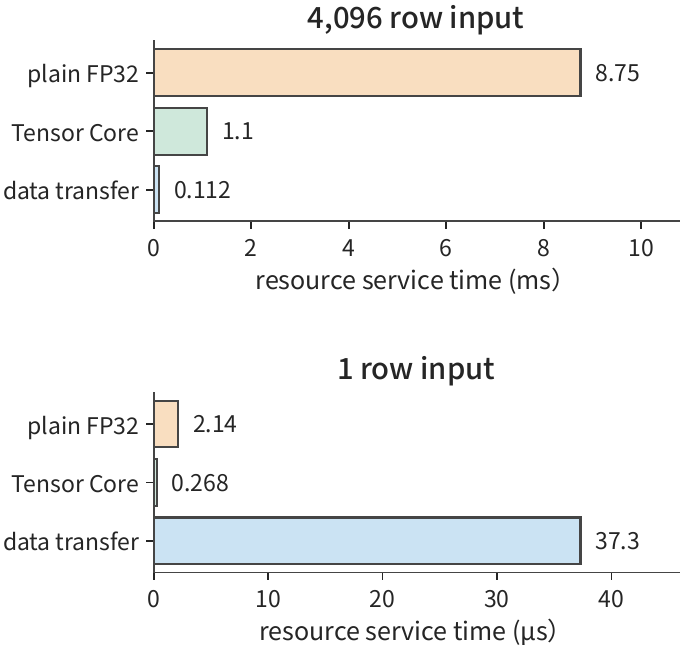
Sự tiến hóa của độ chính xác đồng thời thay đổi khoảng số, khối lượng lưu trữ và các lệnh được thực thi. Turing thêm INT8 và INT4 vào Tensor Core, mở rộng suy luận số nguyên bit thấp; Ampere thêm BF16, TF32 và độ thưa có cấu trúc 2:4 — TF32 giữ nguyên khoảng số mũ của FP32 trong phép nhân ma trận trong khi rút ngắn phần định trị, còn độ thưa 2:4 tổ chức tính toán với hai giá trị khác không trong mỗi bốn phần tử. Transformer Engine của Hopper kết hợp các lệnh ma trận FP8 với quản lý thang chia, và Blackwell tiếp tục hỗ trợ block scaling và FP4.
Lấy BF16 được thêm vào làm ví dụ. FP16 và BF16 đều chiếm hai byte, nên việc chuyển sang BF16 để nguyên 32 MiB trọng lượng trước đây không đổi. Một số dấu chấm động biểu diễn một giá trị như một định trị nhân một lũy thừa của hai; các số chuẩn (normal) chuẩn hóa phần định trị, còn các số dưới chuẩn (subnormal) dần giảm số bit có nghĩa trong một khoảng giá trị nhỏ hơn. BF16 dùng số mũ tám bit, với số chuẩn nhỏ nhất khoảng ; FP16 dùng số mũ năm bit, với số chuẩn nhỏ nhất khoảng và số dưới chuẩn dương nhỏ nhất khoảng . Một gradient được làm tròn trực tiếp sang FP16 thành số 0, trong khi BF16 vẫn biểu diễn được nó. Điều này làm giảm nhu cầu, trong huấn luyện, phải điều chỉnh thang để tránh tràn (overflow) và dưới tràn (underflow). Cái giá phải trả là ít chữ số có nghĩa hơn: gần giá trị 1, các giá trị BF16 liền kề cách nhau , so với của FP16. Đầu vào độ chính xác thấp ghép với tích lũy FP32 xử lý riêng biệt biểu diễn đầu vào và lỗi tích lũy của tích trong dài.
Giờ xét khối lượng lưu trữ. Theo định dạng khối ở Mục 4.2.4, mỗi 32 giá trị dùng chung một thang chia một byte — MX là tên của định dạng microscaling này. MXFP8 cần MiB, và MXFP4 cần MiB. Đọc bộ trọng lượng BF16 này ở băng thông 1.008 GB/s của RTX 4090 mất 33,29 μs; đọc cùng bộ trọng lượng BF16 ở 1.792 GB/s của RTX 5090 mất 18,72 μs, còn đọc bộ trọng lượng MXFP4 mất 4,97 μs. Bước giảm thứ nhất đến từ việc tăng băng thông, còn bước giảm thứ hai đến từ thay đổi độ rộng bit và biểu diễn theo nhóm.
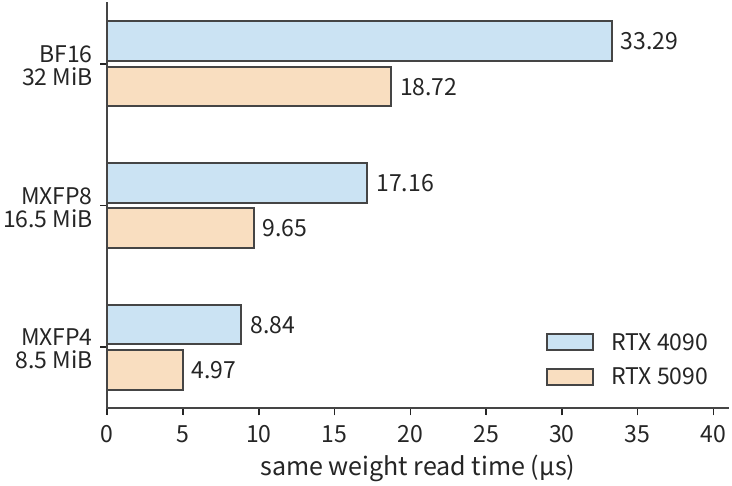
Từ 33,29 μs xuống 4,97 μs, ngân sách đọc trọng lượng thu nhỏ còn khoảng 1/6,69. Lợi ích này đến từ hai hệ số nhân: băng thông tăng khoảng 1,78 lần, và khối lượng lưu trữ thu nhỏ còn khoảng 1/3,76. Đường ma trận độ chính xác thấp nguyên bản xử lý trực tiếp biểu diễn đã nén, loại bỏ bản sao trọng lượng độ chính xác cao mà đường mở rộng trước ở Mục 4.2.4 bắt buộc phải có.
Khi ma trận unit ngày càng nhanh, kiến trúc bắt đầu giảm bớt việc chuẩn bị và chờ đợi xung quanh chúng. Bản sao bất đồng bộ của Ampere loại bỏ đường chuyển tiếp qua thanh ghi tổng quát giữa global memory và shared memory; TMA của Hopper đảm nhận việc sinh địa chỉ đa chiều và di chuyển, ghép với việc thực thi ma trận bất đồng bộ; SM100 datacenter của Blackwell dùng Tensor Memory (TMEM) để giữ kết quả tích lũy ma trận. Ba thay đổi này lần lượt làm thay đổi các lệnh di chuyển, mức chiếm của các thanh ghi tổng quát, và nơi lưu các kết quả trung gian.
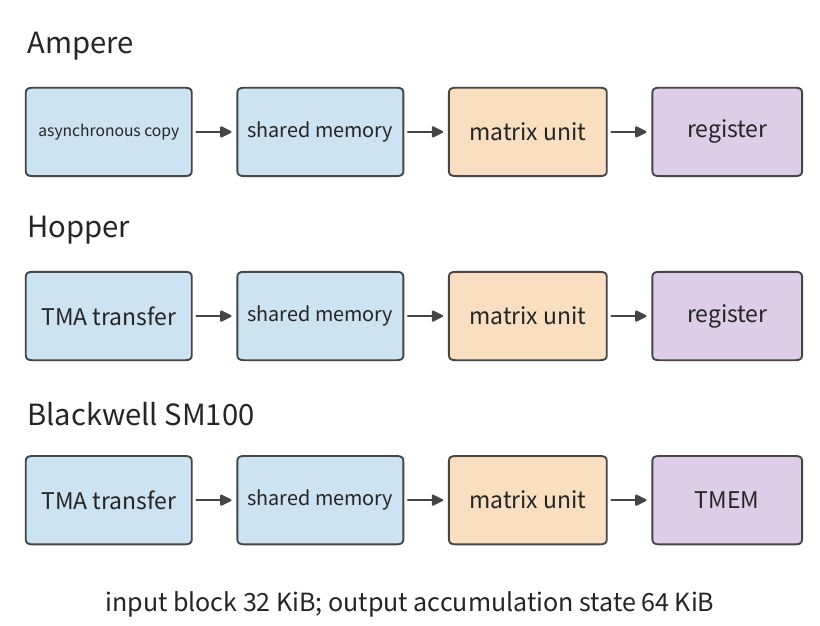
Khối tính ở Mục 4.3.2 cần 32 KiB đầu vào và 64 KiB kết quả tích lũy. Ba nhóm đầu vào cộng một nhóm kết quả tổng cộng 160 KiB; TMEM giữ độc lập 64 KiB trong số này, giải phóng các thanh ghi tổng quát cho các trạng thái thread khác. Đây chính là thay đổi trực tiếp mà một kho lưu trữ chuyên dụng mới được thêm vào mang lại cho sự cư trú của tải công việc.
Tiến thêm một thế hệ nữa, thông lượng số mũ FP32 của Rubin gấp đôi so với Blackwell, và thông lượng số mũ BF16/FP16 của nó tăng lên 4 lần, đáp ứng nút thắt số mũ đã lộ ra sau khi ma trận unit được tăng tốc trong Ví dụ 4-1. Rubin cũng cho phép TMA cập nhật địa chỉ và stride của expert: khi MoE chuyển expert, hình dạng ma trận có thể giữ nguyên, chỉ cần đổi vị trí trọng lượng, nên việc cập nhật descriptor loại bỏ công việc chuẩn bị địa chỉ lặp đi lặp lại.
Làm sao đặt được các sản phẩm consumer, workstation và datacenter trong cùng một bảng? Giữ cố định đầu vào BF16, tích lũy FP32 và phép tính ma trận đặc, các tham số như sau. RTX 3090, 4090 và 5090 lần lượt dùng Ampere, Ada và Blackwell; A100 và H100 lần lượt dùng Ampere và Hopper.
| Model và dòng sản phẩm | Dung lượng GB | Băng thông GB/s | Ma trận đặc BF16/FP32 TFLOP/s |
|---|---|---|---|
| RTX 3090, consumer | 24 | 936 | 71,0 |
| RTX 4090, consumer | 24 | 1.008 | 165,2 |
| RTX 5090, consumer | 32 | 1.792 | 209,5 |
| RTX PRO 6000 Blackwell, workstation | 96 | 1.792 | 503,8 |
| A100 80GB SXM, datacenter | 80 | 2.039 | 312,0 |
| H100 SXM, datacenter | 80 | 3.350 | 989,4 |
| H200 SXM, datacenter | 141 | 4.800 | 989,5 |
RTX 3090 và 4090 có cùng dung lượng, và tốc độ ma trận BF16 tăng khoảng 2,33 lần, trong khi băng thông chỉ tăng khoảng 7,7%. Cái trước chủ yếu rút ngắn việc tính toán ma trận lớn, còn cái sau chính là thứ trực tiếp rút ngắn lượt đọc trọng lượng một hàng. Dung lượng của RTX 5090 tăng lên 32 GB, và băng thông tiếp tục tăng lên khoảng 1,78 lần; đường FP4 mới thêm vào cũng cung cấp một phương thức thực thi khác cho những model chấp nhận được độ chính xác thấp. Ba thế hệ sản phẩm này lần lượt thay đổi các ngân sách tài nguyên cho xử lý ma trận, đọc trọng lượng và cư trú model.
RTX PRO 6000 và RTX 5090 dùng chung băng thông 1.792 GB/s; những điểm bổ sung chính của card workstation gồm 96 GB bộ nhớ trang bị ECC, thông lượng tích lũy BF16/FP32 cao hơn, và Multi-Instance GPU (MIG) — chia một GPU thành các instance cô lập tài nguyên. Với việc đọc tuần tự các trọng lượng cùng kích thước, hai thẻ có cùng ngân sách băng thông; với ma trận lớn hoặc dữ liệu cư trú vượt 32 GB, kết quả sẽ khác nhau. SM120 và SM100 là hai kiến trúc lệnh SM khác nhau. Blackwell consumer và workstation dùng SM120; Blackwell datacenter như B200 dùng SM100, vốn dùng TMEM và các lệnh ma trận tương ứng đã giới thiệu ở trên, và phần mềm chọn kernel theo kiến trúc đích.
Các card datacenter cũng cung cấp HBM và interconnect tốc độ cao hướng tới việc dùng nhiều card. Băng thông tổng hai chiều NVLink của A100 SXM là 600 GB/s, và của H100 SXM là 900 GB/s, quy đổi một chiều lần lượt là 300 và 450 GB/s mỗi hướng. Theo phương pháp của Mục 4.5, thời gian tuần tự hóa trên liên kết (khối lượng dữ liệu chia băng thông một chiều) để truyền 64 MiB dữ liệu lần lượt khoảng 224 và 149 μs. Khi quy mô tính toán tăng, tensor parallelism (chia các ma trận trong cùng một layer ra nhiều card) khiến những kết nối này được dùng lặp đi lặp lại cho giao tiếp mỗi layer, trao đổi gradient huấn luyện và điều phối expert. RTX 4090 và 5090 không có NVLink; RTX 3090 hỗ trợ NVLink hai card. Chương 6 và 7 sẽ dùng các tham số liên kết này để tính thời gian chia tensor, trao đổi gradient và điều phối expert.
Quay lại phép so sánh giữa tính toán và băng thông: từ A100 sang H100, tốc độ ma trận BF16 tăng khoảng 3,17 lần và băng thông tăng khoảng 1,64 lần, đồng thời FP8, TMA và các cơ chế cộng tác mới được thêm vào. Từ H100 sang H200, những điểm bổ sung chính là dung lượng và băng thông, với tốc độ ma trận BF16 trong bảng về cơ bản không đổi. Hai bộ thay đổi này tương ứng với “đổi tính toán và việc tổ chức thực thi cùng nhau” và “giữ khả năng tính toán cố định trong khi tăng cường lưu trữ”. Khi thay các tải công việc model vào ở Mục 4.8.2, ta sẽ phán đoán được bộ tăng trưởng nào tỏ ra hữu ích hơn.
4.6.2 Ascend: từ trải phẳng tích chập CNN đến bàn giao ma trận–vector của Transformer
Khi Ascend 910 đời đầu (được gọi là 910A trong các so sánh thế hệ sau) được thiết kế, các mạng nơ-ron tích chập (CNN) như ResNet chiếm phần lớn tải công việc huấn luyện. Bản tổng kết thiết kế của tác giả ghi lại bối cảnh này; bài báo DaVinci mô tả thêm sự phân công lao động giữa Scalar, Vector, Cube và MTE. MTE gồm các module img2col, transpose và decompression, trong đó img2col sắp xếp các cửa sổ tích chập thành đầu vào ma trận ngay trong lúc di chuyển dữ liệu. Trước tiên ta tính xem khả năng chuyên biệt này tiết kiệm được gì trong CNN, rồi chuyển tải công việc sang Transformer.
Tại sao việc trải phẳng tích chập đáng giao cho phần cứng? Lấy tích chập kiểu ResNet với đầu vào , số kênh đầu ra 64, bước trượt 1 và phần đệm giữ nguyên kích thước không gian. Đầu vào lưu ở FP16 chiếm byte, khoảng 0,383 MiB. Mỗi vị trí đầu ra dùng 64 kênh từ chín vị trí lân cận, nên ma trận trải phẳng có kích thước , chiếm khoảng 3,445 MiB — gấp chín lần đầu vào ban đầu.
Nếu ma trận trải phẳng được tạo trước trong HBM rồi mới đưa vào phép nhân ma trận, sẽ phát sinh thêm một lần ghi 3,445 MiB và một lần đọc, tổng cộng 6,891 MiB. Băng thông HBM của 910 đời đầu là 1,2 TB/s, nên riêng việc ghi và đọc ma trận trải phẳng này đã tiêu tốn khoảng 6,02 μs thời gian băng thông. MTE hoàn tất việc trải phẳng cửa sổ ngay trong lúc di chuyển trên chip, tiết kiệm lượt ghi và đọc bản sao trung gian trong HBM. Khi cửa sổ đầu vào được tổ chức trên chip, nó được đưa thẳng vào phép tính ma trận, và HBM chỉ còn giữ đầu vào và trọng lượng gốc.
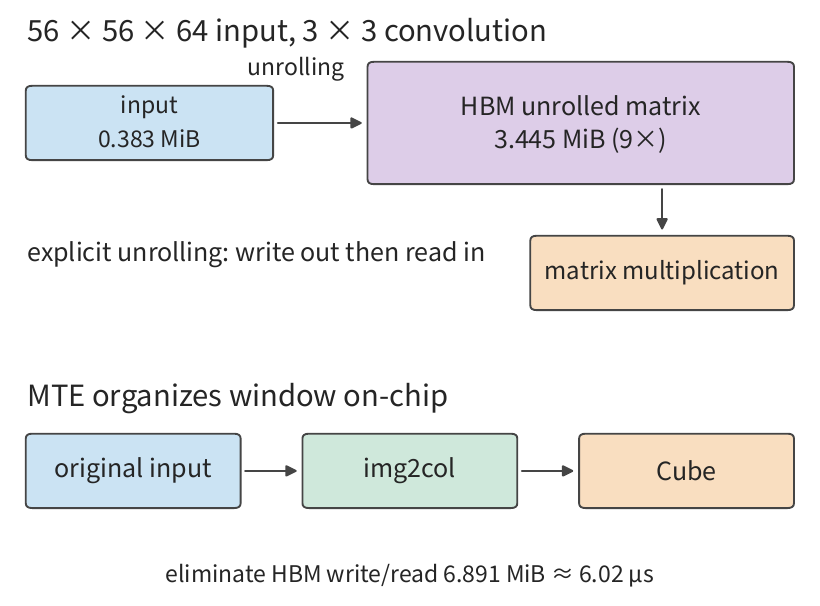
Giờ xét sự phân công tính toán. Tích chập này cần MFLOP. Cube Ascend-Max trong bài báo DaVinci đạt 8.192 FLOP mỗi chu kỳ, nên thời gian phục vụ ma trận là 28.224 chu kỳ. ReLU đầu ra chỉ xử lý 200.704 phần tử; ở độ rộng vector 256 byte, một nhóm giữ 128 phần tử FP16, cho 1.568 nhóm. Tính toán ma trận và hậu xử lý của tích chập chênh lệch rất lớn về quy mô, nên Cube, Vector và phần cứng trải phẳng mỗi bộ phận đảm nhiệm một phần công việc được phân định rõ.
Chuyển sang attention dịch chuyển cả tỷ lệ tài nguyên lẫn hướng dữ liệu. Với một khối attention có chiều head 128, QK và PV cùng cần khoảng 8,39 MFLOP, ở cùng tốc độ Cube trên thì mất 1.024 chu kỳ. Softmax cần tính 16.384 hàm mũ và thực hiện khử max, cộng dồn và chuẩn hóa. Ở độ rộng vector 256 byte, một nhóm dữ liệu FP32 giữ 64 giá trị, nên riêng bước hàm mũ đã cần 256 nhóm. Để giai đoạn hàm mũ nằm gọn trong 1.024 chu kỳ của ma trận, phần hàm mũ phải xử lý trung bình một nhóm mỗi bốn chu kỳ — tức 16 kết quả hàm mũ mỗi chu kỳ. Khử và chuẩn hóa tiếp theo, tạo ra đầu vào cho PV.
Trên cùng một Cube, công việc ma trận của tích chập CNN mất 28.224 chu kỳ, còn khối attention chỉ mất 1.024 chu kỳ; trong khi đó công việc vector chuyển từ ReLU đơn giản sang hàm mũ, khử và chuẩn hóa. Trong phân tích BERT của bài báo DaVinci, hầu hết các layer bị chi phối bởi thời gian Cube. Khi tách attention ra, những đòi hỏi mới mà Softmax đặt lên thông lượng vector trở nên hiện hữu.
Việc trải phẳng cửa sổ tích chập vốn quan trọng với CNN chẳng còn gì để làm với các phép chiếu Q, K, V, vì đầu vào của phép chiếu vốn đã là ma trận. Attention thay vào đó cần bàn giao kết quả QK cho Vector để làm Softmax, rồi trả xác suất lại cho Cube để làm PV. Công việc img2col tiết kiệm trong trải phẳng tích chập khác với công việc mà hai lượt bàn giao ma trận–vector này yêu cầu; khi tải công việc dịch chuyển, trọng tâm của các tài nguyên phần cứng mới bổ sung cũng dịch chuyển theo.
Sau khi lập lịch tách riêng, đường bàn giao ảnh hưởng đến tốc độ thế nào? Atlas A2, nơi chứa 910B, tách nhân ma trận AIC khỏi nhân vector AIV dưới điều khiển độc lập; 910C tiến xa hơn với thiết kế hai die, mỗi die có 24 AIC và 48 AIV. Điều khiển tách riêng cho phép các công việc khác nhau tiến hành độc lập, trong khi AIC và AIV trao đổi kết quả qua một không gian địa chỉ toàn cục, với dữ liệu thực tế đi qua hệ thống phân cấp cache. CloudMatrix384 nén trạng thái KV trong MLA, sắp xếp công việc ma trận và vector thông qua hợp nhất (fusion) và tiling động; MTP xử lý nhiều vị trí dự đoán cùng lúc, làm thay đổi thêm số hàng của các phép tính này.
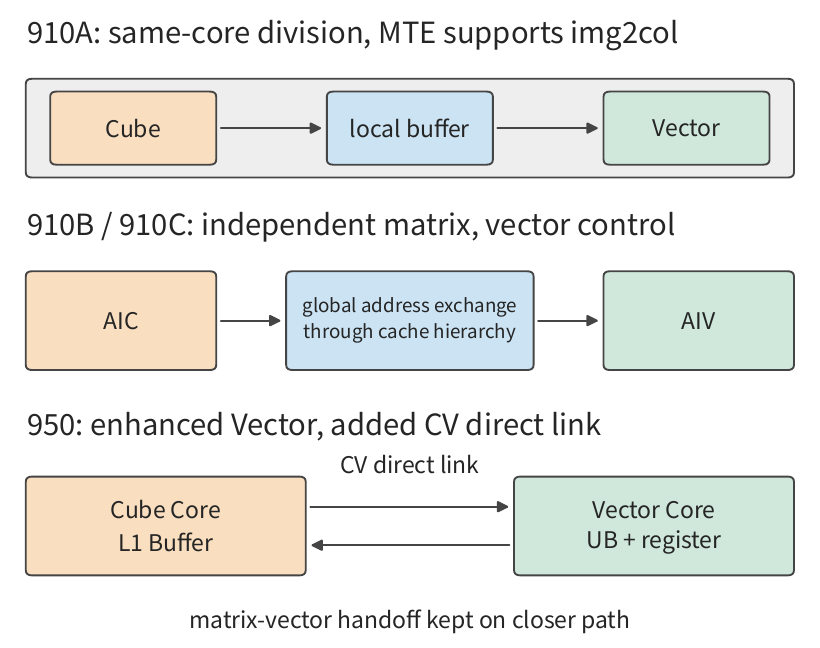
Hãy định lượng tải giao diện bằng cùng một khối attention. Điểm số và xác suất mỗi tensor được bàn giao ở FP32, chiếm 64 KiB. Một lượt bàn giao, ghi ra rồi đọc lại qua giao diện chuyển mạch ngoài, tổng cộng 128 KiB; hai lượt bàn giao QK→Softmax và Softmax→PV cùng tổng cộng 256 KiB. Nếu cả hai lượt bàn giao cùng đi qua một giao diện ngoài, hoàn thành chúng trong 1,024 μs đòi hỏi giao diện đó đạt khoảng 256 GB/s. Thay vào băng thông 94 GB/s của cache cuối cùng (LLC) mỗi nhân cho trong bài báo DaVinci, công việc này sẽ mất khoảng 2,79 μs — đã vượt thời gian phục vụ ma trận 1,024 μs của Cube ở 1 GHz. Kể cả nếu tính toán ma trận ngày càng nhanh, giao diện ngoài vẫn phải di chuyển những byte này.
Thay đổi kế tiếp trong Ascend 950 nhắm đúng giao diện ngoài này: máy thêm một đường CV (Cube–Vector) trực tiếp giữa buffer L1 của Cube và Unified Buffer của Vector (viết tắt UB trong tài liệu Ascend, không phải khái niệm interconnect Unified Bus trong Chương 6). Hai tensor trung gian 64 KiB được bàn giao qua kết nối trực tiếp này, chuyển tổng cộng 128 KiB, loại bỏ 256 KiB ghi/đọc mà trước đây đi qua giao diện ngoài. Hoàn thành cả hai lượt bàn giao trong 1,024 μs qua đường trực tiếp này đòi hỏi khoảng 128 GB/s; nếu định dạng bàn giao chuyển sang FP16/BF16, yêu cầu lại giảm nửa còn khoảng 64 GB/s.
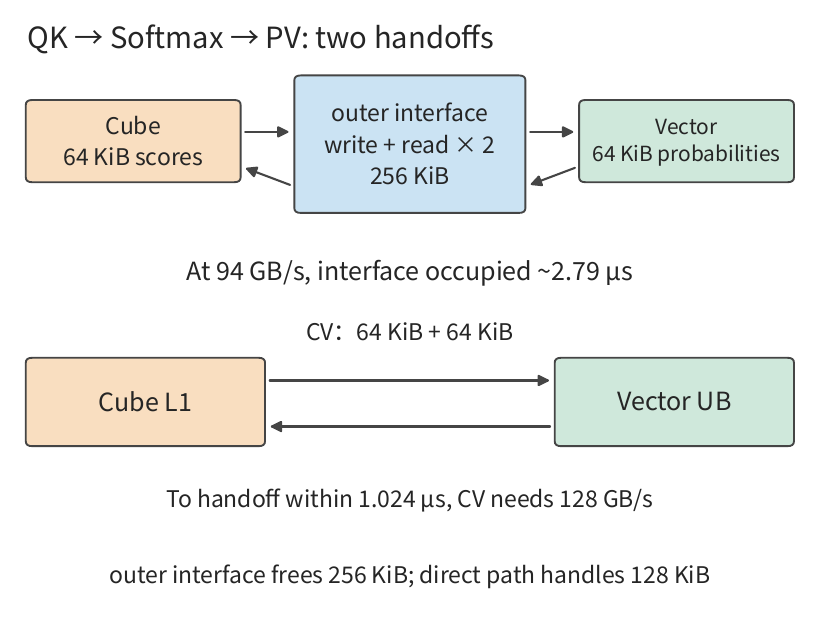
950 cũng nhân đôi thông lượng FP16/FP32 của một Vector Core, thêm một file thanh ghi giữa Unified Buffer và đơn vị số học logic vector (ALU), và tối ưu thực thi của Softmax và hàm kích hoạt GELU. Với cùng lượng công việc vector thông thường , giảm xuống ; nếu giai đoạn vector vốn gấp đôi giai đoạn ma trận, thay đổi này có thể tái cân bằng hai giai đoạn. Với khối attention ở trên, thông lượng hàm mũ cần đạt 16 kết quả mỗi chu kỳ. NDDMA mới được thêm xử lý định địa chỉ đa chiều và chuẩn bị bố cục, còn BufferID tổ chức các lượt bàn giao đồng bộ bằng định danh buffer.
Độ chính xác thấp của 950 cũng có thể hiểu qua cùng lăng kính tải công việc: ở cùng tần số, tính toán ma trận hạng FP8 chạy nhanh gấp đôi FP16, và MXFP4 nhanh gấp bốn. Với một ma trận cố định , thời gian phục vụ tính toán lần lượt là , , ; nhưng hai lượt bàn giao điểm số và xác suất FP32 vẫn cùng kích thước như trước. Chỉ khi đường bàn giao, định dạng hoặc bố cục thay đổi cùng lúc, tải giao diện mới thực sự giảm. Ma trận, vector và đường CV phải tiến hóa cùng nhau để biến gia tốc cục bộ thành lợi ích cho toàn bộ khối attention.
4.6.3 Apple: bộ nhớ hợp nhất lớn chuyển hóa thành năng lực thực thi mô hình thế nào
CPU, GPU và Neural Engine độc lập của Apple chia sẻ bộ nhớ hợp nhất. Bộ nhớ hợp nhất loại bỏ việc sao chép dữ liệu giữa các bộ xử lý, đồng thời cho phép các mô hình chạy cục bộ dùng một vùng nhớ lớn hơn. Dưới đây, trước tiên ta tính kích thước mô hình mà bộ nhớ hợp nhất có thể chứa, rồi tính lượng dữ liệu phải đọc để sinh ra một token.
Trước hết, kiểm tra mối quan hệ giữa các thế hệ về dung lượng và băng thông. Cấu hình đại diện M1 Ultra là 128 GB ở 800 GB/s; M2 Ultra mở rộng lên 192 GB ở 800 GB/s; cấu hình GPU 80 lõi của M3 Ultra có 256 GB và bản 512 GB được tài liệu chính thức ghi nhận, cả hai ở 819 GB/s. M4 Max cũng có cấu hình 128 GB, ở băng thông 546 GB/s.
Khi dung lượng tăng gấp đôi, những thời điểm nào thay đổi? Trước tiên giữ cố định mô hình, độ chính xác và kích thước batch. Từ 256 GB của M3 Ultra lên 512 GB, băng thông vẫn là 819 GB/s, nên cho cùng một lần thực thi hoàn toàn giống nhau. Từ M1 Ultra lên M3 Ultra, băng thông tăng từ 800 lên 819 GB/s, tăng tốc độ đọc chỉ khoảng 2,4%. Dung lượng tăng cho phép nhiều trọng lượng, KV hoặc yêu cầu cư trú trong bộ nhớ hơn, còn băng thông tăng trực tiếp làm thay đổi thời gian đọc cho cùng một batch dữ liệu.
Lấy Qwen3-8B, BF16, một yêu cầu, 8.192 vị trí; kiểm kê tensor của cuốn sách này cho tải giao diện khoảng 16,345 GB mỗi bước cho trọng lượng và KV. Cận dưới đọc cho M1/M2 Ultra là ms, cho M3 Ultra là ms, và cho M4 Max là ms. Dù cả hai đều có 128 GB, M1 Ultra đọc dữ liệu bước này nhanh hơn M4 Max khoảng 9,51 ms.
Giá trị chính của dung lượng dễ thấy hơn với một MoE lớn. Qwen3-235B-A22B, dùng sơ đồ lưu trữ 4-bit của cuốn sách này cùng các hệ số tỷ lệ và tensor giữ ở độ chính xác cao hơn, có khoảng 123,142 GB trọng lượng cư trú. Với một yêu cầu có ngữ cảnh 8K, cộng KV và một workspace 2 GiB, tổng cộng khoảng 126,867 GB. Máy 128 GB chỉ còn trống khoảng 1,13 GB; dành thêm 8 GB cho hệ điều hành và các ứng dụng khác nghĩa là cần khoảng 134,87 GB. Các cấu hình 256 GB hay 512 GB có đủ chỗ cho ngân sách này.
MoE chỉ truy cập các expert được chọn mỗi bước. Với cùng một yêu cầu, tải giao diện trọng lượng-và-KV mỗi bước khoảng 13,697 GB, cần khoảng 16,72 ms trên M3 Ultra — thay vì khoảng 150 ms nếu đọc toàn bộ 123,142 GB trọng lượng mỗi bước. Với MoE, tổng trọng lượng quyết định dung lượng, còn các expert hiện được chọn quyết định lượng trọng lượng đọc mỗi bước. Một MoE lớn do đó có thể đồng thời thể hiện “cần bộ nhớ lớn” và “mỗi bước đọc tương đối ít”.
Giờ thay các kết quả định tuyến tám yêu cầu từ Mục 4.3.3. Lượng đọc mỗi bước của định tuyến tập trung so với phân tán lần lượt là 24,737 GB và 75,967 GB, tương ứng 30,20 ms và 92,76 ms trên M3 Ultra. Mỗi bước sinh ra tám token, cho ngân sách thông lượng đọc token/s và token/s. Các cấu hình 256 GB và 512 GB đều đáp ứng được cùng tác vụ tám yêu cầu; tái sử dụng định tuyến quyết định khác biệt giữa hai ngân sách đọc này.
Bộ nhớ cục bộ và các đơn vị chuyên dụng của GPU đi vào tập tính toán này thế nào? M3 giới thiệu Dynamic Caching, cấp phát bộ nhớ cục bộ của GPU theo nhu cầu runtime; M4 tiếp tục cách tổ chức này. Các cơ chế này ảnh hưởng đến sự cư trú của công việc và mức sử dụng tài nguyên trên chip, trong khi dung lượng mô hình được quyết định bởi bộ nhớ hợp nhất. M5 bổ sung thêm Neural Accelerator bên trong mỗi lõi GPU, được truy cập qua các giao diện như Metal 4 Tensor API; Neural Engine độc lập vẫn tiếp tục tồn tại. Các đơn vị chuyên dụng bên trong GPU tăng tốc xử lý ma trận, còn chuẩn bị dữ liệu và tính toán thông dụng tiếp tục được tổ chức bởi các chương trình GPU.
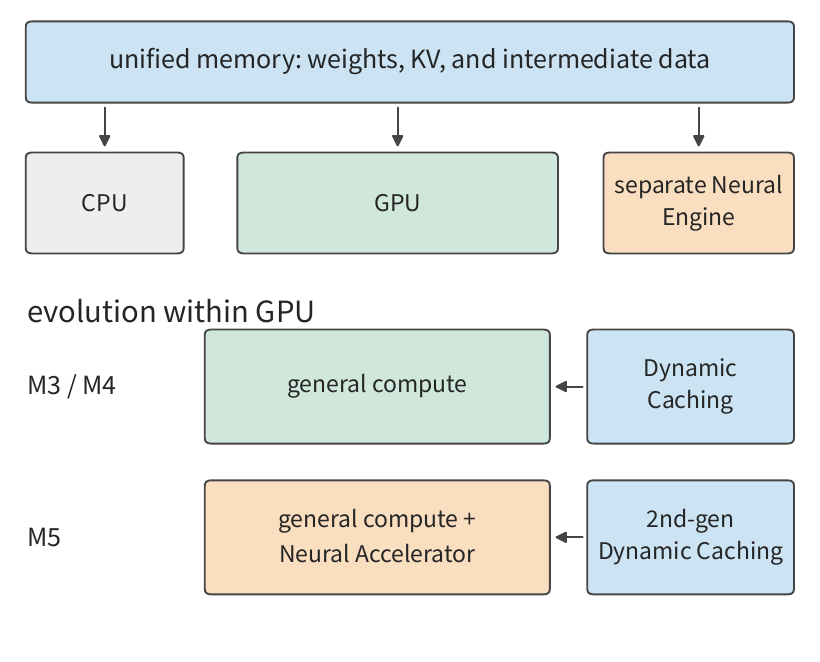
Băng thông bộ nhớ cũng tăng qua từng thế hệ: từ M4 cơ bản lên M5 cơ bản, băng thông bộ nhớ hợp nhất tăng từ 120 lên 153 GB/s, tăng khoảng 27,5%. Thời gian đọc 32 MiB trọng lượng ở phần trước giảm từ khoảng 279,6 μs xuống 219,3 μs, giảm khoảng 21,6%. Apple công bố đỉnh AI GPU của M5 vượt hơn bốn lần M4; lượng trọng lượng đọc cho cùng một phép chiếu một hàng vẫn được quyết định bởi băng thông ở trên. Khi số hàng đầu vào tăng, việc đọc trọng lượng được san đều ra nhiều phép tính hơn, và đơn vị ma trận mới trở thành nguồn lợi ích dễ tiếp cận hơn. Hiện tượng này tương ứng chính xác với kết quả V100 cho hai số hàng đã thảo luận trước đó.
Những phát triển này biến mối quan hệ phản hồi trong Hình 4-3 thành các thay đổi tài nguyên cụ thể: ma trận lớn thúc đẩy các đơn vị nhân-cộng chuyên dụng, Transformer làm tăng yêu cầu vector và bàn giao, và MoE lớn mở rộng yêu cầu dung lượng cư trú.
4.7 Kiến trúc chuyên biệt
Các mục trước cải thiện hiệu suất của accelerator đa năng nhờ tái sử dụng, pipeline và tính cục bộ. Nếu một số điều kiện của tải công việc ổn định lâu dài, những điều kiện đó có thể được xây thẳng vào thiết kế phần cứng: quy tắc tính toán cố định, thứ tự giao tiếp cố định, thậm chí trọng lượng cố định. Chuyên biệt hóa giảm bớt một số công việc, và dồn nhiều tài nguyên hơn vào phần còn lại.
4.7.1 TPU
Tính toán suy luận của TPU v1 xoay quanh phép nhân ma trận đều đặn. Một mảng đơn vị nhân-cộng tạo thành lõi; trọng lượng được nạp vào mảng qua một hàng đợi vào-trước-ra-trước trên chip (FIFO, một buffer lấy các mục theo thứ tự đến), đầu vào được đưa từ Unified Buffer, kết quả được giữ trong bộ lưu trữ tích lũy chuyên dụng, rồi chuyển đến đơn vị kích hoạt. Một lệnh đơn có thể mô tả một phép toán ma trận quy mô lớn, và các kết nối cục bộ truyền toán hạng lặp đi lặp lại, giảm bớt việc điều khiển và truy cập đường dài cần thiết cho mỗi phép nhân-cộng.
Một khối trọng lượng 8-bit chiếm 64 KiB. Chỉ xử lý một hàng đầu vào thực hiện phép toán, tức hai phép toán mỗi byte trọng lượng; xử lý 256 hàng thực hiện khoảng 33,6 M phép toán, tức 512 phép toán mỗi byte trọng lượng. Trọng lượng giữ cố định trong khi lượng tính toán tăng lên 256 lần mức ban đầu — chính xác là mối quan hệ tái sử dụng phép chiếu trong Mục 4.1, được hiện thực trong mảng.
Để chụp lấy lợi ích này, mảng cần các hàng đầu vào liên tục. FIFO trọng lượng có thể giữ bốn khối trọng lượng như vậy, nên việc nạp trọng lượng và tính toán có thể được kết nối qua đệm; khi đầu vào liên tục chảy vào mảng, bộ lưu trữ tích lũy độc lập giữ các tổng riêng phần. Mảng lớn, buffer đầu vào và hàng đợi trọng lượng từ đó làm việc cùng nhau: mảng cung cấp các đơn vị nhân-cộng, còn các buffer đảm bảo các đơn vị này liên tục nhận được toán hạng cần thiết.
Khi mảng khởi động, các toán hạng vẫn cần lan truyền dọc các kết nối đến từng vị trí tính toán; khi kết thúc, kết quả cần được gom lại để xuất ra. Càng tính liên tiếp nhiều khối, thời gian lấp đầy và xả pipeline được san đều trên mỗi khối càng nhỏ, nên các tác vụ nhỏ chịu ảnh hưởng nhiều hơn từ những bước cố định này.
Khi tải công việc thay đổi, tỷ lệ giữa các bộ phận khác nhau của phần cứng cũng cần điều chỉnh. Huấn luyện thêm trạng thái ghi được, gradient và trao đổi giữa các accelerator; sinh ngữ cảnh dài làm tăng mức chiếm KV và đòi hỏi mỗi bước sinh phải chờ kết quả của bước trước. TPU 8t/8i của Google tổ chức dịch vụ huấn luyện và lấy mẫu riêng, phản ánh cách các giai đoạn khác nhau đòi hỏi lượng tài nguyên ma trận, vector, lưu trữ và interconnect khác nhau. Cách tiếp cận chung của TPU là bố trí tài nguyên quanh công việc đã biết, với tỷ lệ cụ thể dịch chuyển khi tải công việc chính thay đổi.
4.7.2 Groq, Graphcore và Cerebras
Giữ nhiều dữ liệu hơn trên chip làm giảm truy cập đường dài. Theo ý tưởng này, tính toán và lưu trữ có thể được phân tán trên nhiều đơn vị cục bộ, hoặc bản thân chip có thể được làm lớn hơn để chứa nhiều đơn vị như vậy hơn. Cả hai cách đều cho phép lượng dữ liệu lớn được các đơn vị tính toán gần kề sử dụng, và cả hai đều cần sắp xếp việc trao đổi giữa các đơn vị.
Tensor Streaming Processor (TSP) của Groq có thời điểm sinh, truyền và dùng tensor được compiler xếp đặt trước. Intelligence Processing Unit (IPU) của Graphcore gồm nhiều đơn vị tính toán với bộ nhớ cục bộ (Graphcore gọi là tile), trong đó mỗi đơn vị cộng tác trên các tác vụ thông qua tính toán, đồng bộ và trao đổi dữ liệu. Cerebras trải lượng lớn tính toán và lưu trữ trên một chip quy mô wafer; Wafer-Scale Engine thế hệ ba, WSE-3, có 44 GB SRAM trên chip. SRAM rất phù hợp để tích hợp trực tiếp bên trong chip tính toán, đánh đổi diện tích lấy truy cập độ trễ thấp. Những thiết kế này đạt tính cục bộ ở các quy mô khác nhau: rút ngắn đường truyền thông càng nhiều càng tốt, giữ dữ liệu dùng lặp lại gần với phép tính.
Khó khăn với dung lượng phân tán là nhu cầu biến thiên giữa các nơi. Khi một đơn vị giải phóng chỗ lưu trữ, các đơn vị khác không thể trực tiếp coi chỗ đó là bộ nhớ cục bộ của mình; tái cân bằng đòi hỏi di trú dữ liệu hoặc di chuyển tính toán. Các mô hình mixture-of-experts với định tuyến không đều đặc biệt dễ gặp điều này: tổng khối lượng giữ nguyên, nhưng yêu cầu dồn vào vài expert khiến vài đơn vị tính toán bận hơn.
Mất cân bằng lưu trữ cục bộ có thể được giảm nhẹ bằng cách phân bổ lại tác vụ, nhưng một vấn đề khác tồi tệ hơn khi quy mô dịch vụ tăng: tổng khối lượng KV tăng. Tiếp tục với Qwen3-8B, một yêu cầu 8.192 token có KV BF16 là 1,125 GiB. TSP của Groq có 220 MiB SRAM mỗi chip, và riêng việc lưu trọng lượng BF16 đã cần 72 chip. Nếu KV được lưu trên các chip riêng và chia đều được, một yêu cầu cần chip; tám yêu cầu tổng cộng 9 GiB, cần 42 chip; nếu ngữ cảnh của cả tám yêu cầu tăng lên 32.768 token, cần 168 chip.
Đi từ 6 lên 42 rồi lên 168, thứ tăng lên là trạng thái ghi được — trọng lượng của mô hình không tăng. Lưu trọng lượng trên chip loại bỏ một loại đọc, nhưng dịch vụ liên tục vẫn cần dung lượng cho trạng thái đang phát triển. Khi số chip tăng, KV phân tán trên các chip đó cũng phải được gom lại xuyên các chip; mở rộng dung lượng và nhu cầu giao tiếp phát sinh từ cùng một tải công việc tại cùng một thời điểm.
Tích hợp quy mô wafer rút ngắn một số kết nối mà lẽ ra phải vượt qua package, nhưng dữ liệu vẫn đi qua mạng xuyên nhiều đơn vị tính toán. Đặt tính toán dùng cùng một trạng thái gần nhau giúp giảm các liên kết và đồng bộ phải vượt qua; phân tán tác vụ đều có lợi cho việc dùng nhiều vị trí tính toán hơn. Phân bổ tác vụ tính toán phải vừa cho phép dữ liệu được tái sử dụng cục bộ, vừa tránh việc vài đơn vị quá tải trong khi phần còn lại ngồi không — nguyên tắc tương tự như bố trí nhiều die.
4.7.3 Dataflow cố định và trọng lượng cố định
Chuyên biệt hóa phân bổ lại tài nguyên phần cứng bằng cách khai thác các điều kiện đã cố định tại thời điểm thực thi. Cố định loại toán tử đơn giản hóa lệnh và điều khiển; cố định dataflow cho phép giao tiếp được sắp xếp trước; cố định định dạng số cho phép các đơn vị lưu trữ và tính toán được thiết kế đúng độ rộng bit yêu cầu; cố định trọng lượng cho phép thiết kế một cấu trúc lưu trữ chuyên dụng cho các tham số không còn thay đổi. Các đường điều khiển và dữ liệu vốn được thiết kế để xử lý nhiều trường hợp có thể được đơn giản hóa tương ứng.
Khi mô hình thay đổi, các thiết kế cấu hình lại thích nghi với phép tính mới bằng cách cập nhật kết nối và lịch biểu. Tổ chức dataflow của SambaNova và các đường cấu hình lại của FPGA đều cho phép cấu hình lại một số kết nối và thứ tự thực thi; ngược lại, các thiết kế trọng lượng cố định tổ chức lưu trữ và tính toán quanh các tham số cụ thể.
Trọng lượng cố định không có nghĩa thiết kế chỉ làm được một tác vụ. Thay đổi đầu vào cho phép cùng một mô hình thực hiện các tác vụ cấp cao khác nhau. Cùng một bộ trọng lượng mô hình có thể xử lý hỏi đáp tài liệu, hoặc đề xuất sửa đổi mã dựa trên mã và kết quả kiểm thử; mỗi lần gọi dùng trạng thái ngữ cảnh riêng của nó. Phần cứng do đó có thể được thiết kế với các đường trọng lượng chuyên dụng cho việc thực thi mô hình dùng chung, trong khi bộ nhớ ghi được giữ ngữ cảnh của từng yêu cầu riêng. Dưới đây, trọng lượng và ngữ cảnh được đo riêng, để tính xem sự phân công lao động này giải phóng được bao nhiêu dung lượng và băng thông.
Dự án OpenTallas của tác giả nghiên cứu một kiến trúc đặt các trọng lượng bất biến trong một mask ROM; mask ROM là bộ nhớ chỉ đọc có nội dung được cố định lúc sản xuất. Dùng Qwen3-8B từ dự án đó làm ví dụ, các công thức sau ước lượng cách thiết kế “đọc trọng lượng từ ROM chuyên dụng, đọc và ghi KV từ HBM” thay đổi khối lượng truyền trên mỗi giao diện. Mỗi batch chỉ đọc lượng trọng lượng cần cho phép tính của bước hiện tại, khoảng GB; mỗi yêu cầu đọc toàn bộ KV cho 8.192 token, khoảng GB. Tổng trọng lượng cư trú khoảng 16,4 GB, trong đó mỗi bước chỉ đọc phần tham gia vào phép tính của bước đó.
Đầu tiên, xét lượng đọc mà cùng một giao diện ban đầu phải xử lý. Khi trọng lượng và KV dùng chung HBM, lượng đọc mỗi bước là . Sau khi chuyển trọng lượng sang ROM chuyên dụng, HBM chỉ xử lý . Tỷ lệ giữa hai lượng đọc HBM này là
Ở , lượng đọc HBM giảm từ khoảng 16,3 GB xuống 1,21 GB, và thời gian đọc giảm còn khoảng mức ban đầu. Ở , KV đã khoảng 19,3 GB, và tổng giảm từ khoảng 34,5 GB xuống 19,3 GB, khoảng mức ban đầu. Khi kích thước batch tăng, lượng đọc trọng lượng vốn đã được san đều trên nhiều yêu cầu, nên lợi ích tương đối của việc triệt để loại bỏ đọc trọng lượng giảm đi.
Đặt cho điểm giao nhau nơi lượng đọc KV bằng lượng đọc trọng lượng, tại ; tính từ kích thước batch nguyên 13, lượng đọc KV vượt lượng đọc trọng lượng. Hình 4-33 thể hiện sự chuyển tiếp này bằng một đường ngang và một đường chéo.
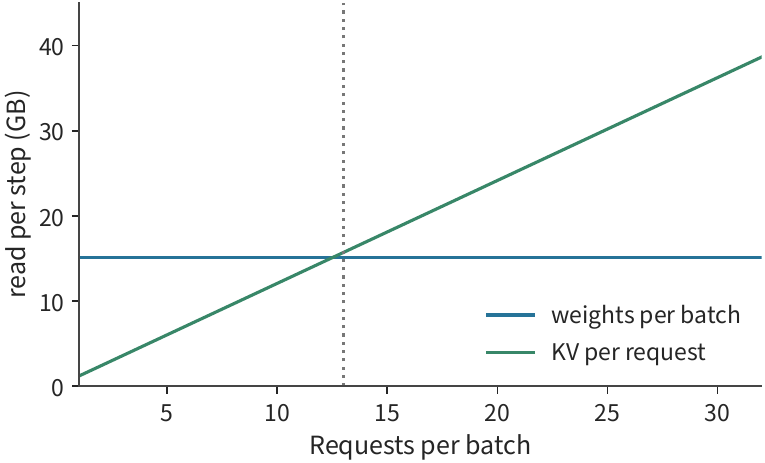
Với giao diện ROM chuyên dụng, trọng lượng và KV có thể được đọc đồng thời. Gọi băng thông của hai giao diện lần lượt là và ; giữ cố định mô hình, độ chính xác, ngữ cảnh và kích thước batch, cận dưới của thời gian lưu trữ khi hai đường trùng nhau là
Nâng băng thông ROM làm rút ngắn số hạng thứ nhất, cho đến khi đọc KV trở thành đường chậm hơn. Nếu mục tiêu là 10.000 token/s cho một người dùng, mỗi token chỉ có 100 μs, và riêng 1,21 GB KV đã cần khoảng 12,1 TB/s băng thông HBM.
Một ROM chuyên dụng cũng giải phóng dung lượng HBM vốn đang giữ trọng lượng. Với ngữ cảnh 8K cố định, dùng một chồng HBM3E 24 GB tám lớp (Mục 4.1.3) làm lưu trữ KV, sau khi trừ workspace 2 GiB, và với 1,125 GiB KV mỗi yêu cầu, nó có thể chứa 18 yêu cầu; thiết kế ban đầu, vốn cũng cần lưu toàn bộ trọng lượng BF16, chỉ chứa được 4 yêu cầu. Khi ngữ cảnh tăng lên 32K, lượng đọc KV mỗi yêu cầu tăng gấp bốn, và điểm giao trọng lượng/KV trước đó giảm từ khoảng 12,5 yêu cầu xuống khoảng 3,13 yêu cầu.
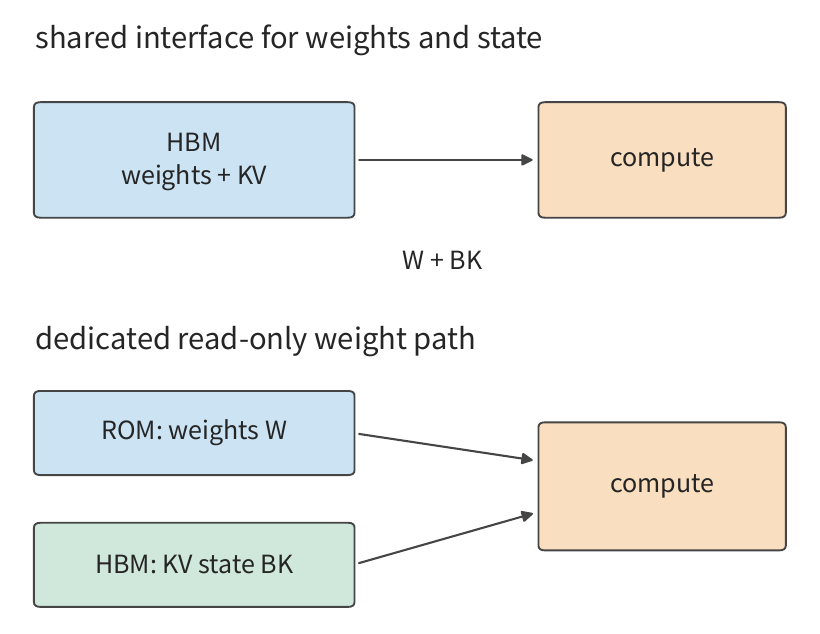
Cùng hạn 100 μs cũng có thể dùng để xác định số đơn vị tính toán cần thiết. Tải công việc được lấy từ bản ghi thực thi lịch sử của dự án: một tập phép toán tensor tổng cộng 15.134.641.792 phép toán. Giả sử mỗi lane tính toán hoàn tất một phép nhân-cộng hợp nhất (FMA) mỗi chu kỳ ở 1 GHz, số lane tối thiểu cần trong 100 μs là
256 lane sẽ cần khoảng 29,6 ms để hoàn tất các phép toán này. Nếu chỉ dành 40 μs cho tính toán ma trận, và mức sử dụng hiệu quả là 60%, thì cần 315.306 lane — khoảng 4,2 lần số lane tính ban đầu. Ngân sách thời gian càng chặt, biên độ còn lại cho việc chờ đợi càng nhỏ, và công suất tính toán cũng như băng thông lưu trữ phải được trang bị càng cao.
4.8 Phân tích hiệu suất theo kiến trúc và lựa chọn accelerator
Các Mục 4.6 và 4.7 đã tính cách các kiến trúc khác nhau làm thay đổi công việc tính toán, lưu trữ và trao đổi. Mục này áp dụng các kết quả đó vào việc chọn thiết bị: trước tiên tổng hợp một mô hình thời gian thực thi, rồi dùng chính mô hình đó để so sánh các thiết bị ứng viên, sau đó hiệu chuẩn bằng đo lường, và cuối cùng so sánh chi phí và năng lượng của việc hoàn thành tác vụ.
Khi chọn phần cứng, bạn cũng cần giữ lại một mô tả tài nguyên dùng được cho các công đoạn phân rã và lập lịch phía sau: tính toán hiệu dụng ở độ chính xác và hình dạng ma trận mục tiêu, dung lượng và băng thông ở từng tầng lưu trữ, giới hạn thanh ghi và shared memory, cùng băng thông một chiều, độ trễ khởi động và egress dùng chung giữa các thiết bị. Chương 5 dùng các ràng buộc tài nguyên cục bộ trong số đó — tile (các khối dữ liệu cắt từ ma trận), buffer và mức độ song song — còn Chương 6 và 7 dùng các tham số interconnect để ràng buộc việc bố trí xuyên card và các nhóm giao tiếp. Yêu cầu tính toán và dữ liệu của cùng một mô hình không thay đổi, nhưng yêu cầu đó rơi vào tầng tài nguyên nào, và đi theo đường nào, lại làm thay đổi thời gian thực thi và cách phân rã tối ưu nhất.
4.8.1 Xây dựng mô hình thời gian thực thi từ ngân sách tài nguyên
Thời gian thực thi đến từ hai mối quan hệ: những phép toán nào cùng một đơn vị phần cứng phải thực thi tuần tự, và kết quả nào mà một phần việc phía sau phải chờ. Mối quan hệ trước quyết định mỗi đơn vị cần làm việc bao lâu; mối quan hệ sau quyết định thứ tự thực thi các bước.
Bắt đầu với các tài nguyên dùng chung. Nếu cùng một đơn vị ma trận xử lý hai loại công việc, mỗi loại 1 G phép toán, ở tốc độ lần lượt 100 và 200 Gops/s, chúng chiếm lần lượt 10 ms và 5 ms, tổng cộng 15 ms. Nếu tải công việc loại thứ trên tài nguyên là , với tốc độ tương ứng , thì thời gian đơn vị phần cứng này cần để hoàn tất các phép toán đó là
Khi trọng lượng và KV dùng chung một giao diện bộ nhớ, lưu lượng của chúng cộng dồn lại; khi QK và PV dùng chung một đơn vị ma trận, thời gian tính toán của chúng cộng dồn lại. Công việc này tiêu thụ cùng một lát cắt năng lực phần cứng kể cả khi được trải trên các toán tử khác nhau.
Giờ xét các tài nguyên độc lập. Khi đơn vị ma trận và việc di chuyển dữ liệu có thể tiến hành đồng thời, tổng thời gian thực thi ít nhất bằng thời gian cần cho đơn vị chậm nhất hoàn tất toàn bộ phép toán của nó, nên . Phân tích trạng thái ổn định của Mục 4.2 đã dùng chính mối quan hệ này: khi tính toán hàm mũ không nhanh lên, đơn vị ma trận hoàn thành sớm và ngồi không, và nhịp hoàn thành của mỗi khối vẫn bị chi phối bởi hàm mũ.
Cuối cùng, thêm sự phụ thuộc. Giả sử giai đoạn một cần 10 μs công việc ma trận và 1 μs công việc bộ nhớ, còn giai đoạn hai cần 1 μs công việc ma trận và 10 μs công việc bộ nhớ; trong mỗi giai đoạn công việc có thể trùng nhau, nhưng giai đoạn hai phải chờ giai đoạn một hoàn tất trọn vẹn. Giai đoạn một do đó mất 10 μs, và giai đoạn hai cũng mất 10 μs, tổng cộng 20 μs. Chỉ đơn thuần cộng tổng mức dùng tài nguyên sẽ cho ma trận và bộ nhớ mỗi bên 11 μs; 9 μs thêm đến từ phụ thuộc giai đoạn: tính toán ma trận của giai đoạn một và truy cập bộ nhớ của giai đoạn hai phải xảy ra tuần tự và không thể trùng nhau.
Để áp dụng các mối quan hệ này vào một thiết bị cụ thể, trước tiên bạn cần chọn đúng tốc độ: tốc độ phép toán của đơn vị ma trận còn phụ thuộc vào độ chính xác đầu vào và tích lũy. Với Tensor Core của RTX 4090 thực thi phép toán ma trận đặc, đỉnh với đầu vào FP16 và tích lũy FP16 khoảng 330 TFLOP/s, và khoảng 165 TFLOP/s với tích lũy FP32; các phép chiếu BF16/FP32 của chương này dùng 165,2 TFLOP/s. Với 8,59 GFLOP, ở hai tốc độ này, thời gian cần thiết tương ứng khoảng 26 và 52 μs. Thời gian đọc tính dưới đây khoảng 37 μs, nên việc chọn tốc độ trực tiếp thay đổi độ lớn tương đối giữa thời gian tính toán và thời gian đọc.
Khi thời gian tài nguyên và các phụ thuộc thực thi đã được xác lập, bạn cũng có thể tìm điểm chuyển nút thắt khi tải thay đổi. Với phép chiếu Q của chương này, mô hình Roofline diễn tả sự chuyển này như một mối quan hệ giữa cường độ số học và thông lượng.
Gọi là đỉnh ma trận, băng thông ngoài chip, còn và lần lượt là tải công việc và khối lượng truy cập của phép chiếu. Thời gian cần cho tính toán và truyền dữ liệu lần lượt là và . Khi tính toán và truy cập trùng nhau hoàn toàn, giá trị lớn hơn trong hai giá trị quyết định cận dưới thời gian, cho cận trên thông lượng của mô hình Roofline là
Ở đây đường chéo mô tả băng thông có thể nuôi được bao nhiêu phép toán, còn đường ngang mô tả đơn vị ma trận có thể hoàn tất bao nhiêu phép toán. Hai đường cắt nhau tại . Dưới điểm cắt, việc cấp dữ liệu là yếu tố chậm hơn; trên điểm cắt, mỗi byte đã tương ứng với đủ số phép toán để tốc độ tính toán trở thành nút thắt mới. Đường gãy khúc này là trần cho phép của phần cứng — mọi điểm đo được đều nằm dưới nó — và khoảng cách giữa thông lượng đo được và đường này chính là mức sử dụng được định nghĩa trong Mục 1.2.2. Khi cường độ số học nằm trên điểm cắt, nó được đo bằng MFU; khi nằm dưới, bằng MBU.
Tiếp tục với phép chiếu của Mục 4.1 — đọc đầu vào và trọng lượng một lần, ghi đầu ra một lần — đỉnh phép toán ma trận của RTX 4090 với đầu vào BF16 và tích lũy FP32 là 165,2 TFLOP/s, với băng thông 1,008 TB/s. Thay cùng và cho:
| Số token xử lý trong lượt này | Thời gian tính toán ma trận | Thời gian truyền dữ liệu ngoài chip | Giá trị lớn hơn trong hai | Tài nguyên chi phối |
|---|---|---|---|---|
| ~0,20 μs | ~33,3 μs | ~33,3 μs | Bộ nhớ | |
| ~52 μs | ~37,4 μs | ~52 μs | Ma trận |
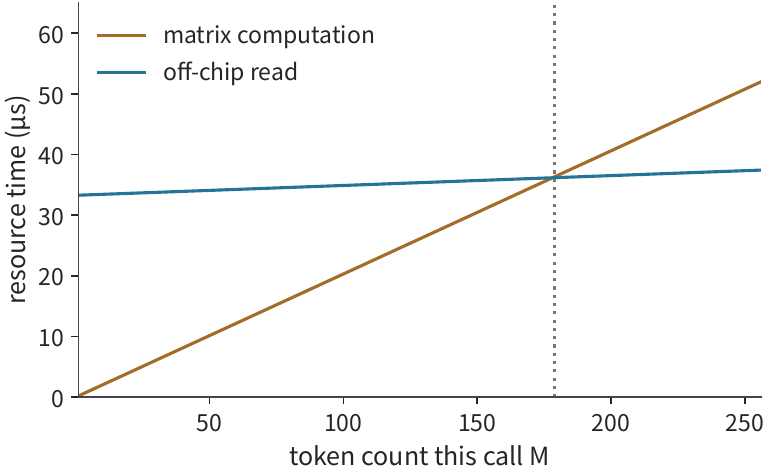
Bạn cũng có thể tìm số hàng đầu vào tại đó sự chuyển xảy ra. Gọi ; cường độ trong Mục 4.1 có thể viết là . Đặt biểu thức này bằng cho
Thay các giá trị tốc độ chưa làm tròn, FLOPs/byte, cho . Vậy tính từ số hàng nguyên 179 trở đi, thời gian tính toán ma trận vượt thời gian truyền dữ liệu. Điểm chuyển này biến “batch lớn hơn nghiêng về đơn vị ma trận” thành một ngưỡng số hàng tính toán được.
Thí nghiệm 4-5 · Cốt lõi: Kích thước batch dịch chuyển nút thắt hiệu suất qua các kiến trúc thế nào
Suy ra và vẽ đồ thị cường độ số học của phép chiếu Q từ 1 đến 256 hàng, rồi lần lượt nhân đôi thông lượng tính toán ma trận và băng thông bộ nhớ, và tìm số hàng đầu vào tại đó thời gian tính toán bằng thời gian đọc. Sau đó thêm các ma trận attention và expert vào bảng tài nguyên, và giải thích cách độ dài ngữ cảnh cùng phân bố số hàng đầu vào mỗi expert thay đổi thời gian xử lý của từng đơn vị và nút thắt nằm ở đâu. Chọn hai accelerator cụ thể, ước lượng thời gian thực thi cho cùng một tác vụ bằng tham số tài nguyên của mỗi cái, và so sánh các nút thắt.
Mục 4.8.2 mở rộng phương pháp này từ một phép chiếu đơn lẻ lên toàn bộ mô hình, tính riêng các phép đọc chi phối của decode và công việc ma trận của prefill, và kiểm tra thiết bị nào có thể chứa được trạng thái yêu cầu.
4.8.2 So sánh các accelerator ứng viên với cùng một mô hình
Bắt đầu với một ví dụ cố định, dễ tái tạo: Qwen3-8B, BF16, một yêu cầu, với 8.191 vị trí lịch sử có sẵn, trở thành 8.192 sau khi bước này thêm vào. Trọng lượng cư trú khoảng 16,381 GB, KV khoảng 1,208 GB, workspace lấy là 2 GiB, tổng ngân sách khoảng 19,737 GB. Tải giao diện trọng lượng-và-KV chi phối cho một bước decode là 16,345 GB. Token embedding chỉ đọc hàng tương ứng với token hiện tại, còn output head đọc toàn bộ ma trận trọng lượng, nên trọng lượng cư trú và lượng trọng lượng đọc mỗi bước khác nhau.
Giờ tính công việc ma trận. Qwen3-8B có 36 layer, độ rộng ẩn 4.096, độ rộng feedforward 12.288, 32 head query, 8 head KV, và chiều head 128. Số tham số ma trận mỗi layer cho các phép chiếu Q, K, V, O và ba phép chiếu feedforward là
Các phép toán tuyến tính mỗi token trên toàn bộ layer là GFLOP. Một bước decode 8K còn cần QK và PV là GFLOP, và output head khoảng 1,245 GFLOP, tổng cộng khoảng 19,97 GFLOP.
Giờ xét prefill: khi xử lý 4.096 token đầu vào mới, các phép toán tuyến tính tăng theo số token. Số cặp vị trí nhìn thấy được dưới attention nhân quả là ; mỗi cặp làm một tích trong QK và một tích lũy PV trên 32 head, tổng cộng phép toán mỗi cặp. Nhân với 36 layer, số phép toán QK/PV hiệu dụng là . Output head chỉ được tính cho vị trí cuối cùng, và công việc ma trận cho toàn bộ prefill khoảng 61,85 TFLOP. Thay hai giai đoạn này vào bảng tham số phần cứng cho Hình 4-36.
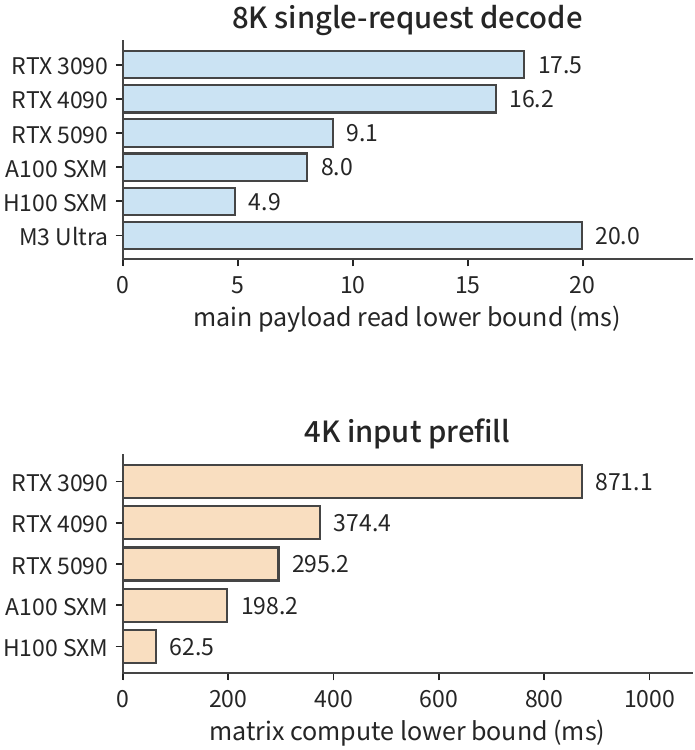
Những kết quả này ủng hộ vài kết luận trực tiếp. Từ 3090 lên 4090, cận dưới đọc của decode một yêu cầu chỉ rút ngắn khoảng 7,1%, trong khi thời gian ma trận của prefill 4K rút ngắn khoảng 57,0%. Từ A100 lên H100, thời gian đọc rút ngắn khoảng 39,1% và thời gian ma trận khoảng 68,5%; tiếp tục lên H200, thời gian đọc tiếp tục giảm trong khi thời gian ma trận về cơ bản không đổi. RTX 5090 và RTX PRO 6000 có cùng thời gian đọc, nhưng cái sau có thông lượng ma trận và dung lượng cao hơn. Với hỏi đáp tài liệu có đầu vào dài, lợi ích ma trận của 4090 và H100 rút ngắn prefill trước; với sinh một yêu cầu liên tục, lợi ích băng thông của 5090 và H200 trực tiếp rút ngắn thời gian đọc của mỗi bước.
Dung lượng thay đổi thiết bị nào khả thi ra sao? Ngân sách một yêu cầu Qwen3-8B BF16 khoảng 19,737 GB vừa khít các card 24 GB trong bảng; mở rộng lên tám yêu cầu 8K, tổng ngân sách khoảng 28,193 GB vượt 24 GB của 3090/4090, chuyển vào khoảng dung lượng 32 GB của 5090.
Chạy cục bộ, nên chọn giữa Qwen3-8B và Qwen3-235B-A22B thế nào? Trước tiên so sánh trường hợp sinh một yêu cầu. Qwen3-8B, dùng BF16 và ngữ cảnh 8K, vừa trên RTX 4090, 5090 và M3 Ultra. Đổi thời gian đọc mỗi bước trong bảng sang token mỗi giây cho cận trên dựa trên đọc khoảng , và token/s. Mô hình 8B đặc này không dùng tới dung lượng dư của Ultra, và băng thông cao hơn của 5090 chuyển trực tiếp thành ngân sách sinh cao hơn.
Giờ chuyển sang Qwen3-235B-A22B của Mục 4.6.3, dùng trọng lượng 4-bit, một yêu cầu, ngữ cảnh 8K. Mô hình này cần khoảng 126,867 GB cho mô hình, KV và workspace; 3090, 4090 và 5090 không thể chứa nó trên một card, nhưng M3 Ultra 256 GB và H200 141 GB có thể. Mỗi bước đọc khoảng 13,697 GB; M3 Ultra mất khoảng 16,72 ms và H200 khoảng 2,85 ms, tương ứng cận trên dựa trên đọc khoảng 59,8 và 350,4 token/s. Bộ nhớ lớn của Ultra cho phép mô hình MoE 235B này chạy trên một máy cục bộ, còn băng thông cao của H200 cắt thời gian đọc của cùng bước xuống còn khoảng một phần sáu.
Việc phân vùng tensor nhiều card và điều phối expert được trình bày trong Chương 6.
4.8.3 Vì sao dự đoán và đo lường phân kỳ
So sánh thiết bị của Mục 4.8.2 đã cho dung lượng và các ngân sách tài nguyên chi phối. Runtime library chọn kernel cụ thể cho các toán tử toán học, caching làm thay đổi lưu lượng ngoài chip, và việc nộp và đồng bộ cũng tiêu tốn thời gian. Mục đích của đo lường là nhận diện các bước thực thi này và hoàn thiện mô hình thời gian của Mục 4.8.1.
Trước tiên chuyển ngân sách đọc của Qwen3-8B thành một tác vụ sinh cụ thể, trên nền tảng đo lường của cuốn sách này, RTX PRO 6000 Blackwell Workstation. Vẫn dùng BF16, một yêu cầu, ngữ cảnh 8K, với tải mỗi bước 16,345 GB, ở đỉnh băng thông 1.792 GB/s phép đọc mất 9,12 ms, tương ứng khoảng 109,6 token/s; lấy 128 bước decode gần độ dài ngữ cảnh này, tổng cộng khoảng 1,17 s.
Thí nghiệm 8-1 của Chương 8 đã chạy đúng điều kiện này trên cùng card dùng vLLM: ngữ cảnh 8K, batch 1, với thời gian lặp decode thuần trung vị 25,83 ms qua ba lần chạy. Ba lần chạy lần lượt là 26,43, 16,18 và 25,83 ms, một lần rõ ràng nhanh hơn và hai lần còn lại chênh nhau dưới 3%; lấy trung vị tránh để một outlier đơn lẻ làm lệch phép so sánh. Tốc độ sinh khoảng 38,7 token/s, và 128 bước mất khoảng 3,31 s; cận dưới đọc chỉ chiếm 35,3% thời gian đo được, với thời gian đo vượt cận dưới khoảng 16,7 ms.
Phần thời gian thêm không đến từ tốc độ đọc: trong cùng thí nghiệm, ngữ cảnh 2K đọc ít hơn 0,906 GB KV mỗi bước, ở đỉnh băng thông lẽ ra tiết kiệm khoảng 0,51 ms, vậy mà lần chạy đo được là 26,26 ms — không ngắn hơn 25,83 ms của 8K. Khi batch tăng lên 64, lượng đọc mỗi bước của điều kiện 2K tăng lên 34,46 GB, với cận dưới đọc 19,23 ms, trong khi lần chạy đo được chỉ tăng lên 29,63 ms, băng thông hiệu dụng khoảng 1,16 TB/s, tức 65% đỉnh. Điều này cho thấy ở batch 1, thời gian mỗi bước bị chi phối bởi một khối công việc cố định không liên quan đến lượng đọc: thí nghiệm chạy ở chế độ eager, các kernel được phóng lần lượt từng cái một, cộng thêm các phép toán vector, lấy mẫu và đồng bộ. Trên chồng phần mềm/phần cứng này, cải thiện mức dùng băng thông gần như không tăng tốc được sinh một yêu cầu; để rút ngắn thời gian mỗi bước, trước tiên bạn phải giảm khối công việc cố định này — việc hợp nhất kernel và giảm số lần phóng được thảo luận trong Chương 5 nhắm đúng vào thời gian này. Khi kích thước batch tăng, công việc cố định được san đều trên nhiều token hơn, và phép đọc lại trở thành số hạng chi phối.
Theo định nghĩa trong Mục 1.2.2, 35,3% và 65% là MBU trong hai điều kiện này. Cả hai loại khoảng trống được nhắc trong Mục 1.3.4 đều hiện diện ở đây. Các bản ghi counter dưới đây sẽ cho thấy các yêu cầu đọc logic của mô hình không bằng lưu lượng DRAM — phần trúng cache không tiêu thụ băng thông bộ nhớ GPU — và sửa điều này thuộc về hạch toán mô hình; các khoảng trống do phóng kernel lần lượt từng cái, và do host nộp và đồng bộ, là chi phí triển khai có thể loại bỏ. Phải sửa hạch toán mô hình trước, rồi mới loại bỏ chi phí; không bước nào có thể bỏ qua.
Để phân rã phần thời gian thêm thành các bước cụ thể cần các bản ghi định thời, lưu lượng và kernel. Dưới đây, ta dùng các phép đo phép chiếu Q hiện có của cuốn sách này để cho thấy cách tìm nguồn gốc của khoảng trống thời gian từ các bản ghi này.
Thí nghiệm đi kèm chạy cùng phép chiếu trên M2 Max và RTX PRO 6000 Blackwell Workstation, với đầu vào, trọng lượng và đầu ra đều ở BF16. Để so sánh các mẫu truy cập trọng lượng khác nhau, 16 bản sao trọng lượng 32 MiB cùng nội dung, địa chỉ khác nhau được chuẩn bị trên mỗi nền tảng. Nhóm tái sử dụng luôn dùng cùng một địa chỉ; nhóm xoay vòng lần lượt quay vòng qua các địa chỉ khác nhau. Mỗi vòng thực hiện 16 lần gọi, ghi thời gian của cả vòng gồm cả nộp và đồng bộ của host, rồi chia cho 16 để lấy thời gian trung bình mỗi lần gọi của vòng đó. Tổng cộng chạy 11 vòng, và lấy trung vị của 11 giá trị trung bình này.
| Số token xử lý trong lượt này | M2 Max: tái sử dụng/xoay vòng | RTX PRO 6000: tái sử dụng/xoay vòng |
|---|---|---|
| ~166/183 μs | ~42,9/51,9 μs | |
| cả hai ~1,835 ms | ~32,6/33,5 μs |
Nhìn trước vào hàng đơn lẻ của RTX: xoay vòng chậm hơn tái sử dụng khoảng 21%. Một giải thích tự nhiên: dùng lặp lại cùng trọng lượng giữ chúng trong cache, giảm phép đọc DRAM. Giải thích này kiểm chứng được trực tiếp: nếu lượng đọc trọng lượng ít hơn là nguồn của khác biệt, thì khi trọng lượng được tái sử dụng, số byte đọc từ ngoài chip phải nhỏ hơn. Thí nghiệm ngoài ra còn dùng công cụ lập hồ sơ kernel GPU của NVIDIA, Nsight Compute, để truy cập trọng lượng theo cách quy định trước, rồi ghi một lần gọi đo lường, gom số lần truy cập trên toàn bộ kernel.
Dưới cả hai mẫu truy cập trọng lượng, lượng đọc DRAM hàng đơn đều khoảng 32 MiB, khớp chính xác kích thước một bản sao đầy đủ của trọng lượng. Cả hai điều kiện đọc cùng khối lượng trọng lượng ngoài chip, nên khác biệt thời gian hàng đơn cần được khoanh vùng thêm qua nộp, thực thi và chờ. Trường hợp 256 hàng khác: tái sử dụng cùng trọng lượng chỉ đọc 256 byte, còn xoay vòng qua các bản sao trọng lượng khác nhau đọc khoảng 32,1 MiB, vậy mà định thời thông thường khoảng 33 μs ở cả hai. Caching làm thay đổi lưu lượng ngoài chip, nhưng tổng thời gian gọi vẫn gồm các phép tính, truyền và chờ khác.
Phân cấp lưu trữ được phân biệt trong Mục 4.3 trở nên hiện hữu ở đây. Cả hai mẫu truy cập trọng lượng ở 256 hàng đều cho khoảng 147 MiB yêu cầu L2, lớn hơn nhiều so với lượng đọc DRAM gần như bằng không trong trường hợp đó. Trúng cache chỉ có nghĩa dữ liệu giờ được cấp ngay trên chip — các yêu cầu đọc của đơn vị tính toán và chuyển cục bộ vẫn diễn ra. Cùng các trọng lượng trong chương trình nguồn, một khi được cắt thành các khối để thực thi, sẽ được nhiều khối tính toán yêu cầu lặp lại.
Các yêu cầu trên chip giải thích vì sao truy cập dữ liệu vẫn còn sau khi phép đọc DRAM giảm. Giờ xét tính toán. Thư viện chia một phép chiếu thành nhiều bước hơn: lần gọi hàng đơn dùng một kernel GEMV, còn lần gọi 256 hàng dùng một GEMM cộng một phép khử split-K, hai kernel. Split-K phân phối tính toán dọc chiều tích trong trên nhiều khối tính toán, trước tiên tạo các đầu ra riêng phần, rồi hợp chúng bằng một phép khử. Điều này cho phép nhiều khối tính toán chạy song song hơn, nhưng cũng đòi hỏi lưu và đọc các kết quả riêng phần, tiếp theo là một phép khử cuối. Kết quả là, cái mà Mục 4.1 coi là một phép nhân ma trận đơn lẻ được mở rộng ở đây thành nhiều giai đoạn.
Giờ ước lượng, dùng các tham số của RTX PRO 6000, thời gian thực thi khi cả đầu vào và trọng lượng được đọc từ ngoài chip: với đầu vào BF16 và tích lũy FP32, đỉnh phép toán ma trận đặc khoảng 504 TFLOP/s, băng thông 1,792 TB/s, và cận dưới cho hai số hàng khoảng 18,7 và 21,1 μs. Mô hình cho thời gian cần cho tính toán ma trận và phép đọc ngoài chip, các counter hé lộ lưu lượng ở từng mức giao diện khi có caching, và đường kernel giải thích phần việc hợp dư; tổng thời gian vẫn gồm nộp, đồng bộ và các khoảng trống thực thi.
Để khoanh vùng khoảng trống thêm nữa, bạn có thể tách “bận bao lâu” khỏi “chạy nhanh thế nào khi làm việc”. Gọi là thời gian một đơn vị phần cứng cần để hoàn tất toàn bộ phép toán ở tốc độ lý tưởng, thời gian thực tế nó ở trạng thái làm việc, và tổng thời gian của tác vụ; khi đó
Số hạng thứ nhất biểu thị tỷ số giữa tốc độ thực tế và tốc độ lý tưởng trong lúc làm việc; số hạng thứ hai biểu thị tỷ phần tổng thời gian dành cho làm việc. Giả sử hai tác vụ mỗi cái mất 100 μs, với thời gian tính toán lý tưởng 40 μs trong cả hai trường hợp. Khi thực thi tác vụ thứ nhất, đơn vị chỉ làm việc 40 μs, đạt tốc độ lý tưởng trong lúc làm việc, nhưng dành 60 μs còn lại để chờ; khi thực thi tác vụ thứ hai, đơn vị làm việc 80 μs, chỉ ở nửa tốc độ lý tưởng, với chỉ 20 μs chờ. Cả hai có cùng tỷ số tổng 40%, vậy mà hướng tối ưu khác nhau.
Tác vụ thứ nhất đòi hỏi nhiều hơn ở việc chuẩn bị dữ liệu trước, bố trí nhiều phép tính độc lập lẫn nhau hơn, hoặc giảm thời gian chờ kết quả của bước trước — giống với thay đổi từ hai slot sang ba slot trong Mục 4.4; tác vụ thứ hai đòi hỏi nhiều hơn ở việc cải thiện độ chi tiết thực thi, lệnh và truy cập cục bộ — giống với phân tích lãng phí đệm và gom nhóm lời gọi trong Mục 4.2.
Thí nghiệm 4-6 · Mở rộng: Dùng các phép đo trên Mac và RTX để kiểm tra dự đoán thời gian thực thi
Dựa trên tổng thời gian phép chiếu đo được trên hai nền tảng, đề xuất hai nguyên nhân khả dĩ của khác biệt thời gian, rồi dùng các bản ghi DRAM, L2 và kernel để liệt kê, với mỗi nguyên nhân, các quan sát kỳ vọng và thực tế. Sau đó vẽ sơ đồ các đường ma trận, kết quả riêng phần và khử cho lần gọi 256 hàng, và xác định những định thời cấp giai đoạn nào cần để tách hiệu quả thực thi của đơn vị tính toán trong lúc làm việc khỏi thời gian chờ của nó. So sánh kết quả với một mô hình giả định cả đầu vào và trọng lượng được đọc hoàn toàn từ ngoài chip.
4.8.4 Lựa chọn giữa dung lượng, tốc độ, điện năng và chi phí
Mục 4.8.3 thu được thời gian hoàn thành tác vụ; mục này chuyển nó thành chi phí và năng lượng tiêu thụ. Trước tiên so sánh các chương trình trả theo thời gian sử dụng, rồi gộp vào thời gian rảnh và khoản đầu tư cố định của các kiến trúc chuyên biệt.
Gọi là chi phí mỗi giờ của hai máy, và thời gian chạy để hoàn tất cùng một tác vụ. Khi tính tiền theo thời gian chạy, chi phí mỗi tác vụ tỷ lệ với , nên
Vế phải cho biết chi phí mỗi giờ có thể chênh nhau bao nhiêu: nếu A nhanh gấp đôi B, A vẫn rẻ hơn mỗi tác vụ chừng nào chi phí mỗi giờ của A nhỏ hơn gấp đôi B. Thay chi phí mỗi giờ bằng công suất trung bình, bất đẳng thức tương tự so sánh năng lượng tiêu thụ mỗi tác vụ. Trong nhóm tái sử dụng của Mục 4.8.3, tỷ lệ thời gian Mac/RTX khoảng 3,9 (hàng đơn) và 56 (256 hàng). Chỉ tính card đồ họa ở phía RTX, và dùng trần điện năng 600 W của RTX PRO 6000 Workstation, một lần gọi hàng đơn tiêu thụ nhiều nhất khoảng 25,8 mJ, và một lần gọi 256 hàng khoảng 19,6 mJ. Thông số chính thức của Apple không cho công suất toàn máy của M2 Max; suy ngược từ bất đẳng thức trên, công suất trung bình của Mac trong một lần gọi hàng đơn cần nằm dưới khoảng 155 W để nó tiêu thụ ít năng lượng hơn RTX mỗi lần gọi, và dưới khoảng 10,7 W cho trường hợp 256 hàng. Với máy không đổi và chỉ kích thước ma trận thay đổi, công suất Mac được phép tiêu thụ khi vẫn giữ lợi thế năng lượng giảm từ khoảng 155 W xuống khoảng 10,7 W.
Các dịch vụ chạy dài cũng phải tính chi phí của các khoảng rảnh. Giả sử một máy xử lý yêu cầu sinh ra token hiệu dụng mỗi giây, và tỷ phần mỗi giờ dành cho xử lý yêu cầu là ; khi đó sản lượng mỗi giờ là , và chi phí mỗi token là . Nếu tốc độ sinh gấp đôi trong khi mức sử dụng giảm nửa, sản lượng mỗi giờ không đổi, và chi phí đơn vị cũng không đổi.
Năng lượng tiêu thụ cũng được quyết định chung bởi công suất và thời gian. Lấy decode một yêu cầu 8K của Mục 4.8.2 làm ví dụ: giả sử cả hai card chạy ở trần điện năng, với thời gian mỗi bước bằng cận dưới đọc. RTX 4090 tiêu thụ 450 W trong 16,22 ms, khoảng 7,30 J mỗi bước; RTX 5090 tiêu thụ 575 W trong 9,12 ms, khoảng 5,24 J mỗi bước. Công suất tăng khoảng 28%, vậy mà năng lượng mỗi bước thực tế giảm khoảng 28%. Dạng tổng quát là
Với các dịch vụ chạy dài, cộng tổng năng lượng tiêu thụ trong một khoảng và chia cho sản lượng hiệu dụng của khoảng đó sẽ tính cả công suất tiêu thụ trong các giai đoạn rảnh và khởi động. Rút ngắn thời gian chạy giảm năng lượng tiêu thụ trong lúc thực thi tác vụ, còn nâng mức sử dụng giảm phần công suất rảnh được san đều trên mỗi tác vụ. Hạch toán năng lượng của Mục 4.1.3 đã cho ước lượng bậc độ lớn cho năng lượng một bước decode: với một yêu cầu ngữ cảnh 8K, 0,534 J mỗi token, trong đó 0,481 J cho việc đọc trọng lượng; ở batch 32, năng lượng mỗi token giảm xuống khoảng 0,068 J. Hạch toán này loại trừ điện năng điều khiển, clock, rò tĩnh và công suất giai đoạn rảnh, nên chia tổng năng lượng tiêu thụ cho sản lượng hiệu dụng sẽ cho con số năng lượng mỗi token cao hơn ước lượng này.
Chuyên biệt hóa mang theo một khoản đầu tư cố định riêng. Gọi là chi phí cố định thêm vào so với một phương án đa năng, và khoản tiết kiệm chi phí biến đổi mỗi đơn vị sản lượng hiệu dụng; khối lượng hòa vốn là
Các mô hình được cập nhật hoặc thay thế, nên một hệ thống chuyên biệt chỉ có một cửa sổ dùng hữu hạn cho mô hình đó. Giả sử có máy, mỗi máy xử lý yêu cầu ở tốc độ sinh và mức sử dụng , và tuổi thọ dùng được của mô hình là ; tổng sản lượng là . Chỉ khi khoản tiết kiệm chi phí chạy trong khoảng này đạt tới khoản đầu tư cố định, phương án chuyên biệt mới hòa vốn.
Ví dụ 4-3: Chuyên biệt hóa có hòa vốn trong vòng đời của mô hình không?
Chi phí cố định tăng thêm là 20 triệu, tiết kiệm 0,50 mỗi triệu token đầu ra đạt chuẩn. Triển khai 100 máy, mỗi máy xử lý yêu cầu ở 10.000 token/s, với mức sử dụng 50%, và vòng đời kinh tế một năm của mô hình, tính theo 365 ngày một năm.
So sánh khối lượng sản lượng cần thiết để hòa vốn với mức sản lượng đạt được trong một năm. Khối lượng hòa vốn là token, tức 40 nghìn tỷ. Sản lượng một năm là token, tức khoảng 15,8 nghìn tỷ.
Quy mô dịch vụ thực tế nào cần thiết để hòa vốn trong một năm? Sản lượng một năm khoảng 39% khối lượng hòa vốn. Với tốc độ mỗi máy và mức sử dụng giữ cố định, ít nhất 254 máy phải chạy trong một năm.
Quy mô hòa vốn sau khi giảm nửa vòng đời mô hình hoặc hạ mức sử dụng. Nếu mô hình được thay sáu tháng một lần, thời gian dùng được của mỗi máy giảm nửa, đòi hỏi ít nhất 508 máy để duy trì mức sử dụng đã cho; kết quả giống hệt nếu mức sử dụng giảm từ 50% xuống 25%.
Ví dụ này tiết kiệm khoảng 7,88 triệu mỗi năm, dưới khoản đầu tư cố định 20 triệu; đạt khối lượng hòa vốn 40 nghìn tỷ token mất khoảng 2,54 năm, vượt vòng đời một năm của mô hình nêu trong giả định.
Thí nghiệm 4-7 · Mở rộng: Một thay đổi tài nguyên chip còn đáng giá sau khi tải công việc thay đổi không?
Chọn một kiến trúc và một tải công việc đại diện, và đề xuất một thay đổi tài nguyên. Trước tiên suy ra thay đổi thời gian từ tải công việc, lưu lượng và các phụ thuộc, rồi tính dung lượng thêm và chờ giảm. Sau đó biến đổi kích thước batch hoặc độ dài ngữ cảnh, và tìm giá trị tới hạn tại đó thay đổi ban đầu không còn tiết kiệm thời gian. Nếu phương án đòi hỏi đầu tư cố định thêm, thì tính từ chi phí tiết kiệm mỗi tác vụ, mức sử dụng accelerator và vòng đời mô hình, khối lượng dịch vụ tối thiểu cần để thu hồi khoản đầu tư cố định.
Thí nghiệm 4-8 · Mở rộng: Từ hạch toán năng lượng đến giới hạn điện năng
Dùng bảng năng lượng của Mục 4.1.3 và số byte đọc mỗi bước của decode một yêu cầu 8K Qwen3-8B. (a) Lấy lần lượt kích thước batch 8, 32 và 128, tính năng lượng mỗi token của trọng lượng, KV và tính toán cho từng cái, và tìm kích thước batch tối thiểu tại đó số hạng trọng lượng giảm xuống dưới số hạng tính toán. (b) Đổi ngữ cảnh sang 32K, tìm kích thước batch tại đó số hạng KV bằng số hạng trọng lượng, và giải thích vì sao tăng thêm kích thước batch sau điểm này không còn hạ năng lượng mỗi token đáng kể. (c) Chọn TDP, đỉnh tính toán và băng thông HBM của một card, và tính ngân sách năng lượng mỗi FLOP ở tốc độ đỉnh; giả sử năng lượng thực tế mỗi FLOP là , và dùng , tính tỷ số tần số duy trì được trong cả trường hợp điện áp cố định lẫn trường hợp điện áp giảm theo tần số; rồi chia năng lượng một bước ở batch 32 tính trong (a) (32 lần năng lượng mỗi token) cho thời gian bước ở tần số duy trì để có công suất trung bình, và so sánh với TDP.
Chú thích nguồn
-
Cấu hình cố định, lập chỉ mục tensor và triển khai mô hình của Qwen3-8B được cho trong cấu hình mô hình và kết quả tính toán phép chiếu.
-
Jouppi và cộng sự, In-Datacenter Performance Analysis of a Tensor Processing Unit, ISCA 2017, bài báo lưu trữ.
-
Whitepaper kiến trúc A100, whitepaper kiến trúc H100, Hopper Tuning Guide, technical brief Blackwell, và các tính năng CUTLASS Blackwell.
-
Whitepaper kiến trúc chính thức Ascend 950, §4.1—4.1.6; việc định vị cấp trang của kiến trúc tách rời DaVinci và CANN trước đó nằm trong ghi chú so sánh.
-
Từ mức sử dụng toán tử đến chờ đợi trong lúc thực thi và ghi chú đọc bài báo.
-
Thông số chính thức M2 Pro/Max, mô tả kiến trúc GPU Apple, các chế độ lưu trữ Metal, mô tả chính thức Neural Accelerator GPU M5.
-
FlashAttention-4, MLSys 2026, bài báo, §2.2, §3.1.1, Phương trình 1–3 và Bảng 1; tính toán lại độc lập trên một SM.
-
Kiểm toán độ chính xác phần cứng, điều kiện tài nguyên từng giai đoạn của DeepSeek V4-Flash và Qwen, nghiên cứu độ chính xác thấp và đường thực thi. Về tiến hóa phần cứng và phân bổ chi phí, xem nghiên cứu giảm chi phí.
-
Thí nghiệm 4-2, kích hoạt định tuyến thực tế, gom nhóm 128 phần tử, thay thế trong-mô hình chuyên biệt một expert.
-
Mess, MICRO 2024, bản thảo tác giả được chấp nhận, các trang vật lý chọn lọc 3–6; ví dụ và ràng buộc về độ đồng thời băng thông bộ nhớ.
-
Kết quả tọa độ di chuyển expert dùng chung của DeepSeek V4-Flash và ghi chú đếm cấp nguồn.
-
Hopper Tuning Guide, whitepaper Ascend 950, mô tả kiến trúc chính thức Rubin.
-
Đường cơ sở pipeline đầu vào attention của Qwen, nhân đôi tốc độ ma trận, lập mô hình và kiểm tra độc lập.
-
Ghi chú bàn giao ma trận–vector, đường trực tiếp hai slot 32 hàng.
-
Technical brief Blackwell, NV-HBI 10 TB/s; CloudMatrix384 v2, §3.3.1 (910C, 64 GB mỗi die, 1,6 TB/s, 270 GB/s mỗi hướng giữa các die), đầu §4.2 (một expert mỗi die trong lúc decode) và §4.2.2; các phép tính cục bộ die cho hai sản phẩm nằm trong mục
die_localitycủa script suy dẫn giảng dạy; nền tảng Vera Rubin, đối chiếu chéo UB và Ascend. -
Inside the Eighth-Generation TPU: An Architecture Deep Dive.
-
Bài báo Groq TSP, Mô hình lập trình IPU, datasheet Cerebras WSE-3, bài báo SambaNova SN40L.
-
Ghi chú lập mô hình về cận dưới độ trễ từng giai đoạn; về dải toán tử thực tế của một mô hình thật, xem kết quả tài nguyên prefill128 của Qwen3-8B.
-
Nguồn phần cứng và kiểm toán độ chính xác cùng bảng đường cơ sở chính thức.
-
Thí nghiệm 4-6, ghi chú đầy đủ và bản ghi thô, tóm tắt định thời phép chiếu, số lần DRAM/L2 thực tế.
-
Điều kiện chi phí phép chiếu ghép cặp và công suất trung bình; 600 W của RTX PRO 6000 lấy từ bảng đầu vào phần cứng, và năng lượng mỗi lần gọi ở mức ngang công suất Mac được tính bởi mục
energycủa script suy dẫn giảng dạy; xem dữ liệu suy dẫn. -
Về thuật ngữ host, DMA và định địa chỉ hợp nhất, xem CUDA Programming Guide.
-
Whitepaper kiến trúc RTX Blackwell, Phụ lục A, Bảng 3: RTX 4090 có 24 GB GDDR6X, 1.008 GB/s, PCIe Gen 4 và TGP 450 W; RTX 5090 có 32 GB GDDR7, 1.792 GB/s, PCIe Gen 5 và TGP 575 W; datasheet A100 80GB, PCIe 4.0 ở 64 GB/s (tổng hai chiều). Thời gian đọc H2D và GPU-memory nằm trong mục
host_linkcủa script suy dẫn giảng dạy. -
RTX 4090, 128 giao dịch đang chạy, RTX 4090, 4.096, RTX 5090, 4.096, RTX 5090, độ trễ 800 ns; về độ trễ H100, xem Bảng I và Hình 3(h) của Mess.
-
Thí nghiệm 7-3, xác minh bản ghi chạy công khai, log thô từ hai node HGX H100: 16 rank, NCCL 2.26.2, AllReduce 16 byte out-of-place 24,96 μs, in-place 24,93 μs.
-
Quét batch của Thí nghiệm 8-1 và tóm tắt hiệu quả từng hàng: RTX PRO 6000 Blackwell Workstation, Qwen3-8B BF16, vLLM 0.23.0, chế độ eager; mỗi hàng lấy trung vị của vòng lặp decode thuần mỗi vòng, rồi trung vị qua ba vòng. Tỷ số với cận dưới đọc được tính bởi mục
measured_decodecủa script suy dẫn giảng dạy. -
Pipeline ba slot, biến thể nhân đôi tính toán và điểm ngoặt thiết kế được sinh bởi script suy dẫn giảng dạy; dòng thời gian đầy đủ nằm trong dữ liệu suy dẫn.
-
Báo cáo kỹ thuật DeepSeek V3, §3.5, Suggestions on Hardware Design.
-
Tính lại từng mục cho các so sánh điều kiện của chương này, và chương trình tính toán.
-
Báo cáo kỹ thuật chính thức DeepSeek V4.1, §1, 2, 3 và 6; điều kiện cố định và tính lại xuyên chương cho phiên đang chạy này.
-
Whitepaper kiến trúc chính thức Turing, Turing Tensor Cores và suy luận độ chính xác thấp.
-
Whitepaper kiến trúc Volta, chương Tensor Cores và độ chính xác hỗn hợp.
-
Blackwell Tuning Guide, ghi chú tính năng CUTLASS Blackwell, và ví dụ TMEM SM100; cache dữ liệu L1 128 KB và trần shared-memory 100 KB mỗi SM trên SM120 (compute capability 12.0) nằm trong bảng compute-capability của CUDA Programming Guide.
-
Mô tả kiến trúc GPU NVIDIA Rubin, di chuyển dữ liệu MoE, thông lượng lệnh chiều K và tăng tốc attention.
-
Giới thiệu kiến trúc chính thức Apple M3, ghi chú phát hành chính thức M4, và thông số Mac mini M4.
-
Bài báo kiến trúc DaVinci, §3.1–3.4; Ascend C Guide, Chương 4 về kiến trúc ghép cặp so với tách rời; CloudMatrix384 v2, §3.3.1, §4.2.2.
-
Chương trình và ghi chú tính toán định lượng cho tiến hóa kiến trúc, kết quả tính từng mục. Các tham số lấy từ bảng đầu vào phần cứng; 3090 được bổ sung từ Bảng 9 của whitepaper GA102 chính thức; các cấu hình mô hình đầy đủ và kiểm kê tensor theo các tính toán của cuốn sách này.
-
Whitepaper kiến trúc A100, chương về BF16 và định dạng số; tính lại dải số, lưu trữ và lượng tử hóa.
-
Bài “Where Should Network Intelligence Live” của tác giả, một hồi tưởng về bối cảnh thiết kế ResNet năm 2016 từ một bài nói năm 2023; bài báo kiến trúc DaVinci §3.2, §3.4, Bảng 5 và hệ thống Ascend 910 lần lượt cho img2col, tỷ lệ tài nguyên, băng thông mỗi nhân và HBM 1,2 TB/s.
-
Thông số sản phẩm RTX PRO 6000, ECC, MIG và cấu hình sản phẩm; Hopper Tuning Guide, NVLink; whitepaper GA102, NVLink 3090; Blackwell Tuning Guide và các tính năng CUTLASS Blackwell, SM100/SM120.
-
Đối chiếu chéo cấu hình chính thức Apple, các tổ hợp GPU và dung lượng, và bảng phần cứng. 512 GB của M3 Ultra được xác nhận chéo bởi ghi chú phát hành chính thức và các cấu hình kiểm thử toàn hệ thống GPU 80 lõi được ghi lại. 512 GB/1.200 GB/s của M5 Ultra là thông số công bố tháng 8/2026; cấu hình 512 GB dự kiến lên kệ cuối tháng 10/2026.
-
He Tingbo, Chip τ của Huawei lẽ ra đã phải tan chảy?, ChinaXiv:202609.00031v1, 2026-09-04, bài báo lưu trữ, §II–V và Hình 1–2: phần công suất động, điện dung dây dẫn, so sánh NPU ở hiệu năng bằng nhau (29 TOPS, 0,85→0,55 V, tần số giảm 63%, điện năng giảm 66%), công suất DSP giảm 25%, và diện tích dự kiến giảm 40%.
-
Dally, Hardware for Deep Learning, keynote Hot Chips 2023, trang 12, 51–52: trang 12 cho HFMA ở 1,5 pJ, HMMA ở 110 pJ, chi phí lệnh khoảng 30 pJ, và phần chi phí 2000%/22% (45 nm); bảng năng lượng trang 51 ghi chú được lấy từ Horowitz, ISSCC 2014, ở tiến trình 45 nm; trang 52 cho các con số ba cấp bộ nhớ 5/50/640 pJ mỗi từ 32-bit, không ghi nút tiến trình; Fine-Grained DRAM, MICRO 2017, §1–2, HBM2 ở 3,97 pJ/bit kèm phân tích chi tiết, năng lượng DRAM được mô hình ở 28 nm; NVIDIA Grace Hopper Superchip Architecture In-Depth, 2022-11-10, NVLink-C2C ở 1,3 pJ/bit.
-
Kết quả sổ cái năng lượng, đọc từ số byte và FLOP của kết quả decode một yêu cầu 8K, cộng dồn bằng các con số năng lượng mỗi byte và mỗi FLOP trong bảng trên; chạy
python3 calculations/calc.py energy-ledger --format mdđể tính lại. -
Whitepaper kiến trúc H100, Bảng 4: năm chồng HBM3, giao diện 5120-bit, 2619 MHz DDR, 3352 GB/s (văn bản chính của chương này dùng 3,35 TB/s đã làm tròn, tức 3.350 GB/s, từ datasheet), 814 mm², tiến trình TSMC 4N, với A100 ở 826 mm²; technical brief Blackwell, trang 7, hai die giới hạn reticle và NV-HBI 10 TB/s, Bảng 3 với B200 ở 192 GB/7,7 TB/s; mô tả thành phần nền tảng HGX, Bảng 1, HGX B200 ở 180 GB mỗi GPU và tới 8 TB/s; datasheet H200, 141 GB/4,8 TB/s; trang sản phẩm Micron HBM3E, 1024 chân, tám lớp 24 GB, mười hai lớp 36 GB; trang sản phẩm SK hynix HBM, 9,6 Gbit/s và 1,23 TB/s.
-
Datasheet H100, công suất thiết kế nhiệt tối đa SXM 700 W; whitepaper kiến trúc H100, Bảng 4, dense BF16 989,4 TFLOPS với TDP 700 W; technical brief Blackwell, Bảng 3, B200 ở 1000 W.
Tóm tắt chương
Phân tích accelerator bắt đầu từ tải công việc của mô hình: kích thước trạng thái lọc ra dung lượng, lưu lượng và băng thông tính ra thời gian đọc, hình dạng ma trận, độ chính xác và tốc độ lệnh tính ra thời gian tính toán, và việc thực thi sau đó được lập lịch theo các phụ thuộc. Sự tiến hóa của ba kiến trúc cho thấy các đòi hỏi của mô hình tái định hình tỷ lệ tài nguyên. Số lần truy cập, bản ghi kernel và định thời chuyển những ngân sách này thành tốc độ runtime và chi phí tác vụ. Thời gian và năng lượng là hai sổ cái tách biệt: băng thông quyết định một bước chạy nhanh thế nào, năng lượng mỗi byte và số lần tái sử dụng quyết định một bước tiêu thụ bao nhiêu joule, và trần điện năng đến lượt nó lại kìm tần số duy trì được. Chương 5 tiếp tục bằng việc xem xét bố cục, hợp nhất và lập lịch, cho thấy phần mềm tận dụng tốt các tài nguyên phần cứng này như thế nào.